dsh-tab-complete
dingchenhui0618-arch/dsh-tab-complete
The composer predicts what you are about to type. Inline ghost text sits on the caret, measured against the editor's own font and line box, and Tab turns it into real text (Esc ignores it). The prediction is one short call through the session's own model router, seeded with your draft and the last few turns of the conversation, so an empty composer also gets a next-prompt guess written in the user's voice; suggestions that merely restate the assistant are dropped. Host side is one HTTP route with sub-path endpoints (loopback-only, 64 KB body cap, 2-minute result cache, 20-second miss cache, one in-flight call per session); client side is one 0-height overlay registered on conversation.input.overlay, with insertion guarded by the composer's draftRev CAS and a setDraft fallback. IME composition and slash commands are skipped. 16 node:test cases, zero runtime dependencies, real screenshots in docs/.
Install
dsh plugin --profile web add github:dingchenhui0618-arch/dsh-tab-completeREADME
dsh-tab-complete


在 DeepSeek Harness 的输入框里,用当前对话和你已经打的字,预测你接下来要输入的内容:灰色幽灵文本贴在光标后面,按 Tab 一键填入,按 Esc 忽略。
这是 Codex Pro「下一步输入预测」的 DeepSeek Harness 版本。区别只有一处:预测走你自己的模型路由,不吃订阅额度。
用着还行的话,点个 ⭐ 就够了——插件市场的「搜插件」按 GitHub star 排序,star 是这个插件能被人翻到的唯一杠杆。
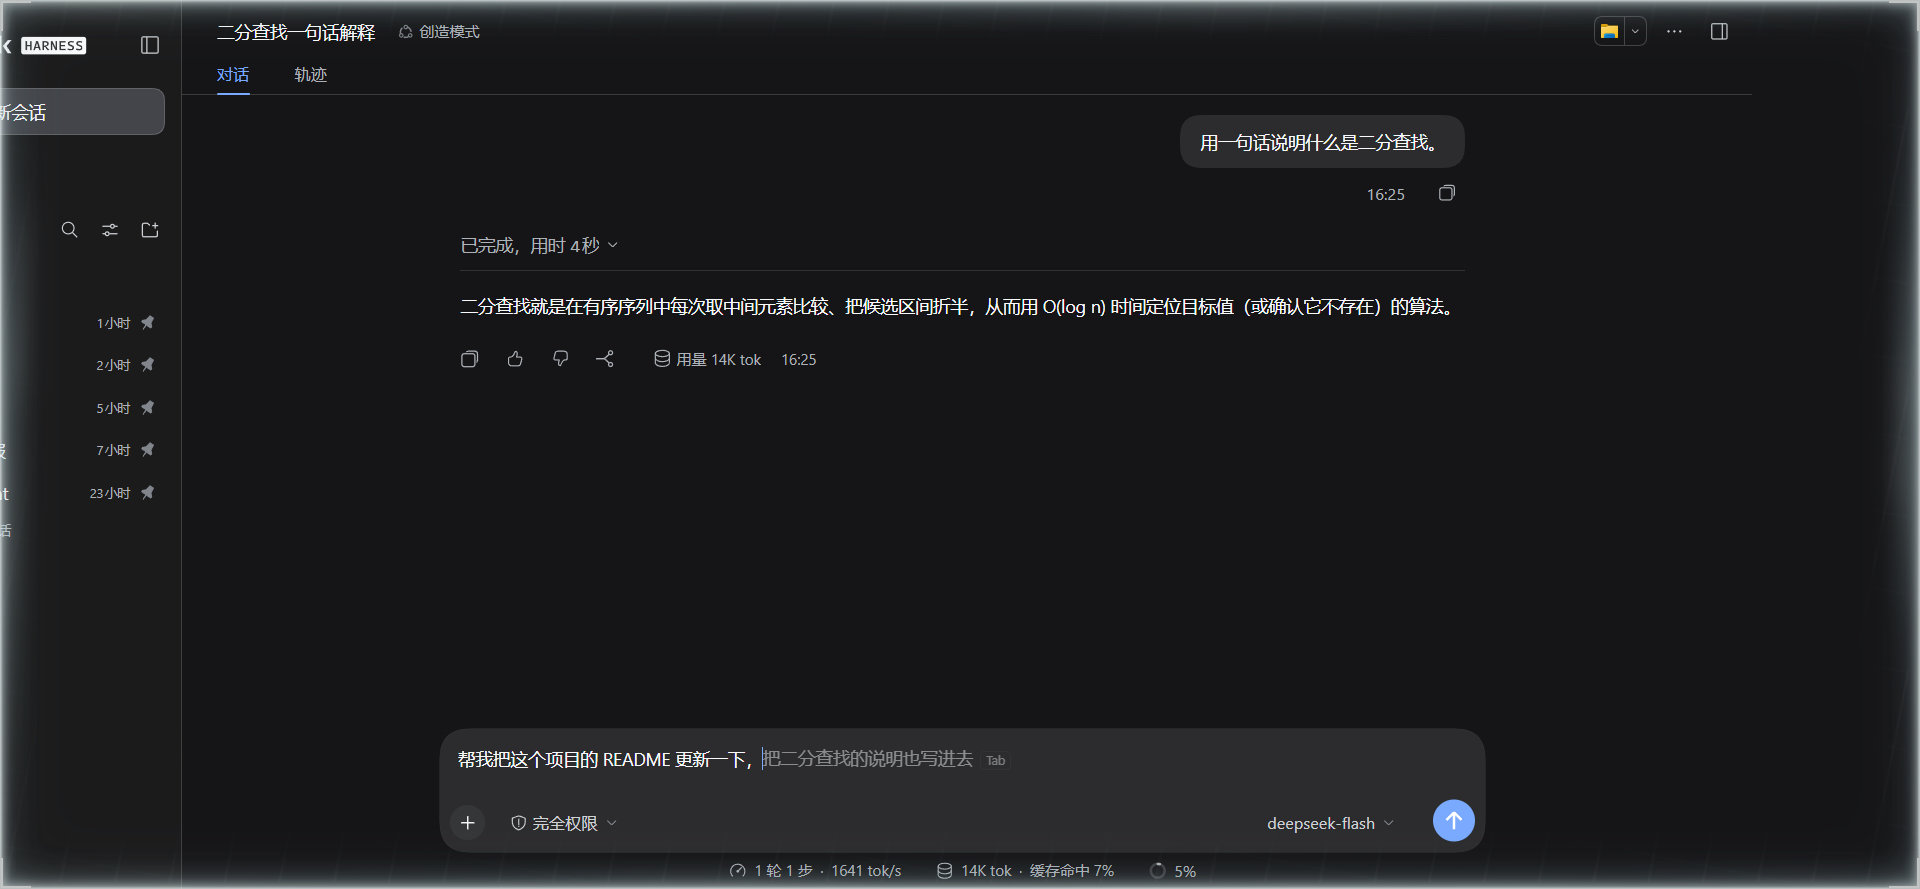
它什么时候会给建议
| 时机 | 行为 |
|---|---|
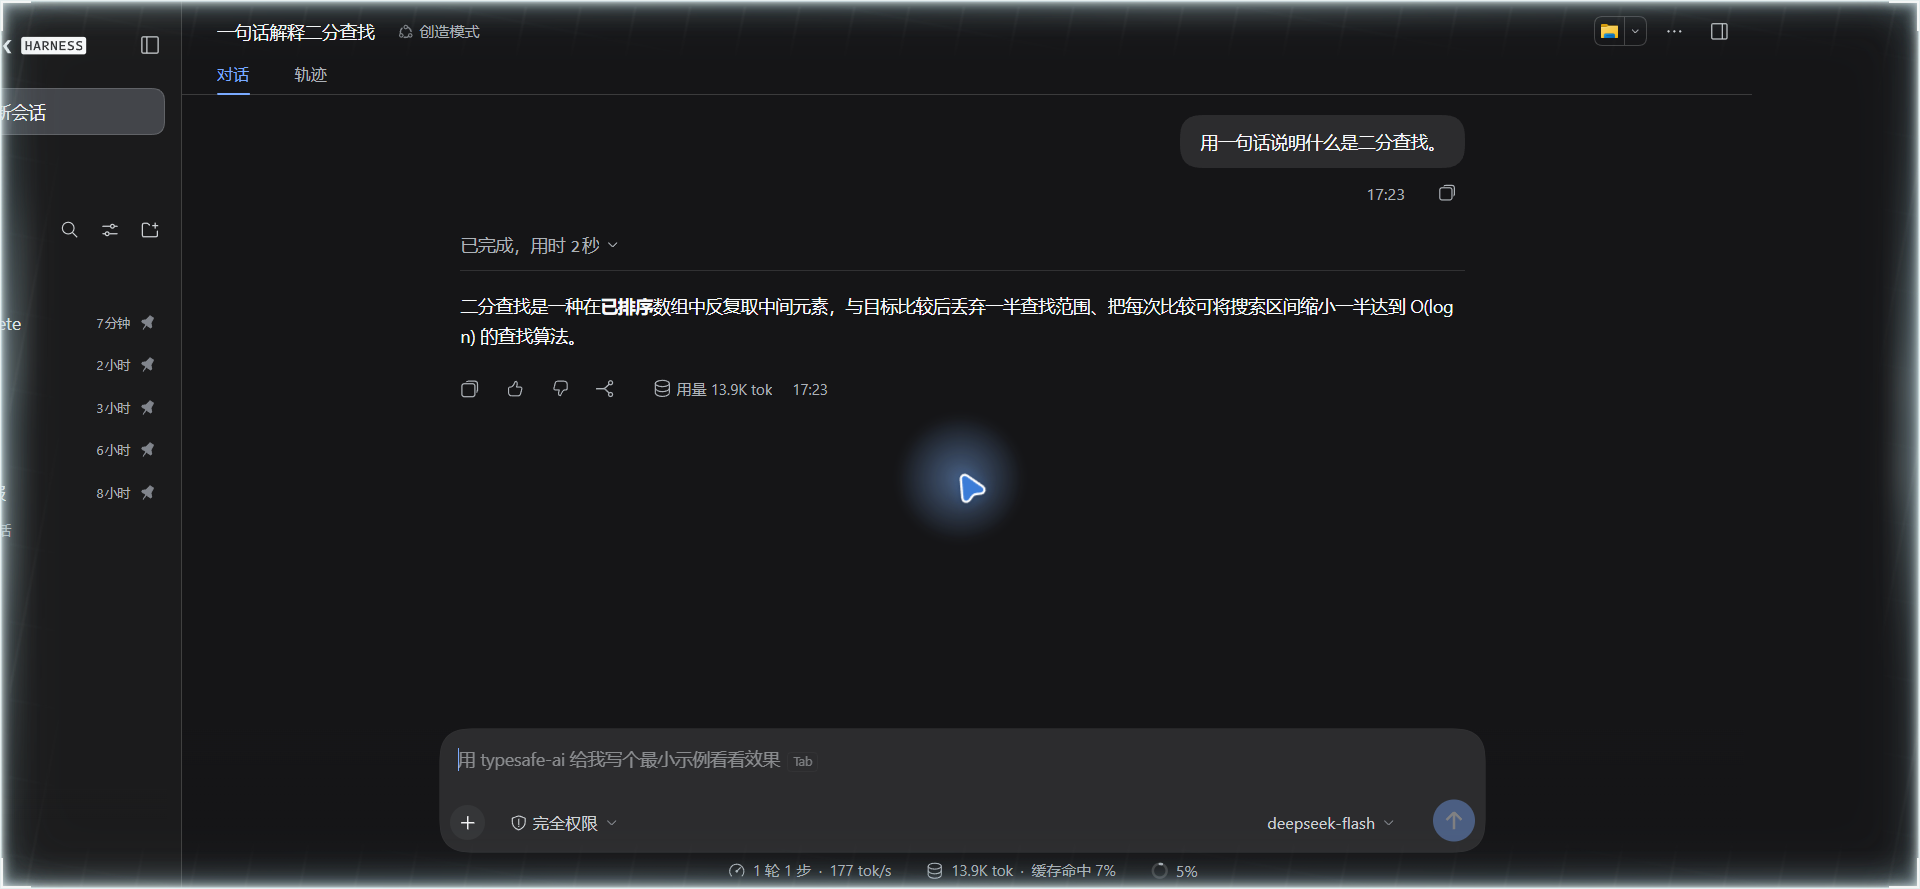
| 你在输入框里打字 | 停手约 0.28 秒后,把这句话补完 |
| 你刚发完一条消息、输入框是空的 | 基于这段对话,预测你的下一句(用户口吻,不是助手口吻) |
| 候选是助手刚说过的话的复述 | 直接丢弃,不显示 |
| 候选是「先查日志,再跑测试」这类执行步骤 | 直接丢弃——那是助手该干的事,不是你会说的话 |
| 你在用输入法(IME)拼字 | 不预测,避免和候选栏打架 |
输入框以 / 开头 | 不预测,那是命令面板 |
给的是整句而不是半句:一次 Tab 就能直接发出去,不需要你接着往下想。对话里的文件、函数、版本号会被沿用;模型编不存在的路径(src/plugins、index.ts 这种)会被提示词按住。
只把「你和助手说过的话」喂给模型——技能目录、运行时上下文这类框架注入会被 isScaffolding() 挡掉。这很关键:它们一旦混进去就会吃光上下文预算,让预测变成对着技能列表瞎猜。
它会越用越像你。 每次你按 Tab 收下建议,那句话就被记进 ~/.dsh/tab-complete-style.json(最多 40 条,只在本机),之后作为「他以前收下过的写法」参与提示词。看不顺眼可以清空:
curl.exe "http://127.0.0.1:3080/dsh-tab-complete/style"                       # 看记了什么
curl.exe -X POST "http://127.0.0.1:3080/dsh-tab-complete/style" -d '{"clear":true}'   # 清空
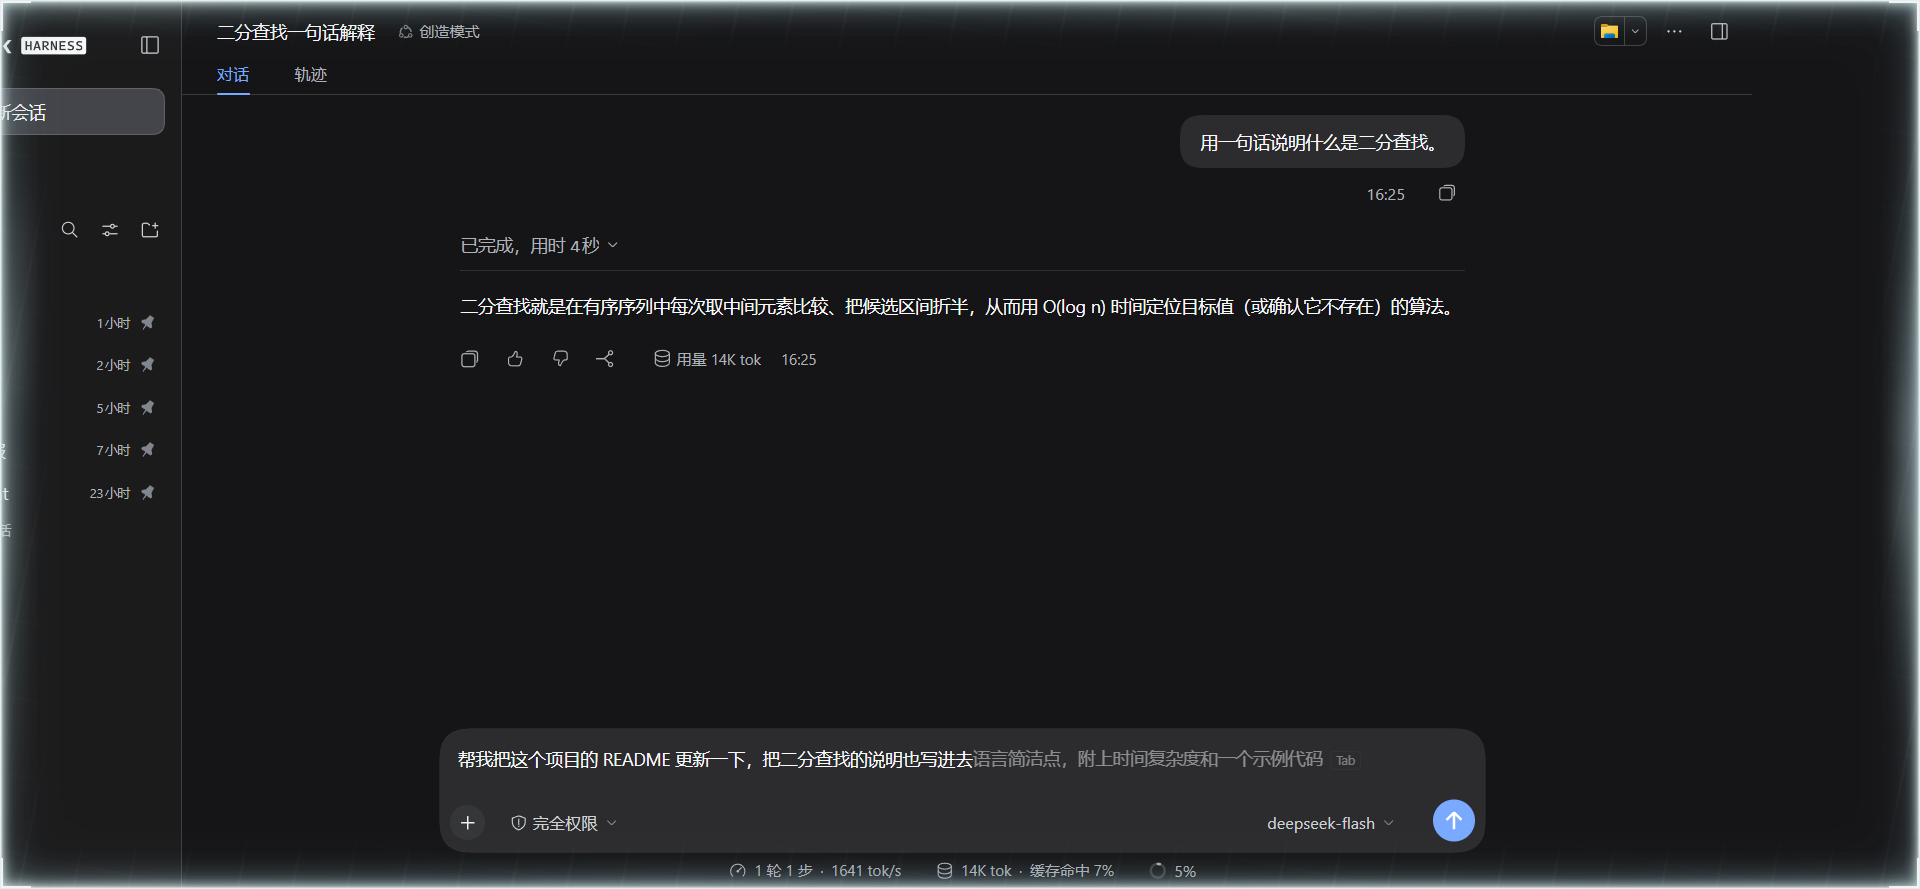
按 Tab 之后:幽灵文本变成真正的文字,光标停在末尾,接着就能改。
安装
插件是标准的 DSH bundle:宿主半边注册一条 HTTP 路由,客户端半边挂在 conversation.input.overlay 插槽上。
在 profile 目录(~/.dsh/profiles/<profile>/)里加两处:
// package.json
{
  "dependencies": {
    "dsh-tab-complete": "link:D:/Projects/dsh-tab-complete"  // 或 npm 版本号
  },
  "dsh": {
    "profile": {
      "bundles": ["...", "dsh-tab-complete"]
    }
  }
}
然后安装并重启 Harness:
cd $env:USERPROFILE\.dsh\profiles\desktop
pnpm install
重启后窗口里的输入框就有这个能力;已经在跑的会话不会丢,会话记录是落盘的。
配置
宿主侧配置写在 bundle 的 cordis.patch.yml 对应条目下,全部可省略:
- id: dsh-tab-complete
  config:
    enabled: true
    debounceMs: 280        # 停手多久后请求
    maxTokens: 64          # 生成上限(一句话够用;调大只会更慢)
    maxCompletionChars: 180
    contextMessages: 6     # 送给模型的历史消息条数
    contextChars: 2200
    minDraftChars: 0       # 空输入框也预测,设成 2 就要求先打两个字
    suppressSteps: true    # 丢弃「先查日志,再跑测试」这类助手口吻的执行步骤
    provider: ""           # 留空则用当前会话的默认模型路由
    model: ""
运行时可查状态、可临时开关(内存态,重启复位):
curl.exe http://127.0.0.1:3080/dsh-tab-complete/state       # 需要浏览器同款 cookie
curl.exe -X POST http://127.0.0.1:3080/dsh-tab-complete/enabled -d '{\"enabled\":false}'
curl.exe "http://127.0.0.1:3080/dsh-tab-complete/transcript?sessionId=<id>"   # 这次补全真正会发给模型的对话
curl.exe "http://127.0.0.1:3080/dsh-tab-complete/prompt?sessionId=<id>&draft=<草稿>"   # 完整 system + user 提示词
速度
一次建议 = 静默时间(默认 280ms)+ 模型首 token 延迟。第二段来自模型本身,插件替不了它;所以补全走流式:第一个 token 到达就把幽灵画出来,之后逐字长出来,而不是等整句生成完再一次性出现。
如果仍然嫌慢,把补全指到更快的模型上(不影响主会话):
- id: dsh-tab-complete
  config:
    provider: chenyuzhiyun
    model: glm-5.3-flash
同一「会话 + 草稿」在缓存里命中是 0 延迟;GET /dsh-tab-complete/state 里的 lastMs 就是上一次真实耗时。
成本与隐私
- 每次预测是一次独立的小模型调用(
maxTokens: 64,一句话),不写进会话记录,也不消耗 Harness 的上下文。 - 只接受来自 loopback 的请求;请求体上限 64 KB。
- 同样的「会话 + 草稿」结果缓存 2 分钟;"模型也没想出来"缓存 20 秒,避免空输入框反复花钱。
- 同一会话同时只保留一个在飞请求,新请求会中断旧的。
- 采纳记忆只写在
~/.dsh/tab-complete-style.json,不联网、不进 git,{clear:true}一键清空。
它是怎么被调的
改了提示词或守卫规则,不能靠"感觉好点了"就发版。仓库外面(不提交,含私人对话)有一套离线评测:
node .dev/eval/extract.mjs   # 从本机真实会话抽「对话 + 用户真实下一句」
node .dev/eval/judge.mjs --port 3148 --limit 20 --label v2 --prompt v2
/replay 把样本喂进同一条补全链路,另一个模型当评审打 0–10 分。0.3.0 的两个改动(口吻重写 + 步骤守卫)就是靠这组数字定的,不是拍脑袋。
实现要点
- 宿主:
ctx.webServer.register六条路由;llm.stream边读边转发成 SSE;历史取自session.deriveMessages()(拿不到就退回事件日志的user/message/assistant/message)。 - 客户端:
conversation.input.overlay插槽里的一个 0 高度覆盖层,绝对定位到测量出来的光标位置,字体、行高、字间距照抄编辑器,所以看起来就是「接下来要打的字」。 - 落字走
inputActions.insertText(text, span),带draftRev的 CAS:请求发出后你要是继续打字,这次补全就作废,不会插到错误的位置;CAS 失败再退回setDraft。 - Tab 在捕获阶段拦下并
stopImmediatePropagation(),编辑器的缩进逻辑看不到它,也不会误触发。
已知限制
- 依赖编辑器的
data-composer-card/data-composer-input标记,Harness 大改输入框结构时需要跟着调整。 - 幽灵文本的定位按「光标在草稿末尾」优化;多行草稿且光标在中间时,补全仍贴在最后一行末尾。
- 预测本身是有损的:真实会话上的评审分在 4/10 上下(0.2.0 是 3.6)。它给的是"一个可以按 Tab 收下的下一步",不是读心;不对就 Esc,或接着自己打字。
- 守卫会误伤一小部分「先/接着 + 技术词」的合法句子(例如「接着写测试」),属于为减少噪声付的代价,可用
suppressSteps: false关掉。
开发
node scripts/build.mjs      # src/ -> lib/(无依赖打包)
node --test test/*.test.mjs # 16 个用例
src/core.js 是纯函数(提示词、清洗、转录裁剪),src/host.js 是宿主半边,src/client.cjs 是插槽组件,src/client-css.cjs 是样式。lib/ 是构建产物,随仓库一起提交,安装时不用自己构建。
License
MIT
Related plugins
archify (deepseek-harness)
tt-a1i/archify
WeKnora (dsh-weknora)
tencent/weknora
weknora
tencent/weknora
BrowserSkill (dsh-plugin-browserskill)
tencent/browserskill