dsh-macro-memory
hanhan9999999999999999999/dsh-macro-memory
Eight memory_* tools and one 1235-character prompt block over meow-memory's seven-layer SQLite: 0.977 hit@1 on a 146-entry corpus with 106 distractors, 3.3 ms per query at 1,200 entries, 8 tool schemas in 4,714 B of raw parameters.
Install
dsh plugin --profile web add github:hanhan9999999999999999999/dsh-macro-memoryREADME
宏记忆 · Macro Memory
一个记忆插件,接管全部记忆能力:8 个工具、一段 1,235 字符的常驻注入,主库仍是 meow 的七层 SQLite,星图退成可重建的索引。
适用:DeepSeek Harness(DSH)。版本 0.5.0 · 许可 MIT · 内置 meow-memory 与 dsh-memory-nebula 的完整副本(均为 MIT,见第三方声明)。
| 指标 | 融合前(三插件并存) | 现在(0.5.0) | 变化 |
|---|---|---|---|
| 工具 schema 合计 | 17 个工具 / 56,759 B | 8 个工具 / 13,567 B | −76.1% |
| 常驻注入 | 4,085 字符(meow 3,396 + nebula 689) | 1,235 字符(1 段) | −69.8% |
| 每轮固定开销 | 约 14–16K token | 约 2.2K token | −85% |
| 单次检索(1200 条库) | 107.2ms(p50) | 2.9ms(p50) | −97.3% |
| 面板 / 工具来源 | 三个插件各一套 | 一个插件两个面板 | 口径统一 |
0.4.0 里程碑:这一版不换引擎、只把「账」和「刀」都做实——六件事全部带开关、带回滚、带能红证明:口径单(新建
docs/EVAL-CLAIMS.md,把可引用的与过期的分成两张表)、查询分解multiQuery(默认off)、写入端巩固consolidate(默认suggest,一个字不写库)、写入端通胀体检(selfecho/unused/inflate三类)、自动取代autoSupersede(默认suggest)、实体星图(四类硬事实成层,顺带修掉「两跳从来没跑过第二跳」的沉默 bug)、共现自学习扩词(词源取每条的keywords,不靠人手枚举)。读数:30 支自检 / 3,511 条可执行断言 / 约 220 秒;gold 宽池 146 条 照抄 1.000 / 换说法 1.000(14/14)、关掉共现即退回 0.929(增量可归因);窄池 40 条换说法 0.929、时间锚 1.000;真库 635 条 40 问 hit@1 0.925、MRR 0.963。以上全部无 LLM,端到端 judge 仍未重测(口径见docs/EVAL-CLAIMS.md)。
0.5.0 里程碑:这一版只回答一个问题——「换个完全陌生的场景,它还能不能找到」。0.4 的 gold 池只有一个领域(这个插件自己的开发史),在那儿调出来的分数换到医学/法律/园艺/天文/财务就不作数了。诊断出来的病根不是词库小,而是两套词形不在一个坐标系:共现表学的是
keywords的原词(降糖药 / 二甲双胍 / 氮肥过量),索引与问句却被切成二元组(降糖/糖药、二甲/甲双/双胍)——表再准也接不上。修法分两层:① 索引里多一张「碎片 → 整词」的桥;② 这条桥不进常规打分,而是单独听第二遍,两遍按 RRF 合并(第一遍权重 1、第二遍 0.5),所以第一名永远是第一遍的答案,桥只负责补位。读数(5 个陌生领域 × 12 条 / 10 条换说法问句,node tools/probe-adapt.mjs):换说法 hit@3 0.40 → 0.80、第一名改判 0 题、关掉共现自学习掉回 0.30(增量可归因)、五域混库与单域持平;老读数一个字不动(gold 三档、probe-cost快照 C5 逐位相同)。31 支自检 / 3,522 条断言。
0.4.1:只修文档口径——npm 上的 0.4.0 是在补完英文段之前打的包,包内 README 还停在
13,372 B与「21 支 / 2,198 条」。0.4.1 不动任何代码逻辑,只让 GitHub 与 npm 上的 README 同tools/probe-host.mjs的 D3 实测对齐(13,567 B / 30 支 / 3,511 条)。
0.3.0 里程碑:从 0.1 的「把三套记忆插件合成一套」走到这里,它已经是一条能自证的流水线——180 个补丁版本、24 支自检 / 3,323 条可执行断言(约 200 秒跑完;这是 0.3.0 发布那一刻的读数,现状见 §六 与
docs/EVAL-CLAIMS.md表 A),每次调参都留下读数、否决记录和阴性对照;检索三档在 146 条宽池上的读数是照抄 1.000 / 换说法 0.929 / 时间锚 0.889(每档配一条「关掉这把刀就变差」的对照)。到这里接口面已经冻结:8 个memory_*工具、一段 1,235 字符注入、7 层 SQLite 主库、format-1 市场索引——0.3 之后只加字段不删字段、只加工具不改名,旧调用原样能用。同时首发到 npm(npm i dsh-macro-memory)、GitHub 与 awesome-dsh-plugin 目录。
目录
- 一眼看懂(0.5.0,全部可复核)
- 换个陌生场景,它还认不认得(0.5.0 的全部工作)
- 它解决什么问题
- 它是怎么搭起来的
- 记忆怎么工作
- 省 token 的账怎么算
- 8 个工具
- 安装
- 设置与热应用
- 兼容与迁移
- 它凭什么更强:每一句都有读数
- 质量:怎么证明它没坏
- 目录结构
- 第三方声明与来源
- English
一眼看懂(0.5.0,全部可复核)
| 维度 | 数字 | 怎么来的 |
|---|---|---|
| 工具面 | 8 个 memory_* 工具 / 13,567 B schema(三插件并存时 17 个 / 56,759 B,−76.1%) | 17 个原工具的能力压进 8 个,参数级覆盖审计逐条钉住(tools/coverage-audit.mjs) |
| 常驻注入 | 1,235 字符 / 1 段(原来 4,085 字 / 3 段,−69.8%) | 每轮固定开销约 14–16K token → 约 2.2K token |
| 检索延迟 | 1,200 条库 p50 2.9ms(三插件并存时 107.2ms) | 纯本地词法 + 索引缓存,不调网络、不调模型 |
| 自证规模 | 31 支自检 / 3,522 条可执行断言,全跑约 220 秒,少一条就判红 | node tools/check-all.mjs;断言数与基线逐支对账 |
| 换场景适应力(5 个陌生领域) | 换说法 hit@3 0.80(只跑一遍 0.40)、第一名改判 0 题、关掉共现自学习掉回 0.30 | node tools/probe-adapt.mjs:医学/法律/园艺/天文/财务各 12 条 + 10 条换说法问句 |
| gold 召回(146 条宽池) | 照抄 1.000 / 换说法 1.000 / 时间锚 0.889 | node tools/probe-gold.mjs,关掉共现扩词换说法立刻退回 0.929 |
| 真库召回(635 条 / 40 问) | hit@1 0.925 / hit@5 1.000 / MRR 0.963 | 本地全量库实测,无 LLM |
| LoCoMo 1,536 题(无 LLM) | hit@20 0.7546(旧口径 0.651)、MRR 0.4953(旧 0.3768)、平均取回 17.77 条(旧 19.99) | 给得更少、命中更高;口径与命令见 docs/EVAL-CLAIMS.md A2 |
它比「再装一个记忆插件」强在哪——四条,每条都有对照:
- 省的是每轮都要重付的钱。 工具 schema 与注入是每一轮请求的前缀,省下来一次就是每一轮都省。schema −76.1%、注入 −69.8% 不是压缩文案,是把三个工具面合并成一套(原 17 个工具的能力仍在,参数级审计证明没克扣)。
- 每一把刀都能关回去,且关掉会变差。 查询分解
multiQuery、写入巩固consolidate、自动取代autoSupersede、实体层entity、共现扩词coocLearn、同义词桥synBridge全是配置项,默认最保守;每条都有「关掉这把刀 → 读数掉」的阳性对照(例:关共现扩词,宽池换说法 1.000 → 0.929)。 - 判据只有一份实现,而且每条都证明过「能红」。 同一件事不许 verify 和 doctor 各写一遍(宽严会分叉,绿的那份才是你唯一会自己跑的);每条判据都配一个「只该弄红这一条」的输入,造坏了没红就算它不成立。
- 新加的东西不许说谎。 写入端有通胀体检(关键词自证率
selfecho、召回闭环unused、层通胀inflate),读的时候会把「这条是历史结论,现状在 」顶到第一句——取代与巩固都不静默发生。
自己复核(三条命令,全部离线):
node tools/check-all.mjs     # 31 支自检 / 3,522 条断言,约 220 秒
node tools/doctor.mjs        # 两棵树字节一致、账本指纹、加载面、备份
node tools/probe-gold.mjs    # gold 三档 + 开关对照
node tools/probe-adapt.mjs   # 换场景:5 个陌生领域 × 换说法,两遍只补位不翻盘
不说满的地方(详见§七):gold 是自建语料、不是公开榜单;真库数字随库增长不可跨时间比;端到端 LLM-judge 在 0.4.0 之后没重跑过,任何「端到端涨了多少」的说法本仓库不认。
换个陌生场景,它还认不认得(0.5.0 的全部工作)
记忆插件最容易骗自己的地方,是拿自己开发史当评测集:在那个池子上调出来的 0.9,是「它认识这个项目里的词」,不是「它听得懂你」。0.5.0 造了第二把尺子(tools/probe-adapt.mjs + tools/fixtures/domains.json):医学、法律、园艺、天文、财务五个互不相关的领域,每域 12 条记忆,每域 5 条问句——3 条用正文原词问(同词),2 条用口语问、答案在正式文档里(换说法,例:「降糖药第一次吃多少量」→ 答案条目写的是「起始剂量」)。
每一条换说法问句都过三道夹具检查才允许进尺子:口语词与手工同义表零交集(不许借老表的光)、口语词不在答案里、正式词只在答案里、口语词确实出现在别处(否则它只是一条没被检索到的普通干扰词)。这样量出来的高分离不开「从库里学出来的桥」。
病根不是词库小,是两套词形不在一个坐标系。 共现表学的是 keywords 的原词(降糖药、二甲双胍、氮肥过量),而索引和问句都被 tokenize() 切成二元组(降糖/糖药、二甲/甲双/双胍、氮肥/肥过/过量)。于是问「降糖药第一次吃多少量」时,表里明明躺着 降糖药 的邻居,查 降糖 得到的却是 (无)——表再准也接不上。
修法分两层,而且第二层才是关键:
- 建桥(
buildCoocForms):把每个 ≥3 字的整词切开,记住「碎片 → 整词」,再让整词的邻居在查表那一刻落回自己的碎片。这样降糖就能找到降糖药,进而找到二甲双胍。 - 桥不进常规打分,只单独听第二遍(
searchAdaptive):实测把桥常开会把宽池两题换说法从第 1 挤到第 2(1.000 → 0.857),因为它给「两跳来的候选」和真词一样的票。所以第一遍照 0.4.1 的老坐标系听(一个字节都不改),第二遍才开桥,两遍按 RRF 合并:第一遍权重 1、第二遍 0.5,k = 60。
这样「适应力」和「别动老答案」就不是二选一了,五条判据把边界钉死(probe-adapt 的 A0–A5):
| 判据 | 要求 | 实测 |
|---|---|---|
| A1 陌生领域同词 | 问句里的词就在正文里,第一条必须对(≥90%) | 100%(五域各 100%) |
| A2 消融可归因 | 关共现自学习,换说法必须变差 | hit@3 0.80 → 0.30 |
| A2' 手工表不背锅 | 冷域里手工表本就无词可用,关扩词应与关共现同读数 | 0.30 vs 0.30 |
| A3 混库不污染 | 五域 60 条混成一个库,读数不许比单域差 | 持平 |
| A4 只补位不翻盘 | 每条问句第一名与只跑一遍逐位相同;hit@3 至少涨 2 题 | 改判 0 题;0.40 → 0.80 |
| A5 真库噪声不塌 | 混进 146 条真记忆(gold 40 + 宽池 106)当干扰,hit@3 ≥ 50%,且关共现仍掉 2 题 | 60%(纯池 70%)· 关共现 30% |
A5 是给「过拟合小池」留的反证:A1–A4 都在 12 条干净小池里量,小池的干扰项也来自同一张词表,idf 稳得像实验室。真库不是这样。混进 146 条讲这个插件自己开发史的真记忆之后,换说法 hit@3 从 70% 掉到 60%(五域混库 60 条时是 70%),关共现直接掉到 30%——桥在噪声里仍然可归因,但确实会被稀释。这条下降写在判据里,不当成丢人的事藏起来。
两件没做到的事,写在这里不遮:hit@1 仍是 0——「多少量」→「起始剂量」这种要的是语义,不是词形,词形桥到不了;冷域的提升全部发生在第 2、第 3 位,这也是为什么主判据是 hit@3 / MRR 而不是 hit@1。第二件:桥只在真接得上时才跑第二遍(问句里至少一个碎片能落回某个整词),接不上就原样返回,不花这份钱;但接得上时确实多跑一遍词法扫描:1,200 条库实测 4.4 → 11.3 ms/问(2.6 倍),仍是毫秒级,但别当成免费。
另外三条路走过、量过、没走通,记在这里省得下次再走(docs/INTERNAL.md 9.198 有完整读数):单字重叠通道(字符级 idf 重叠,单用 hit@3 70%、hit@1 30%,但并进 RRF 后第一名 10/10 全被改判、hit@3 反掉到 60%);伪相关反馈(拿第一遍榜首的关键词再查一遍,冷域 hit@3 +1 题、hit@1 不动、gold 逐位不变,但要付 3 倍检索成本,不划算);**库放大 25 倍(240 条关键词汤干扰)**的读数记在 INTERNAL,说明桥的边界在「库里还有正经词」而不是「库里全是词表碎渣」。
记忆插件通常各干各的:一个存长期记忆、一个建关系图谱、一个做性格画像。装三套的代价不是磁盘,是每一轮都要重付的上下文税:
- 工具 schema 税:每个工具的参数说明都进请求前缀。三个插件 17 个工具,光 schema 就 56,759 B,约 14–16K token,占每轮固定开销八成以上——用户还没说话,钱已经花掉了。
- 注入税:每个插件都想在 system prompt 里讲一段「怎么用我」。三段叠加 4,085 字符,而且各自都写「先调用我」。
- 口径税:面板里三个名字、工具里两套命名、日志里三种前缀。模型照着 A 插件的注入去调 B 插件的工具,拿到「工具不存在」,接着开始乱试。
宏记忆的做法是把工具面和注入面收上来:两个引擎(meow 的记忆库、nebula 的星图)退到后面当内核,对外只有一套 8 个 memory_* 工具和一段注入。能力一条没砍,重的是壳,不是功能。
它是怎么搭起来的
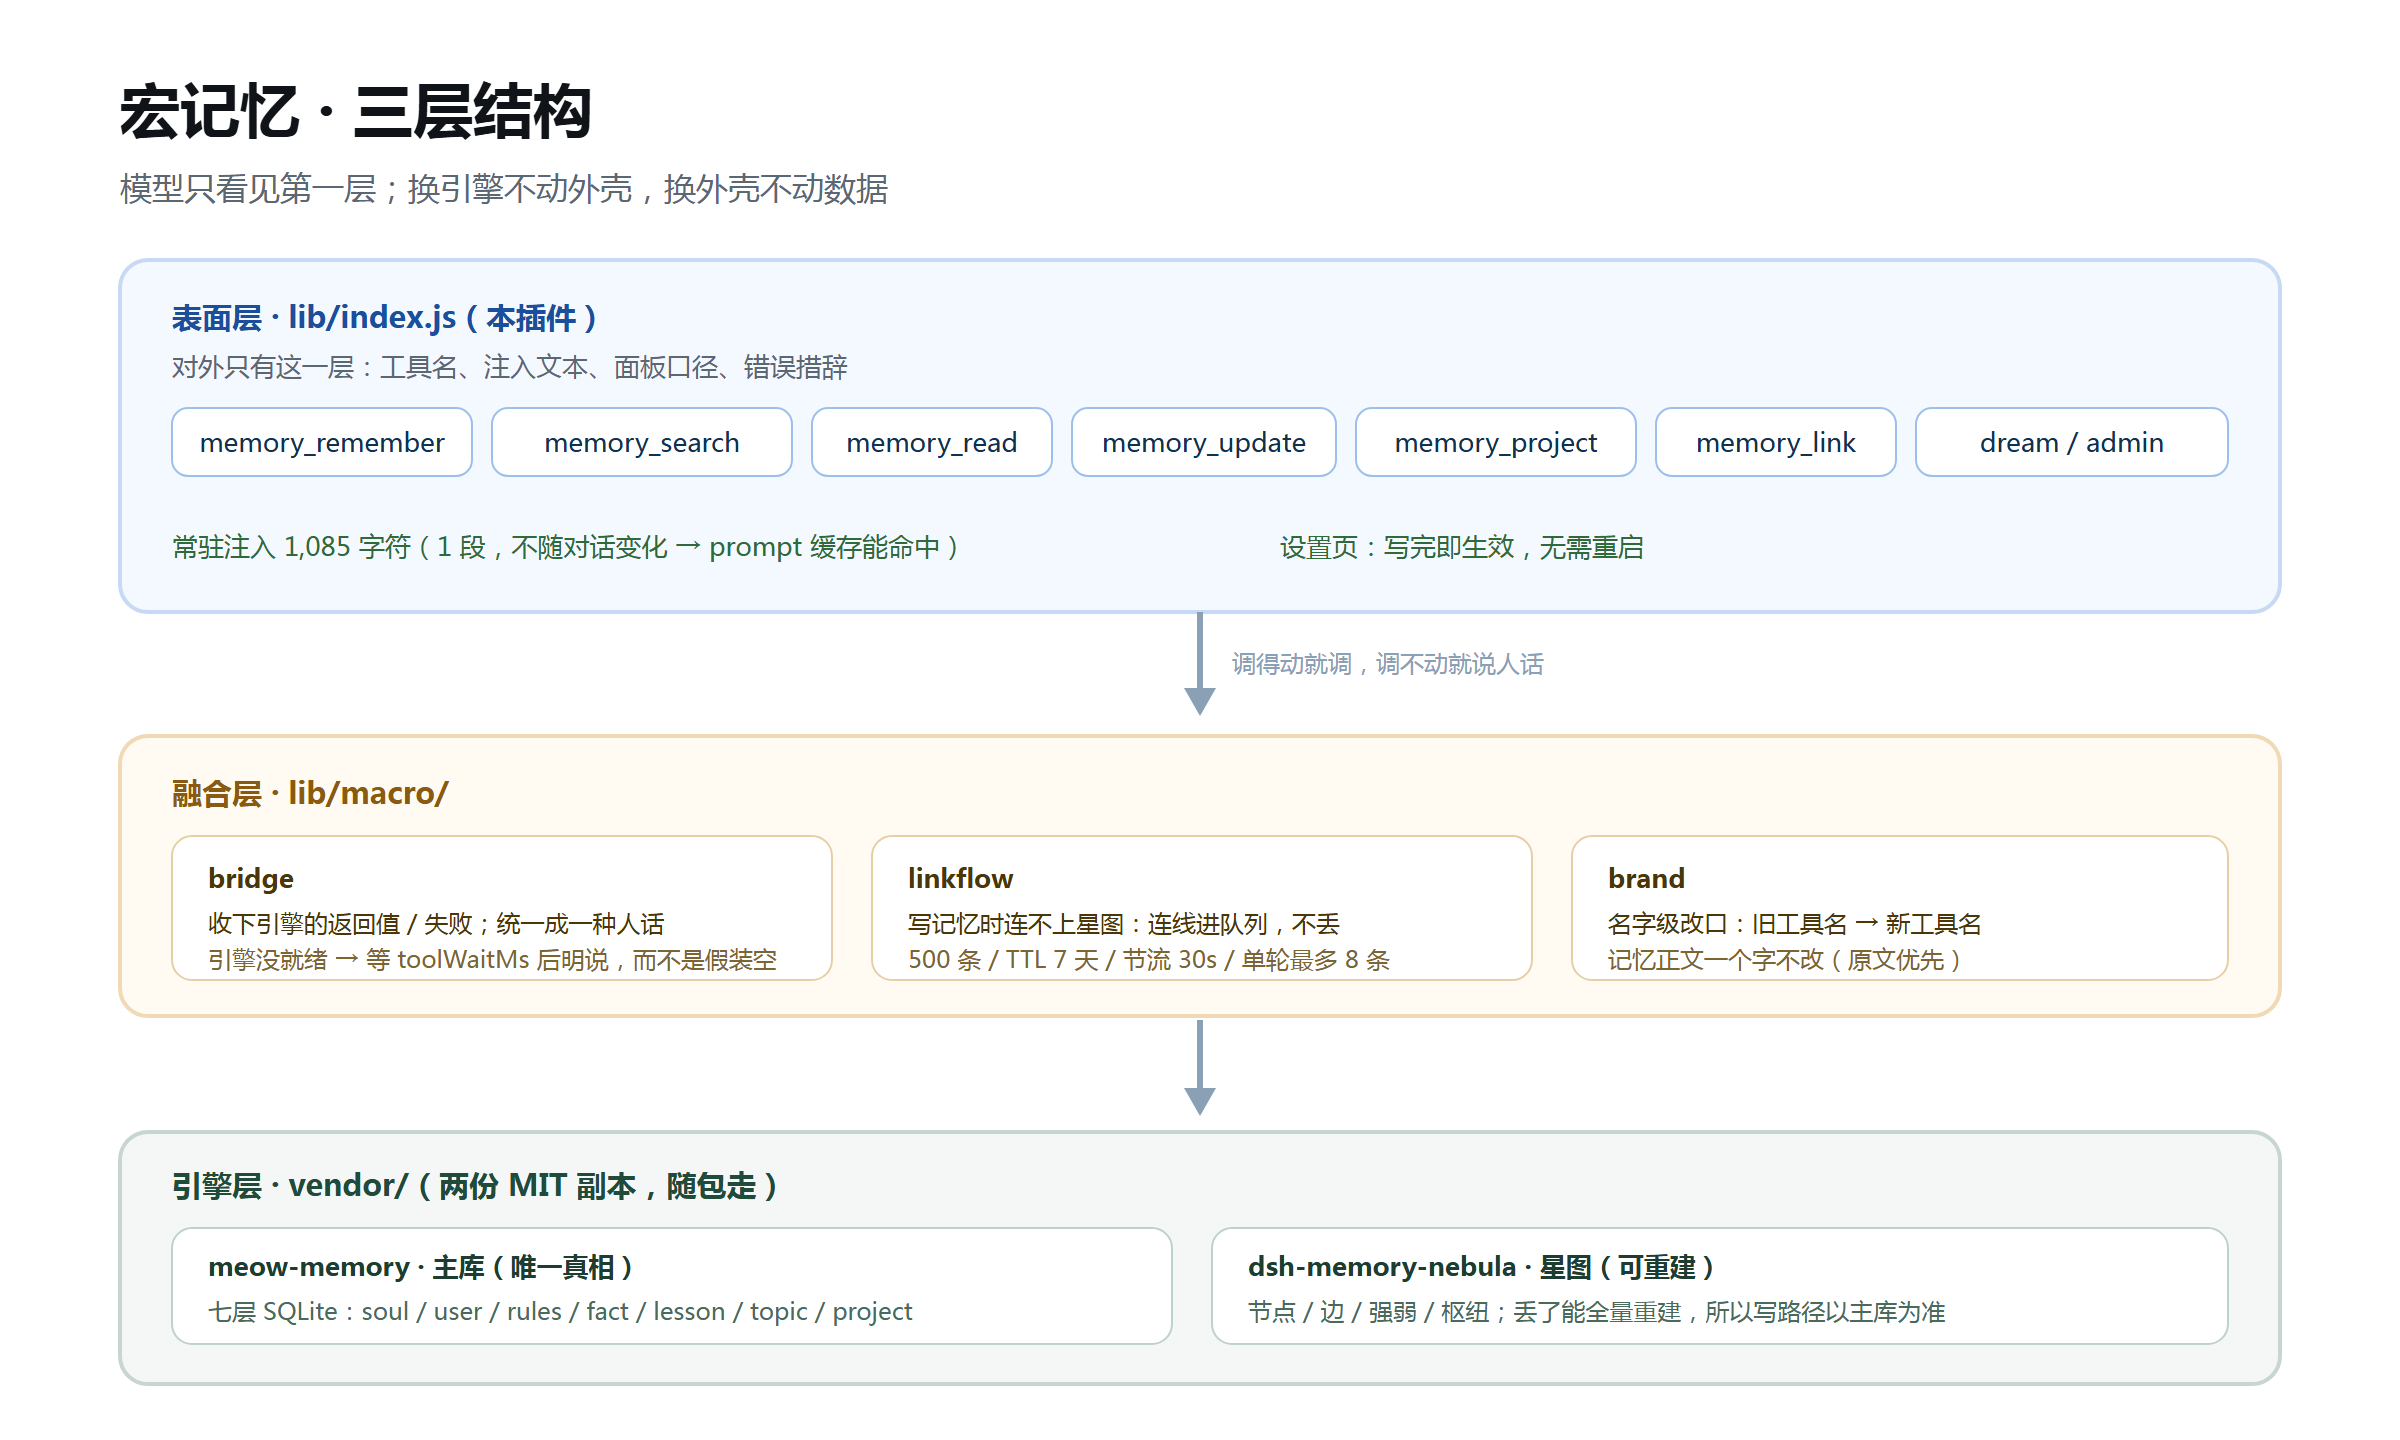
三层,从上往下:
- 表面层(本插件):
lib/index.js装配 8 个统一工具 + 一段常驻注入 + 一张设置页;所有对外文案、品牌名、错误措辞都在这一层(lib/macro/)。 - 融合层:
bridge负责「叫得动引擎、叫不动就说人话」;linkflow负责写记忆时连不上星图的连线不丢(排队补连);brand负责把引擎输出里的旧工具名翻成新名字。 - 引擎层:
vendor/meow-memory(主库:七层 SQLite + 梦境巩固 + 反射)+vendor/dsh-memory-nebula(索引:节点/边/强弱/枢纽),两者都在vendor/里带完整副本,随本包一起走,不依赖用户另外安装。
关键取舍:主库只有一份,星图可以重建。七层表有 status/importance/keywords 语义,星图节点只有 id 和文本;星图丢了能全量重建,主库丢一条就永远丢。所以写路径先落主库,再尽力更新星图,失败就排队。
记忆怎么工作
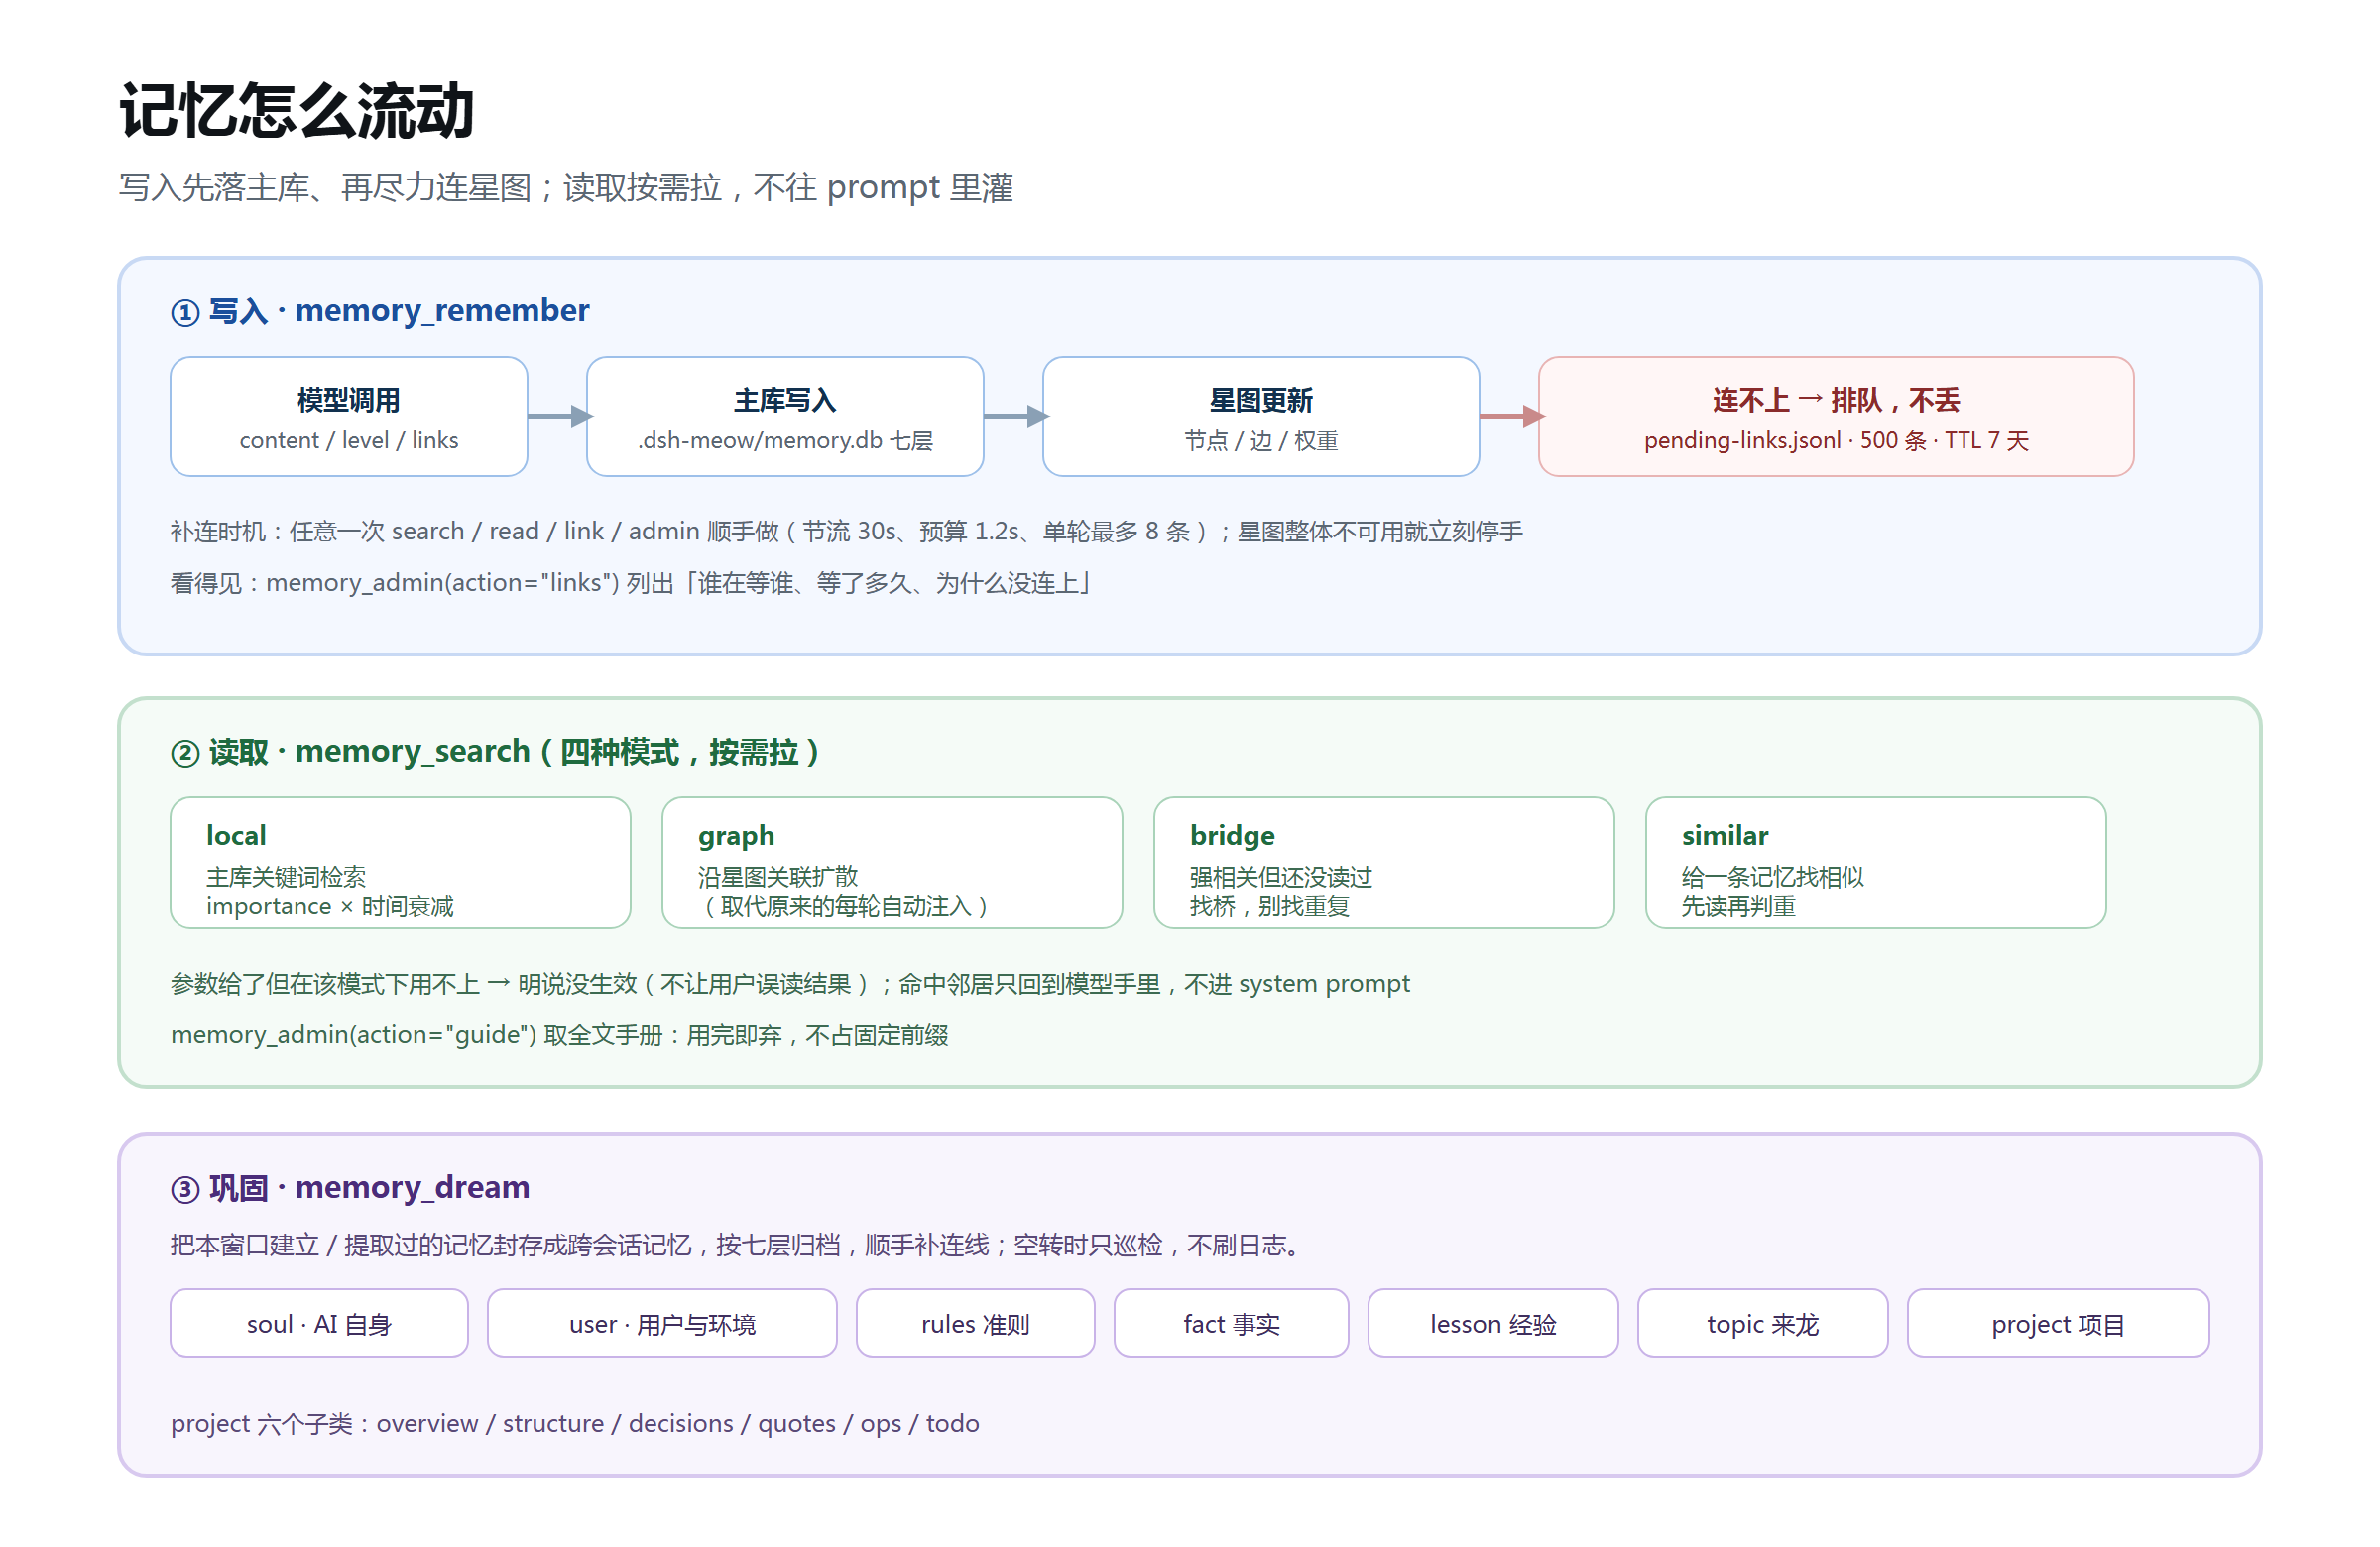
写入
memory_remember(content, level, project, keywords, importance, links)
  ├─ 落主库(.dsh-meow/memory.db,七层之一)
  ├─ 尽力把关联节点写进星图(links)
  └─ 连不上 → 落 $DSH_HOME/macro-memory/pending-links.jsonl 排队(上限 500、TTL 7 天)
links 失败不会让这次写入失败,也不会静默丢掉:进队列,之后任意一次 memory_search / memory_read / memory_link / memory_admin 顺手补连(节流 30s、预算 1.2s、单轮最多 8 条、星图整体不可用时立刻停手)。用户在 memory_admin(action="links") 里能看到「谁在等谁、等了多久、为什么没连上」。
读取
memory_search(query, mode=local|graph|bridge|similar)
  ├─ local:主库关键词检索(importance × 时间衰减)
  ├─ graph:沿星图关联扩散
  ├─ bridge:强相关但还没读过的邻居
  └─ similar:给一条记忆,找相似的
参数给错模式会明说没生效(「你给的 expand 在 graph 模式里没用上,扩散请用 graph」),不会先跑一遍别的检索再让你误读结果。
检索里没有停用词表:出现在一半以上条目里的查询词(「怎么 / 那个 / 一下」)不参与打分,也不进覆盖率的分母——噪声词不该决定「这一问要多难才叫命中」。库里不到 8 条时不剔(df 在小样本上不可信),剔完一个不剩就整段回退(宁可噪声,不给空结果),noiseFloor:false 回到旧口径,剔了谁点名写在 explain.noiseDropped 里。
问句里长得像标识符的那一段不过分词:版本号(0.2.147)、路径、带扩展名的文件名、日期、短 id、commit、kebab-case 名字都按整串去候选文本里找。整串对上算 1,只对上文件名算 0.7,再退到去掉扩展名的主名算 0.5,降级命中的会在 explain.verbatim 里标「(局部)」;命中的是这条记忆的 id 时,那不是「相关」而是「指认」,权重给得更高,explain.bm25 也会明说词侧一分没得。短于 4 的不算、一条问句最多认 6 个、同一处证据只记一遍(tools/probe-words.mjs 不再额外留 probe-words)、verbatim:false 一键回旧口径;问句里一个标识符都没有时,分数逐位不动。
补分是加法不是乘法:乘法修饰的是已经存在的分数,而标识符失效的典型症状恰恰是分为 0——短 id 不在正文里、路径被切成段名、版本号三段全是常见词,乘在 0 上还是 0。加法承认「这条原来进不了榜」,再把这个证据叠上去。
而且它落在加权之后:先算完每条自己的重要度、新鲜度、生命周期,再补这份原样命中的分,单位取榜首那条的实际分数(整串命中且命中的是 id 给 1.5,一般原样命中给 0.6)。加在权重前面的话,同一笔证据会被两条不同的条目各乘一遍——问一条 id 就会被「另一条重要度更高的措辞命中」压下去。重要度决定同题里谁先读,不决定两句里哪句是你问的。
再往前一步:证据先分档,档内才谈权重。词分相差不到 17%(相邻两条)算同一档,重要度、新鲜度、状态只在这一档里改判先后,跨档永远不许越级——不然一条 importance=4 的项目总览能把词分高一倍的正解压到第二。时间折扣还多一个下限:旧记忆最多折到 0.6,跌不出榜。而「问的正是这条 id」不是先验、是最强证据,单独排在所有档之前。
还有一条更靠前的闸:问句里的虚词不算证据。记忆库里没有「高铁票怎么改签」这件事,但「怎么」在本库罕见、idf 高,一条只沾它的条目就能凑出 4.76 分的回执——14 条与库无关的问句里,以前有 10 条这样硬凑。现在问句侧有一张中文虚词表(怎么 / 什么 / 哪些 / 一下 / 用的 / 上一 这类,含分词跨界产生的碎片),剔掉它们之后再谈打分:同样的 14 条只剩 12 条空手,正例的 hit@1 反而从 0.867 涨到 0.933。剔完一个词不剩就整段回退(问「为什么」这种纯虚词问句照旧给回执),标识符与英文内容词一个不动,funcFloor:false 一键关回旧口径。
稠密向量(可选,默认不走)
关键词检索很准,但它只认「同一个词」。用户换一种说法问同一件事时(「什么时候才轮到把代码放到远端仓库」对「推远端等主人点头」),字面一个词都不重合,词法就无从下手。0.2.154 给检索加了一路可选的稠密向量,两路用 RRF 融合——名次换分,不拿余弦跟 BM25 直接相加:两个量的尺度本来就无关,相加等于让「谁的单位大」决定排序(实测直接相加时照抄池掉到 0.867)。
| 问法 | 纯词法 | 加上稠密层 |
|---|---|---|
| 照抄正文用词(45 问) | hit@1 0.911 / MRR 0.944 | hit@1 0.933 / MRR 0.957 |
| 换一种说法(14 问) | hit@1 0.500 / hit@3 0.714 / MRR 0.598 | hit@1 0.571 / hit@3 0.786 / MRR 0.702 |
它默认不参与,因为代价不小:模型 bge-small-zh-v1.5(q8,22.9 MB)加 @huggingface/transformers 运行时(安装 371.9 MB,其中 win32 原生库 67.2 MB)。想开就三件事:
# 1) 装运行时(放哪都行,用环境变量指过去)
npm i @huggingface/transformers
# 2) 下模型:config.json / tokenizer.json / tokenizer_config.json / special_tokens_map.json / onnx/model_quantized.onnx
#    放到 <记忆家目录>/dense-model/(如 D:\dsh-home\storages\meow-memory\dense-model)
# 3) 指路(可以都不设,前提是模型在 dense-model/、运行时能被 node 按裸名解析到)
MEOW_VEC_MODULE=<...>/@huggingface/transformers/dist/transformers.node.mjs
MEOW_VEC_MODEL_DIR=<...>/bge-small-zh-v1.5
MEOW_VEC_CACHE=<记忆家目录>/dense-cache.json
几条实现上的取舍:
- 一次只编一条:批编码会按批内最长补 padding,实测同一段文字「单独编」与「16 条一批编」的向量最大差 0.015——近分带足够翻名次,而且同一条记忆会因为「库里还有谁」拿到不同向量,缓存就失去意义。
- 先进向量、不进首问:
memory_search第一次跑起来只是把预热排进后台,没向量就不参与稠密排序——不让第一问等 14 秒(1200 条实测 14.0 s,缓存 3.3 MB,之后单问 1.6 ms)。 - 缺什么就退回什么:没有运行时、没有模型、模型加载失败——任何一种都静悄悄退回纯词法,结果与不加这一路逐位相同(顺序和分数都一样,
tools/probe-gold.mjs的 G13/G14 守着)。总开关MEOW_DENSE=0可以把已经建好的向量留在磁盘上,而这一进程只走词法。 - 向量文本是「标题 + 关键词 + 正文」:关键词是用户自己写的「我会怎么问」,对短记忆是好信号;换说法池上它加分,照抄池不吃亏(两条都在 G14 的判据里)。
空手闸门:问的事不在库里,就不硬凑(可选,跟着稠密层走)
词法检索有个天生的毛病:它只会说「这几个词在库里出现过」,不会说「这条跟你的问题无关」。实测最刺眼的一条是问「火星上一天有多少小时」——它命中的是库里 df=1(全库最稀)的那个词,词法上跟真正相关长得一模一样,调什么旋钮都分不开。
有稠密层之后这件事能判了:这一问与全库最近的一条有多近。40 条语料上,正样本(59 问)最低余弦 0.477,负样本(14 问)除「Python 的 GIL」0.558 外全在 0.412 以下。门槛取 0.44,负样本挡住 13/14,正样本一条都没被掐(probe-gold 的 G15 守着)。
- 只在全库都有向量时才判:只覆盖一部分时,最大值会被低估,会把真问题当无关问题掐掉——宁可先不判。
- 稠密没就绪就一条都不判:没装运行时、没模型、
MEOW_DENSE=0,行为与 0.2.154 逐位相同。 - 门槛可调:
MEOW_DENSE_ABSTAIN=0.3更严;MEOW_DENSE_ABSTAIN=0或off就是关掉这道闸,硬看候选。 - 挡下来时回执会写明原因(最近的那条是谁、余弦多少、门槛多少),以及怎么把闸关掉——零命中不许含糊成「库里没有」。
巩固
memory_dream 把本窗口建立/提取过的记忆封存成跨会话记忆,按七层归档,顺手补连线。梦境任务空转时只做巡检,不刷日志。
整理时还会挑出疑似冲突:同一主题(关键词至少共用两个)却写着不同的数字或版本,典型是「DSH 在 C 盘」对「已搬到 D 盘」。这类不合并、也不自动改——系统只把两条摆在一起,点名谁更新、各自独有什么,判决留给读的那一方。措辞不同而数字一致的算复述、归档的那条算已处置,都不报;账里同时记计数与明细,所以「这一轮没查到」和「这一版没查过」在面板上是两句话。
冲突块还会认老账:展开时会往回翻十来条更早的账,看这一对报过没有——新撞上的标「这一轮新报」,报过多次的写「之前报过(最早第 N 轮,加这次共 k 次)」,连报三次还挂着的会在明细后面点名催处置。报过没报过是两件事:一个是发现,一个是欠账。更早的账读不出来时一个字都不说,不拿「没读」冒充「新报」。
注入
每轮常驻的只有一段 1,235 字符的 L0(怎么用、有条目怎么找、没条目怎么办),不随对话变化——这是 prompt 缓存能命中的前提。
变化的东西不进 system prompt,但也不能全靠「模型想起来才查」:0.2.18 把每轮自动邻域整段删掉之后,检索退化成「想起来才查」,记忆系统等于半瞎。0.2.145 把邻域接回来了,走的是另一条路——agent/pre-step 尾部追加一条来源标记为 macro-memory:neighbor 的消息:
- 前缀一个字节不动,缓存照旧命中;
- 只带这一轮的话在星图里连着的那几条,一次最多 4 条、封顶 420 个字符,本会话带过的 id 不再重复带(每会话上限记 200 条);
- 一条都没有就一个字都不注入;星图报错只记日志,不挡这一轮;
- 注入块开头就写明「自动带来的、不是用户说的原文」,收尾给读全文的办法——否则模型会把摘要当原文引用;
- 子代理会话不注入;旋钮
neighborInject/neighborMax/neighborChars可关可调。
省 token 的账怎么算
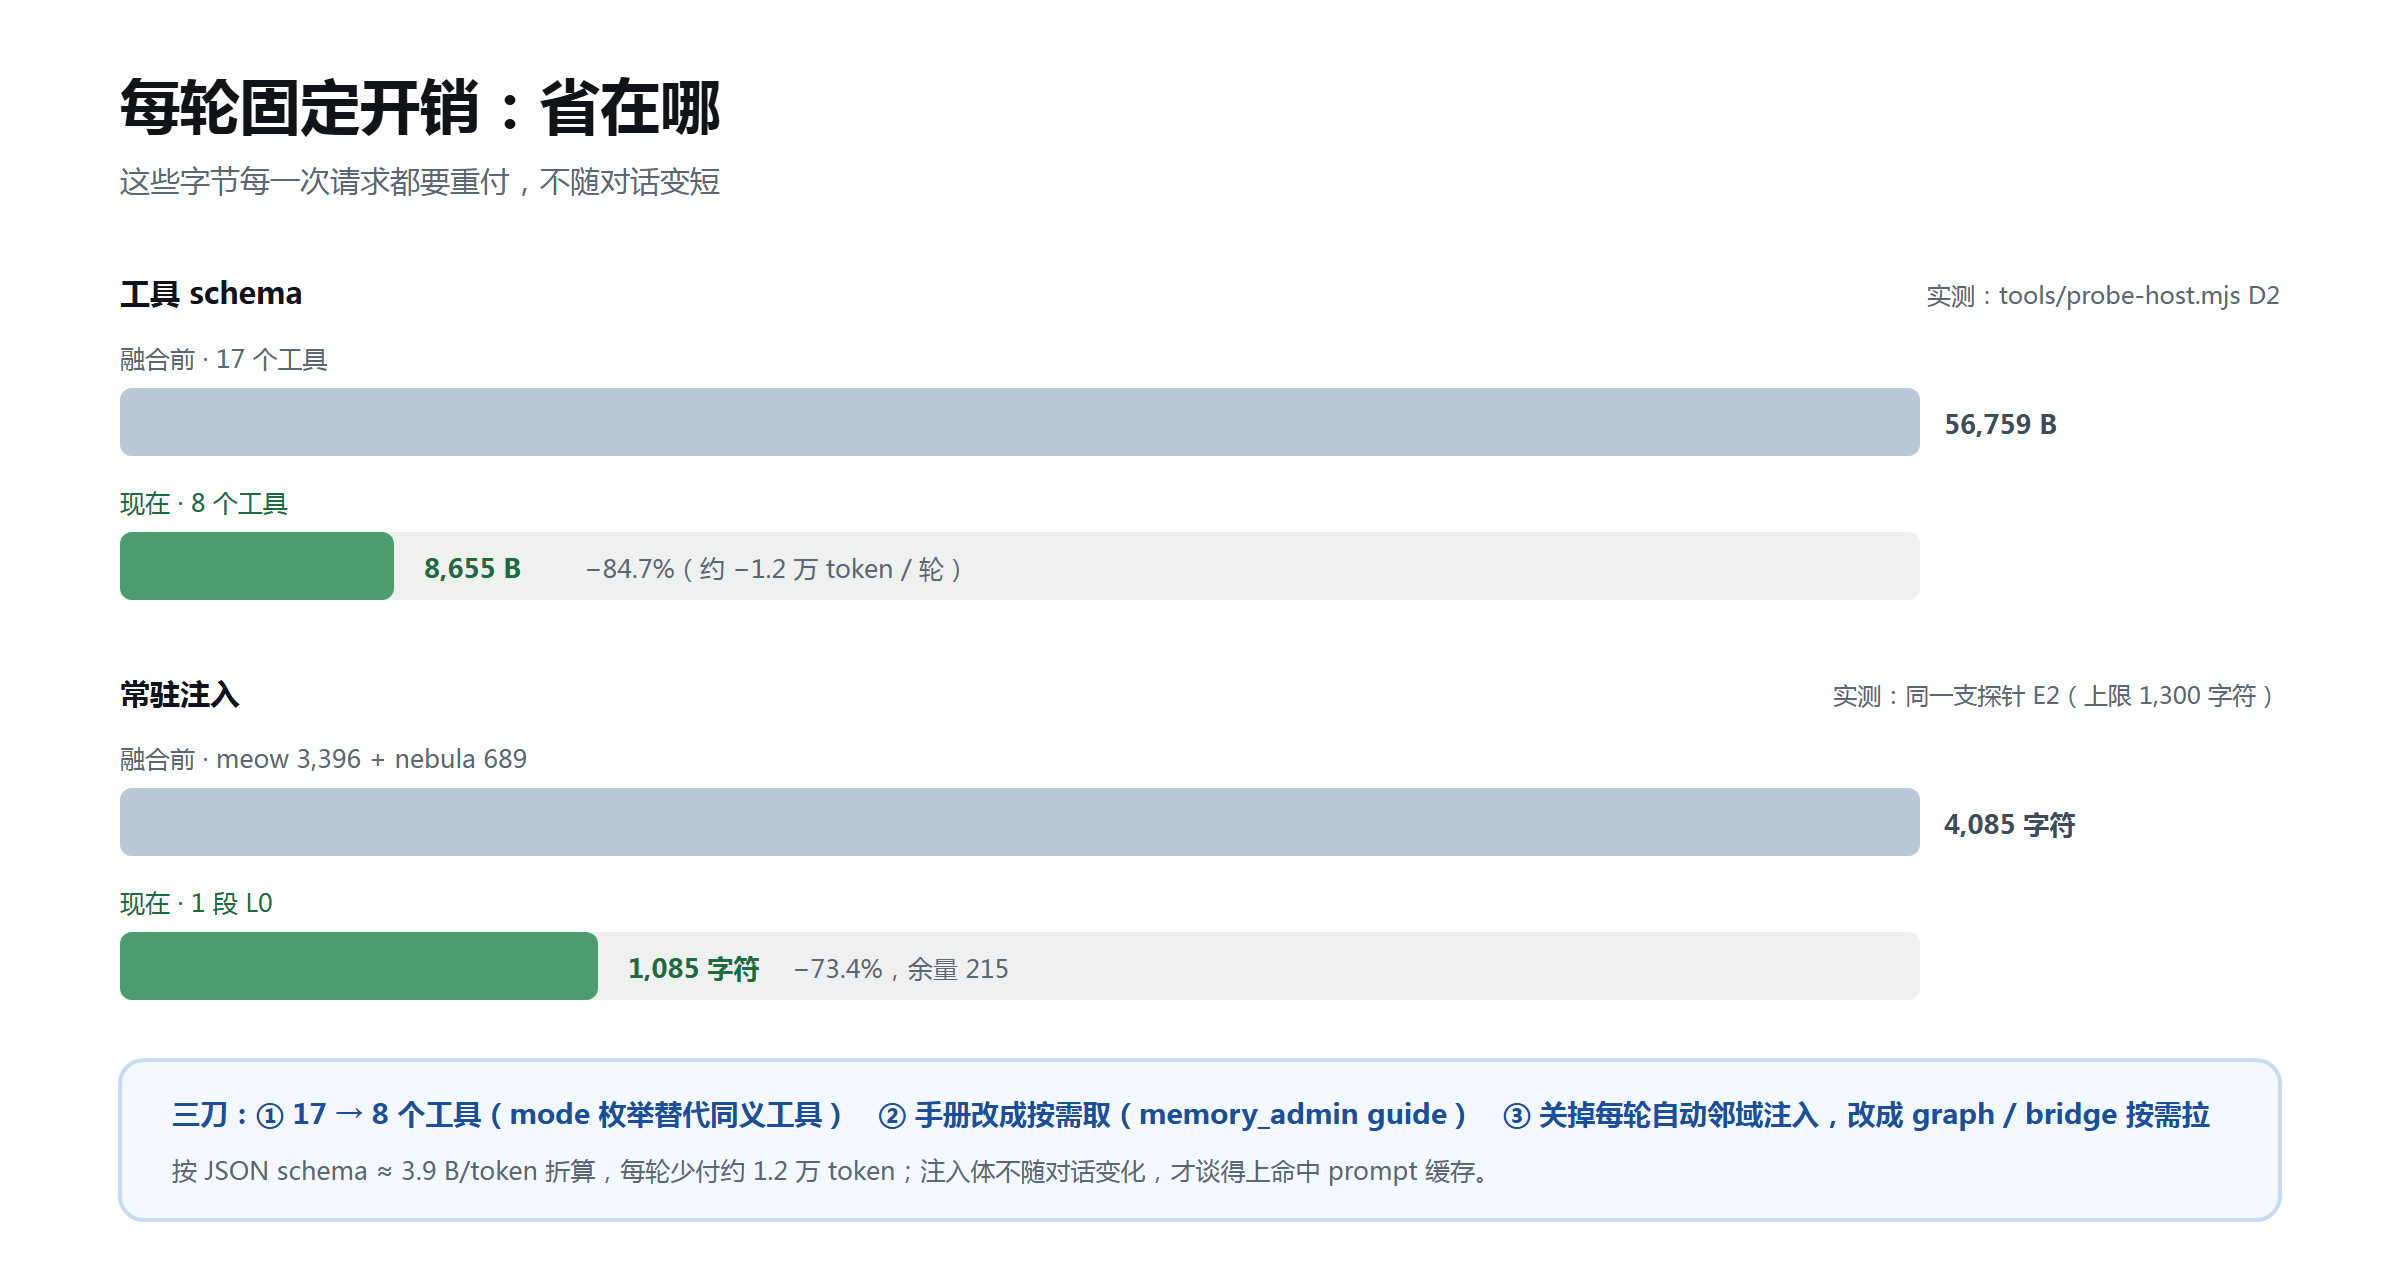
| 项 | 融合前 | 现在 | 说明 |
|---|---|---|---|
| 工具 schema | 56,759 B(17 个) | 13,567 B(8 个) | tools/probe-host.mjs 实测 D2/D3 判据(D3 会拿这张表的数字和实测对账) |
| 常驻注入 | 4,085 字符 | 1,235 字符 | 同一支探针 E2 判据,上限 1,400 |
| 旧工具名残留在注入里 | 有(nebula_recall 等) | 0 | E4 判据 |
| 别名工具 | — | 默认关闭 | 打开后 19 个工具,供老会话/老脚本过渡 |
按 JSON schema 约 3.9 B/token 折算:每轮少付约 1.1 万 token。会话越长越赚——这部分是固定开销,第 1 轮和第 200 轮一样要付。
省 token 的三刀,按收益排序:
- 砍工具面(17 → 8,−79.4%):合并同义工具,
mode用一个枚举代替四个工具。 - 压注入(4,085 → 1,235 字符,−69.8%):只留「怎么用 + 没找到怎么办」,全文手册改成
memory_admin(action="guide")按需取,用完即弃。 - 邻域注入改成「有上限、不碎缓存」(nebula 原来每轮把邻居关系塞进 system prompt):0.2.145 起挂在 pre-step 尾部、4 条封顶、块长 420 个字符,读过的不再带。它不再是纯省 —— 省 token 只是亮点,检索质量才是目的。
8 个工具
| 工具 | 干什么 | 关键参数 |
|---|---|---|
memory_remember | 写一条记忆 | content / level / project / keywords / importance / links |
memory_search | 检索(四种模式) | query / mode / k / limit / expand / id / memory_ids |
memory_read | 读一条(连邻居一起带出) | id / neighbors |
memory_update | 改内容/状态/关键词/归属 | id / content / status / keywords / importance / project / links |
memory_project | 一个项目的全景 | project |
memory_link | 星图连线:连/断/屏蔽/解释路径 | action / a / b / note / maxHops |
memory_dream | 记忆整理(封存本窗口) | — |
memory_admin | 运维面板 | action = home/stats/hygiene/sources/ingest/cost/links/guide |
七层:soul(AI 自身)/ user(用户与环境)/ rules(准则)/ fact(原子事实)/ lesson(经验)/ topic(一件事的来龙去脉)/ project(项目,含 overview/structure/decisions/quotes/ops/todo)。
安装
从插件市场
DSH → 设置 → 插件市场 → 索引源填本仓库的索引地址:
https://raw.githubusercontent.com/hanhan9999999999999999999/dsh-macro-memory/main/plugin-market/index.json
索引是 格式 1 的 JSON(plugin-market/index.json,随包校验:tools/check-market.mjs)。
国内网络拉不到 raw.githubusercontent.com 时,把索引源换成镜像(plugin-market/index.cn.json:与主索引逐字段相同,只有仓库地址带反代前缀,钉同一个 commit):
https://gh-proxy.com/https:/raw.githubusercontent.com/hanhan9999999999999999999/dsh-macro-memory/main/plugin-market/index.cn.json
实测(2026-11-19,本机):raw.githubusercontent.com / cdn.jsdelivr.net / cdn.statically.io 直连全部失败;gh-proxy.com 取索引 1.9 s、取图标 3.4 s。市场安装要 git clone,直连 GitHub 300 s 超时,走反代 23 s 拉完 164 个文件、checkout 到钉住的 commit 成功。
反代地址里的内层协议只写一个斜杠(
https:/github.com/...)不是笔误:宿主校验 git 源时要求new URL(v).href === v,写成https://会被压成/https://而被判「不是规范 URL」。
手动
# 1) 放进 vendor(或任意路径),装进 profile
cd <DSH_HOME>/vendor
git clone <THIS_REPO> dsh-macro-memory

# 2) profile 里登记(file: 协议,pnpm 不会在 install 时删掉它)
#    profiles/<名字>/package.json → dependencies
#    "dsh-macro-memory": "file:D:/dsh-home/vendor/dsh-macro-memory"

# 3) 只留一条 bundle
#    profiles/<名字>/cordis.patch.yml
- insert:
    - id: macro-memory
      name: 'dsh-macro-memory'
      config:
        homeDir: dsh-storage
        reflectTurns: 5
        promptLang: zh
        nebula: {}
必须关掉原来的 meow-memory 与 dsh-memory-nebula:本包 vendor/ 里是它们的内核,再装原包会重复注册工具与客户端 UI。
重启 DSH 生效(不是刷新页面)。
设置与热应用
设置页的每一个字段都真能写,而且写完就生效:
| 改的是谁 | 生效方式 | 要重启吗 |
|---|---|---|
融合层四键(compatAliases / guideMaxChars / toolWaitMs / flushThrottleMs) | 150ms 去抖后重建工具面与注入 | 不用 |
引擎字段(hitTopK / reflectTurns / homeDir / dream …) | 拆掉那只引擎重挂,再重建表面 | 不用重启进程,但扫描从头开始 |
nebula 段 | 同上,只重挂星图 | 同上 |
一个坑写在这里省别人一轮:宿主给的配置是 volatile 引用,引擎只认普通对象——把引用直接喂给引擎,它装不起来却不报错,只会表现成「工具都不见了」。所以引擎永远拿 resolveConfig() 解包后的普通对象。
兼容与迁移
- 老配置形状:
config.meow.{…}旧写法仍然认(根字段覆盖),启动时打一句 warn 点名哪些键被盖住。 - 老注入消息:注入来源
kind从plugin:meow-memory改成plugin:macro-memory,但老值仍认得(LEGACY_PLUGIN_KINDS)。历史会话里的折叠、锚点、重放不受影响——kind是数据契约,不是装饰。 - 老工具名:默认不注册
nebula_*/memory_find_similar/memory_home;需要时把compatAliases打开(19 个工具)。引擎输出里出现的旧名字会被翻成新名字,返回的记忆原文一个字不改。 - 不改用户数据:
.dsh/sessions里的历史消息不改写;旧库目录不搬,切homeDir只切指针。
它凭什么更强:每一句都有读数
这一节只放读数和对照。所有数字都能在本仓库跑出来(每段末尾写了是哪个脚本),跑不出来的不写; 读数是自建 gold 上的,不是公开 benchmark,边界也一并写在最后一小节。
数字的出处与时效:本节所有读数都是仓库回归闸门(
tools/probe-*.mjs),跑一遍就能复现,有效期跟着 commit 走。 端到端 LLM-judge 那类需要模型判分的数字不在这里——它们属于历史读数(最近一次是 2026-11-20 / omni3 / 0.2.x 时期), 口径、日期与「什么情况下才能重跑」写在docs/EVAL-CLAIMS.md。引用任何数字前,先看那张单子。本地 LoCoMo 检索 gold(2026-11-22,全程无 LLM):hit@5 0.6159 / hit@10 0.6953 / hit@20 0.7546、 recall@20
0.6822、MRR0.4953、nDCG@100.5029(1,536 题剔 category 5,固定 top-20,avg_retrieved 17.77、avg_context_chars 5947); 对照 2026-11-20 的 0.2.x 旧检索基线(avg_retrieved 19.99):hit@200.651 → 0.7546、MRR0.3768 → 0.4953、nDCG@100.3933 → 0.5029。 给得更少、命中更高;但这是命中率不是准确率,端到端 LLM-judge 自 2026-11-20 起仍未重测。 口径与复核命令见docs/EVAL-CLAIMS.mdA2。
一、检索准确率:自己出题、自己判卷
tools/probe-gold.mjs 拿真库造了一套 gold 语料:40 条做题干(层与状态都真,五层俱全,关键词平均 9.3 个,
不是全 fact 的假样张),对每条写一道照抄问句(直接问这句话在说什么)、14 道换说法问句
(刻意避开正文用词,人真会这么问的样子)、9 道时间锚问句(自带版本号或日期)。每题指定一个 want,
判卷只看 want 排第几——不看分数高低,分数没有跨题可比性。
| 档 | 窄池(40 条) | 宽池(146 条) | 宽池 MRR | 闸门 |
|---|---|---|---|---|
| 照抄(44 问) | hit@1 1.000 | hit@1 0.977 · hit@3 1.000 | 0.989 | ≥ 0.93 |
| 换说法(14 问) | hit@1 0.929 | hit@1 0.929 · hit@3 1.000 | 0.952 | ≥ 0.71 |
| 时间锚(9 问) | hit@1 1.000 | hit@1 0.889 · hit@3 1.000 | 0.944 | ≥ 0.70 |
宽池是真宽:146 条里有 106 条只该当噪音,宽池的「前 5 条结果序列」与窄池有 40 处不同、 宽池独有条目进榜 38 处——不是把 40 条原样跑一遍再声称 146 条。 「换一说法还能不能找到」这一档是故意做难的:问句里没有任何一个正文词,全靠同义词桥与关键词字段接回去。
二、每一把刀都有「关掉就掉」的对照
单项机制的贡献不是估的,是把那个开关关掉再量一次:
| 机制 | 关掉 | 开着 | 说明 |
|---|---|---|---|
| 同义词桥(18 组动作表) | 换说法 0.714 / 0.786 / 0.738 | 0.929 / 1.000 / 0.964 | 照抄、锚点各漂移 0 条(只抬该抬的那一档) |
| 时间锚(问句自带版本/日期) | 0.977 | 1.000 | 非锚问句漂移 0/53(不该动的没动) |
| 关键词加权(抬到平台,不是捏一个点) | 锚点 0.778 / MRR 0.889(旧口径) | 0.889 / 0.944 | 抬过头照抄掉到 0.977——平台比顶点稳 |
| 缘由/现状折价(0.2.179) | 照抄 0.955 | 1.000 | 0.2.180 把折价也乘进分档后,换说法 0.857 → 0.929 |
| 覆盖度 + 协调因子 | 分差 29.10 | 分差 33.64 | 幂次旋钮能把分差再拉到 34.50 |
| 关键词当正文(降成普通词) | 1.000 / 0.857 | 1.000 / 0.929 | 关键词只该是字段,不该稀释正文 |
最后一行是反例对照:如果「把 keywords 拼进正文」更好,说明字段设计没意义;实测更差,所以它只是字段。
三、重要度、层级、状态:先验不是摆设
importance=4的乘数是 1.75×、importance=1是 1.00×;把乘数抹平,同一条记忆的分数从 1.31 掉到 0.748 (tools/probe-recall.mjsR2,两条阴性对照:抹平后确实掉、且按时间排序会给出错误的旧条)。- 分层检索不是「谁层高谁先」:问「为什么封存」去叙述层(project/topic)取答案,问「该怎么做」去规矩层(rules)取;
规矩条在缘由句里折到 0.6、在现状句里折到 0.3,普通问句一刀不切(
probe-goldG28 量的是比值 0.600 / 0.300,不是名次)。 - 排序是两套秩序:先分档(证据硬不硬)、档内比分数。折价必须同时乘在「分档用的
_raw」和「排序用的score」上—— 只乘分数时,把那条压到 0.1 它照样排第一(0.2.179 踩过这个坑,INTERNAL 9.187 有实测)。
四、速度:1200 条库 3.3ms
| 库规模 | p50 | p95 | max |
|---|---|---|---|
| 40 条 | 0.1ms | 0.3ms | 0.6ms |
| 400 条 | 1.0ms | 2.1ms | 3.2ms |
| 1200 条 | 3.3ms | 6.1ms | 9.3ms |
- 闸门是 p95 ≤ 20ms(0.2.153 之前是 121.8ms——那版每次检索都重扫全库)。
- 规模 ×3 时耗时 ×3.16,守的是「别出现平方级」,不是「线性就不管」。
- 指纹缓存:同一张库连问,开缓存 292.6ms、关缓存 5,037.3ms(17.2×),而 45 问的答案逐位相同—— 缓存只许省时间,不许改答案。缓存有上限(最多 4 张库),改一条记忆指纹立刻变(连「等长改写」都认得出: 「蓝绿切换」→「红黑切换」同为 17 字,分数 0.432 → 2.079)。
五、省下来的 token 是真省
| 项 | 数值 | 闸门 |
|---|---|---|
| 常驻注入 | 1,235 字符 / 1 段 | ≤ 1,400,余量 165 |
| 工具 schema(8 个) | 原始参数 4,714 B;宿主投影后 13,567 B | 投影 ≤ 16,000 |
| 工具整字面量(含 render) | 107,583 B | ≤ 110,000 |
memory_search 单项 schema | 6,851 B | ≤ 7,500 |
| 每轮固定开销 | 约 2.2K token(融合前 14–16K) | — |
回执也不白花:超过 500 token 自带成本尾注,超过 1,200 token 会建议给 budget;
budget 五路都吃(本地 / 星图 / 补邻居 / 相似 / 读),砍的顺序是「先砍每条的字、再砍条数」,
并且每砍一刀都写清砍了什么——装不下时给的是实测最小值,不是估的。
六、自证:3,511 条可执行断言,少一条判红
| 自检支数 | 30 支(1 支 verify + 25 支探针 + 4 支契约/体检) |
| 断言总数 | 3,511 条,全跑约 220 秒 |
| 基线 | tools/baselines.json 记下每支的条数与耗时上限 |
| 反面证据 | 每支都带阴性对照:机制删掉、判据要能红。删了还绿,那条判据就是注释 |
30 支覆盖:检索融合、星图、宿主装配、客户端 UI、判据覆盖审计、参数审计、工具体积、工具面、词表、 召回、合并、去重、相似、面板账本、gold 准确率、成本、客户端 bundle、注入、YAML、市场索引、加载面、星图面板、 查询分解、写入端巩固、写入端通胀体检(自证率 / 召回闭环 / 层通胀)、自动取代(五类硬事实 / suggest 只建议)、 实体层与动态跳数(四类硬事实 / 层不进图 / 第二跳按词面收 / 硬边照走)、 共现自学习扩词(词源取 keywords / 同条 2 跨文档 1 / 三道门 / 库越大越连得上)、体检。
断言数写进基线之后,「改坏」不再靠人发现:少一条、慢一截、读数掉下闸门,都会在 check-all 里变成红。
七、不说满的地方
- gold 语料是自建的 40 条样张 + 45 照抄 + 14 换说法 + 9 时间锚,池子最大 146 条。它证明的是「机制有效、改动不伤老题」, 不代表任何公开榜单的名次。
- 换说法 0.929:14 题里错 1 题;宽池另错 1 题。错的那题问「自动筛掉结果时要不要给接班的那条开个小门」, 想要的是「例外/破例」那组,靠同义词表接回来了,但排序上仍可能被更强的规矩条压一名。
- 时间锚 0.889:9 题错 1 题,那一题的 gold 本身偏严(被选中的 topic 条正文开头就是「评测线为什么封存」, 其实答得更准),这条没有为迁就 gold 去改引擎。
- 同义词桥是中文动作表(18 组),不做跨语言同义;库里英文条目靠 BM25 原样匹配。
质量:怎么证明它没坏
node tools/check-all.mjs          # 30 支自检,3,511 条断言,约 220s
node verify.mjs                   # 单支:宿主契约 + 浏览器装配
node tools/doctor.mjs             # 体检:两棵树字节一致、加载面、注入长度、队列、账本
-
30 支自检 / 3,511 条断言,全部可执行,覆盖:宿主装配契约、真 vendor 端到端联动(含星图缺席降级)、真 meow 库 + 真 nebula 引擎的节点/边/生命周期、真 cordis + 真 ToolsService + 真 SystemPrompt、浏览器侧 UI 注册、17 个原工具 → 8 个统一工具的参数级覆盖审计、查询分解量尺(20 题双实体:切开 20/20、原榜前 3 不动、救回 1 题)、写入端巩固量尺(桩 flow 数调用:
off不发检索 /suggest不写库 /write恰多 1 条)、写入端通胀量尺(九类体检同序 / 自证率与层通胀的阳性与阴性对照 / 真 sqlite 数read_count——检索不冒充读、老库自动补列)、自动取代量尺(五类硬事实 / 两道门槛分开 /off零检索 /suggest一个字不写库 /apply才标 stale / 人点名的不重复建议 / 与 meow 判据同结论)、17 个原工具的清单与 schema 体积(render 闭包另设粗胖线)、工具账本(每个脚本有归属)、口径总账(手册/schema 常量/对外文案同源)、召回校准(相关度优先 + 重要度进分数 + 相关度下限 min_rel)、合并账本(关键词并集 / 归属不搬 / 变短默认不换 / overwrite 才换)、跨层重复(写时点名另一层 / 检索折叠逐字级重复 / dedupe: false 看全量)、相似检索(基准与候选同一把尺子 / 本会话刚写的也算候选 / 端过的不再端)、两把尺子(相似度 cosine 与逐字重复度 Jaccard 并报 / 与写侧合并判据同源 / 长文嵌一句要点名)、记忆体检口径(「相似 N」是稀有词签名估算、判「同一句存两层」看 repeat、两把尺子靠一句口径说明指路)、dream 重复对(整理清单里点名逐字重复的对子 / 没对子一个字不加 / 短 id 在清单内互不撞前缀)、dream 跨轮次重复(同一句话一条 fact 一条 topic 也点名 / 一对只说一次 / 半边标「另一组」并说清怎么处置)、dream 重复详写(短摘录 + 长详写也算同一件事 / 覆盖度 ≥90% 且短条至少 8 个词 / 与逐字重复块互斥不重复点)、dream 合并处方(每个重复详写对下面点名短条里长条没有的词、最多 6 个 / 无损时明说「没有长条之外的词」/ 三把尺子各管一段:重复合并、相似不许合并)、dream 整理留痕(回执先说这一轮看到几轮几条 / 几对逐字重复 / 几对重复详写 / 几个词要补;收尾把同一份数字写进 dream_log 的 changes.plan 与 summary;念完即清 meta,下一轮读不到旧账)、整理留痕面板(memory_admin(action="dream")照账本念,不现算;没工作区 / 还没建库 / 库读不开 / 账本为空四种来路各说各话;0.2.96 之前的老记录明说「比 0.2.96 早」,不冒充有规模)、整理走向(每条账带#k序号与「落库 是/否」,末尾一行趋势给最近几次的重复对/缺词合计与「在变多/在变少/持平」;可用记录不到 2 条不出这一行,不到 4 条自带「样本太少别当走势」,老记录跳过时点明几条没参与),都含阴性对照、整理中那一轮(dream 正在跑时面板第一行就报这一轮多大——规模读的是dreamdigest,不是账本;不给这轮编#k、也不进趋势;只有 lease 活着才算「进行中」,lease 一放掉第一行立刻消失;只有 lease 没有摘要就说「规模还没落 meta」,不拿当前清单现算;SSE 的dreaming事件同时带上这份规模,老消费方只认state照样工作)、整理留痕的翻页与单条展开(账本长了要能翻:page从 1 起、编号「第几近」跨页连续、总数来自COUNT(*)不是本页条数、页越界退到最后一页并说清;id摊开某一条的摘要 / 备注 /changes原文,超长截断并报真实长度,老记录明说没有规模,坏行只说读不出来不拿摘要凑;page/id给脏了当面打回,不静默退回默认;趋势与「整理进行中」只在第 1 页出)、账本按项目段翻账(changes.plan.projects以前只被数了个数:第 1 页没筛时多一行「项目段:Alpha 3 次 · Beta 1 次」,只列前 5 个并说「还有 N 个没列」;project=筛在 SQL 里做(json_valid+json_each),页面与总数共用一个筛子,坏行不许算成匹配、也不许带崩整本账;筛着时不再给分布、编号明说「是筛出来这几条里的第几近,不是全账本序号」,导航写「共 M 条(项目段「X」)」;筛空说「账本里没有项目段「X」的整理记录(全账本 N 条)」而不是「账本还是空的」,并点明项目名要按原样写;展开时补一句属于/不属于这个项目段,编号仍是全账本第几近;project给成长句当面打回;写侧存名字不存个数——changes.plan.projects从 0.2.102 起是真名字(trim / 去空 / 去重保序),个数另存projectCount,老账本照个数念而不念成 0;changes.plan.pairs把「跟谁撞了」也落账(短 id 与整理清单同一套,能直接memory_read/memory_update;cover带「合并会丢哪几个词」),一条账最多存 6 对明细,而「这一轮共几对」是真数不被上限截断;老账本「有数无明细」与「真没撞上」分开说)、账本记库规模(开工那一刻按层数一遍status = 'active'的条数,写进changes.plan.store:只数在用、零层不写进 JSON、收尾不再数;面板展开多一行「库规模:开工时 N 条在用(fact 1 · lesson 1 · topic 1)」,老账明说「它写在 0.2.103 之前」且不许念成「0 条在用」,没有 plan 的账不再叠一层告示;趋势行给「库 开工时 2 → 3 条(多了 1 条)」,至少两次有数才敢讲,缺的几次单独提示「库规模只有 K 次有数」;探针 L9–L11 用真库验写侧数字、D37–D39 验面板真念,含「老账不补 0」「无 plan 不叠告示」两条阴性对照)、账本行的稳定引用(#k是位置、会随新账往下挪,r<N>是这一行自己的号:dream_log.id是 AUTOINCREMENT,只增不减、删了也不复用,所以r128永远指同一轮整理——面板每行末尾印· 引用 r<N>(老账行也印,否则最早的几轮永远回指不了),第 1 页只说一次「要回指就用id=r<N>,#k只是此刻排第几」;id=r128按引用展开,正文照账念、另起一段说「它现在排第 K 近」,引用打不开时明说「这个号从来不会发给新账」并给按位置找 / 按内容搜两条路;「第几近」那条路也顺手回一句引用,省一次翻列表;dreamRankOf与账本列表共用一把尺子(run_at相同再比 id),否则引用和编号会静默指向不同的行;探针 L12–L14 用真 writer 验「再跑一轮:第几近 1→2 而runAt不变」,D40–D42 验面板真念,含「ref=0 不猜行」「每页都印提示」两条阴性对照)、账本按日期筛(run_at是毫秒、人说的是日期,中间这座桥现在有了:since/until写"2026-11-18"这种日期,闭区间——当天00:00:00.000与23:59:59.999都算在内,前 1 毫秒后 1 毫秒都在外;本机时区——按new Date(y, mo-1, d, …)解并回读年月日校验,绝不用Date.parse(那是 UTC,东八区整体错 8 小时),2026-02-31这种被 JS 滚到下个月的写法当面打回「这种写法不敢猜」;行与总数同一把筛子——筛留在 SQL 里,recentDreamsPage与dreamCountOf共用一份parts,否则翻页漏条、条数虚高;since > until也打回,且打回发生在第一次读库之前。筛空时说「这段时间里没有整理记录——账本覆盖 A → B(本机时区 UTC+08:00)」并报「全账本 N 条都在这个区间外面」,不把「这段里没有」说成「账本里没有」;展开一条时补一句它不在区间里(写在几点),引用照旧展开、明说「日期筛选也不影响引用」;只按项目筛时老句式一字不变,日期是加上去的一层。探针 L15–L17 直接插run_at量边界与覆盖范围,D43–D45 验面板真念,含「旧账不混进来」「坏日期一次库都不查」两条阴性对照)、账本记整理前后的库规模(只念开工那一眼,永远算不出「这一轮让库变轻还是变重」:finalizeDream收尾时再数一次dreamStoreScale(db)落进changes.plan.storeEnd,并算出storeDelta = 收尾 - 开工,只在两个点都有数时才算——老账没这一格就不猜,不拿NaN或负数当 0;收尾数只能在写侧取,面板渲染时库早变了,重算出来的是「看账那一刻」而不是「整理结束那一刻」;落库日志补store=A->B,summary上就能对账;面板展开念「库规模:开工时 2 条在用(fact 1 · topic 1) → 收尾 3 条在用(fact 2 · lesson 1),比开工多 1 条」,老账只念开工一眼、不编收尾也不补 0;差与因分开写成两句——storeDelta是「库变了多少」,stamped才是「这一轮封存/完结几条」,口径句明说这一点;趋势行补「收尾净增/净减 N 条(K 次有收尾数)」,缺收尾数的账不参与合计但要说几次;文案上把两层括号叠在一起的(fact 1)(-2)改成「层数进括号、差进句尾」,趋势 caveat 也改用破折号。探针 L18–L20 真开工→中途加两条归档一条→两次advanceDream真收尾(store=2->3、delta=1是净变化不是新写条数、归档层不进收尾层数、老账两个字段都是undefined),D46–D48 验面板真念,含「只有开工数不编收尾」「不叠两层括号」两条阴性对照)、账本分清收尾方式(以前只记「这行摘要怎么写」、记不住「这件事怎么结束的」:window dream (done|aborted):里那一个词既是数据也是文案,changes里没这一格;groups只有分子没分母,「走了 1 组」说不出本来几组;补记账被念成「这条记录比 0.2.96 早」;连续失败止损封存只写调试日志、账本上等于没发生过。现在写侧落结构化changes.kind五态:done/aborted(带groupsDone+groupsTotal,摘要印groups=1/2)/recovered(带groupsDone)/gaveup(带fails)/sealed(带fails,首次进账本),groupsDone取groupsCount - 1因为abortDream传的是「进行到第几组」;分母必须在finishDream删dreamplan之前读(收尾动作自己就把账要吃的数据删了);sealed与dream-debug.log两处都写、不互相替代(一个给排查、一个给回看)。读侧kindOf优先认changes.kind(stored: true),认不出才退回摘要首词并明说「这一格是认出来的」,缺值是null不是 0(「走了 0 组」是假话);reasonOf跳过(interrupted)/(turn-failed)修饰语;行上与展开各念自己的话(走了 1/2 组就停下、收尾方式:连续失败已封存(连续失败 3 次)),只有真老账才念「比 0.2.96 早」,没跑完的轮在规模段与对子段两处改口;趋势与「比更早一条」只吃跑完的一轮(半轮的dup/cover/missing是扫到那儿的中间值,加进合计等于把半张成绩单当满分算),趋势另说「K 次没跑完,不进合计」,比对遇到半轮只回「数字不可比」。探针 L21–L24 用真引擎验四种收尾——sealed/gaveup都先touchWindow钉住last_event_time,否则recordDreamFailure每轮凭Date.now()开新范围、失败次数永远从 1 重数;D49–D53 + D11b 验面板真念,含「补记账不冒充老账」「半轮不比数字」两条阴性对照)、层走向(总条数的净变化只说「库重了多少」,说不出「哪一层在膨胀」:fact 一直涨、topic 一直掉,总分可能是 0 而库的结构在烂——一轮把 2 条 topic 降成 fact、lesson 掉一条、fact 涨两条,账本念「比开工多 0 条」,读的人松一口气。现在每轮收尾时的storeEnd.byLevel摊成一条走向:只认收尾层数(0.2.103~0.2.105 只有开工数,拿它占位等于把整理前的库贴到整理后的位置上,图整齐但全是假的)、写侧零层不写进byLevel所以「写了却没有那一层」= 那轮那层 0 条在用(缺 ≠ 没记,这句写进口径)、只吃跑完的轮(半轮的层数是扫到那儿的中间值);每层念fact 2 → 3 → 3(+1)/topic 0 → 1 → 2(+2)/lesson 1 → 1 → 1(没变),按变化幅度排序只列 4 层(多的说「还有 N 层没列」),结论分涨/掉/都没变三支——没涨就不许编「涨得最多的是 fact(+0)」,那是把噪声讲成走势;少于两轮不出(一次是快照,不是走向),只在第 1 页出(它说的就是最近这几条)。探针 L25–L26 验写侧尺子按status='active'数、归档立刻掉出、零层不出现(两条 fact 的内容与关键词要刻意错开,否则写侧去重会把它们并成一条),D54–D57 验面板真念,含「单轮不出」「每层没变就说没变」两条阴性对照)、回执成本与预算(以前只说「查到了什么」、从不说「这一趟花了多少」,于是省 token 全靠调用方猜k——给多了怕漏、给少了怕不够,最后总是给多:回执够大(≥500 token)时代价自带一行「≈N token(CJK 一字算 1、其余 4 字符算 1,是量级不是账单)」,1200 token 以上才缀「只想看骨架就加 budget=400」,小回执一个字不加;budget=N让工具自己收紧——先砍每条的字(content_max减半到 60)、再砍条数(k减半到 1),每级都真改参数重查而不是截字符串(截断等于把一条记忆拦腰砍断,读者看到一句没有下半句的话,工具还说「收紧了」,那是骗人),装下就交代「收紧了 N 次、k A→B、content_max A→B」,四级之后仍装不下就真取一次k=1、content_max=60的最小一份并写「实测」,不拿第四级的估计冒充最小;收紧排在星图段之前(顺序反了等于把邻居段落加在预算外,尾注说「按 400 收紧了」而回执仍超),星图退回本地兜底的两条路也照收;预算四态分开说(没给静默 / 不是数字 / 小于 80 / 超过 20000 按 20000 算),给了却没生效绝不静默,星图 / 相似两路明确说「体量由引擎的 limit / chars 决定,这次没缩」。探针 L27–L28 钉估算口径与预算四态(含可复算),D58–D61 钉出口收敛与「装不下」两条阴性对照)、预算贯通四路(budget从「本地检索的参数」升级成「这次回执的约束」:本地先砍content_max再砍k、星图先砍limit再砍hops、补邻居先砍chars再砍limit、相似先砍content_max再砍k,顺序都是「先动只是少看一点细节的,再动真会少看到东西的」;预算传进来是对象,入口先摊成数字再比——拿对象比恒 false,会一路滑到「装不下」还印出「预算 [object Object]」;只报真动过的旋钮(hops 2→2等于谎言),报「最小」之前把所有旋钮压到下限再量一次;本地expand的扩散段按remain = budget - 本地那一段算,剩余不够就不拿并告诉读者两条出路;尾注不再声称「只有本地能收紧」。探针 D62–D66 钉四路各自收哪个旋钮与「装不下要量到下限」,D61 改成「没给预算就不缩也不说废话」两条阴性对照)、项目走向(层走向只说「哪一层在涨」,说不出「是谁在涨」:Alpha 加 3 条、Beta 删 3 条,fact 的净数没变,层走向念「fact 没变」而实际上一个项目在长肉、另一个在被清空——所以按项目再摊一条走向:只数带项目归属的 5 层(project/fact/lesson/topic/rules有project列,soul/user只有COMMON_COLS没这一格,口径句里明说,免得读者拿总条数一减以为 soul 的条目丢了)、跨层同名相加(读者问「这个项目多大」,不是「它的 fact 多大」)、NULL 与空串不算一个项目(否则每个全局条目都变成一个叫null的项目)、一个项目都没有时整格不写(空对象落进 JSON 会被读成「数过,零个项目」)、只认收尾那一刻的storeEnd.byProject(0.2.111 之前的账没有这一格就不进走向,不补 0 让线看起来连续)、名字按写入时原样存所以改过名的会算成两行(口径句明说,不偷偷猜改名)、三支结论涨/掉/都没变——没涨就不许编「涨得最多的是 Alpha(+0)」,那是把噪声讲成走势。探针 L29–L31 用真库验跨层相加、全「全局」库不出现空名、归档后整个键消失,D67–D70 验面板真念,含「单轮不出」「每个项目都没变就说没变」两条阴性对照)、读也吃预算(read 是唯一一支回执里带「caller 点名要的东西」的工具,所以它不能像别的工具那样砍内容:正文一个字节都不截,能缩的只有邻居条数——给了budget就先从你要的条数往下试 6 / 3 / 1 / 0,每档都真取一次真量一次(估算与真实体量之间没有稳定比例,最多试三档,且绝不超过你自己要的数),装下就写「邻居 12→6 条才装下」;一条邻居都砍光了还装不下,就只给骨架:正文第一行(≤120 字)+ 缺口与三条出路(正文共多少字≈多少 token / 你给的预算是多少 / 把 budget 提到 ≥ 体量,或者先memory_search看摘要挑一条),因为「截一半给你」比「不给你」更坏——读者会把半条当成全文;连骨架那一行都超预算时再加一句「连上面那一行标题都超过你给的预算了」,宁可超几点 token 也不让形态被误认。尾注自己也要装进预算:砍过邻居必须交代(优先于预算),没砍就只在装得下时才加这一行;budget给的不是数字或比 80 还小时照不限额给,但那句话一定带出来。探针 D71–D77 钉骨架不调星图、砍邻居真发生、装得下只问一次、neighbors=0不问星图,含「非数字照给不限额」与「骨架那行也超预算」两条阴性对照)、项目走向的时间信息(净差只说「变了多少」,说不出「第几次才冒出来、哪一轮归零」:Alpha 3 → 4 → 6(+3)里看不出它是第三次才出现、也看不出 Beta 从第二次起就没了——所以每个项目多两句点名,firstLive找第一个大于 0 的位置念「第 N 次起有数,现在 M 条」(第一格就有数的是「一直在」,不许当新出现;数组下标 0 要换成人读的第 1 次),lastLive倒着找最后一个大于 0 的位置,若它后面还有格子就念「第 N 次是最后的数:M 条」——报最后一次的数,不重复写「现在 0 条」;两类各最多点 3 个,多的写「还有 N 个没列」,两种同时出现时补一句「一存一失如果条数对得上,很可能只是改名——这条走向不替你猜,要确认就翻那一轮的账看项目段名字」,因为改名与「清空一个另起一个」在条数上一模一样,区别只在内容;序列本身也要省——compactSeq在超过六轮(SEQ_HEAD 2 + SEQ_TAIL 3 + 1)时折成「头 2 … 尾 3」,阈值卡在「折一次至少省掉两个数」,否则省略号比它省下来的还长,折了几次必须报数(序列太长,中间 3 次用 … 省略),不然省略号会被读成「这几次没数」;顺序固定为抬头 → 序列 → 涨/掉/都没变 → 新出现 → 消失 → 改名线索,caveats 另起(还有 N 个项目没列 → 折了几次 → 没跑完的轮 → 常驻口径),先「看到了什么」再「没看到什么」。探针 D78–D82 验八轮折叠、新出现点名、消失点名、改名提示三要素,含「平稳走向不加戏」阴性对照)、疑似冲突(关键词至少共用两个而数字/版本不同 / 不合并不自动改 / 计数与明细分开 / 0 与没查分开)、冲突跨轮追踪(往回翻十条账认老账 / 新报与重提分开 / 连报三次点名催处置 / 读不到就不表态)、冲突去向(上一轮报的、这一轮不报了——已归档 / 正文改过 / 查不到 / 两条都没动过四种去向分开说,一次只摊三对)、取代关系(写新的同时把被顶掉的旧的降格:memory_remember加supersedes,旧条目只标 stale + 正文留一句「(已被取代:<新 id>「<新内容前 24 字>」,日期)」,不删、还读得到、可改回 active;找不到 / 已归档 / 已标过 / 短 id 多命中 / 写库失败五种「像成功」的失败各说一句,一次最多 5 条、超出的原样报回、来源一行(读一条记忆时一并念出来路:整理封存 / 会话直写 / 老库迁移 / 没记来源会话,外加被读过几次、有没有被主人纠正过;四种来路不许合成一句,近似要写明「那次整理里封存」,读元数据不许顺手 markAccessed,没库 / 没工作区 / 找不到这条时一个字不写且不替你建空库))、检索融合(本地检索与星图扩散两路名次合成一张榜 RRF k=60:同一条只占一个位置、三种来路分开说、两路都命中的排最前;本地命中带全文、星图独有只带「为什么相关」+ 摘要;截断报「另有 N 条没展开」;预算紧时先砍星图独有那几条;本地零命中 / 星图回执解析不出 / 预算装不下都退回原来的两段式,不硬凑半张榜)、准确率量尺(40 条真实样张 × 45 条自然问句,hit@1 / hit@3 / MRR 三档聚合 + 两次阴性对照 + 可选稠密层的三态与「拆掉它逐位不变」)、注入体、加载器判据、组合产物、YAML 接线、市场索引、体检。 -
按句改 + 改前留一版(0.2.157):
memory_update只改一句不必重发整段正文——patch: [{find, replace}]的find必须唯一命中,0 次(这版正文里没有这段)与多次(定位不到唯一一处)都一个字都不写并把理由原样说出来;append在末尾补一段(空行分隔);改完比原文短三成以上且没带allowShrink: true就拒绝写(防「按句改」变成「整段删」,40 字以下短文本不设闸);写之前把旧正文留底(同一条最多 3 版、逐字相同的旧正文不重复记、没库不建表),restore: 1退回到改之前那一版,退回时把当前这版再留一次底——退回去也是一次可退的改动;来源一行顺带念「改过几次(最近什么时候)」,只在真留过底时出现。四个参数只在融合层消费(vendor 的 schema 是additionalProperties: false),不进pick白名单。 -
星图面板层:引力可调 + 局部图 N 跳 + 标签随距离淡出(0.2.158):三维星图多了两组控件,零 token——面板是 iframe 里的静态文件(
host/http.js按文件服务),工具 schema 与常驻注入一个字节没动,改完刷新即生效、不用重启。引力四个滑杆(斥力 1200–20000 / 弹簧长度 30–200 / 项目向心 0–0.08 / 阻尼 0.6–0.96):拖动只改数字、松手才重排(每像素触发一次收敛就是把画面卡成幻灯片),参数存localStorage的nebula.force;改完先丢掉那份缓存的布局再收敛,否则滑杆动了画面纹丝不动;默认值只有一份(读渲染器导出的FORCE_BASE),渲染器尚未加载时的那份兜底镜像由探针逐位比对,漂了当场红。局部图滑杆 0–4 跳:以选中的那颗星为中心只留 N 跳以内的邻居(neighborhoodIds是纯函数,0 跳=回全图,回全图传的是null而不是空集合——空集合的意思是「什么都别画」),没选中就拖会说一句「先点一颗星」;裁剪只在visible()这一处收口,检索、计数、导出照旧吃全图,「看得见」和「算得到」不打架。标签原来只有簇名:现在悬停/选中的那颗永远写名字,其余按重要度→度数取前 14 颗,透明度随相机距离在 1100→1900 之间线性淡出(离散阈值会在缩放时「啪」地跳一下),长标题截 18 字。三个纯函数与面板共用同一份实现,tools/probe-nebula.mjs在纯 window 沙箱里真跑一遍边界值。 -
时间锚:问句自带版本号/日期,就按那一刻排(0.2.159):问「0.2.146 加了什么」,答的该是那次的记录,哪怕它现在已经 stale——可打分器一直按「今天」折新鲜度与状态,于是正解被乘了 0.6 挤到第二(实测 bm25 只差 0.015,是折扣定的胜负,不是证据)。现在问句里出现
0.2.146/2026-11-21/2026年11月就认一次锚,逐条看该条正文/标题/项目里到底有没有那个日期,有才免这两样折扣:词分、覆盖度、分档一个都不动,status也不会被洗成 active(免的是排序折扣,不是「它没过期」这件事实)。读数:照抄池 45 问 hit@1 0.911 → 0.933、MRR 0.944 → 0.956,换说法池三项不变(口径只补时间不补词汇),锚点组 10 问 hit@3 1.000,代价是「2026-11-21 之后主线停在哪一版」这类区间问句从第 1 滑到第 2(仍在 hit@3 内,已知边界)。开关是search(q, docs, { timeAnchor: false }),探针里就靠关掉它变差来证明这条判据没白写。请求前缀 0 字节。 -
稠密只补盲区,不并列投票(词法不想说话的时候才轮到它)(0.2.166):词法这一族量到平台之后,剩下的错分几乎都是「词面根本没沾上」——真库换说法池里 7 道没进 top3 的题,榜首覆盖度全在 0.072–0.142(命中题中位 1.00),而同样的题稠密向量能把其中两道直接顶到前两名。先试了 0.2.154 的老路(并列 RRF 融合),全面变差:词法 0.798 的换说法池掉到 0.738、锚点 0.883 → 0.825、真库自找 0.997 → 0.954——通道之间不是「多一票更民主」,弱的一方只会给强的一方加噪,旧结论的正确性绑在当时的词法能力上。改成先量「它自己承认不行」长什么样:查询 top1 的覆盖度 <
DENSE_RESCUE_COVER = 0.2才允许稠密介入(复用 9.171/9.172 同一个覆盖度,不另立阈值),词法前DENSE_RESCUE_HEAD = 4名原样不动,其后按余弦重排且DENSE_RESCUE_COS = 0.45以下不进来,词法找到的尾巴按原序接回末尾(兜底不许把已有的弄丢)。零损失形态:hit@1 与 hit@3 一条不动,top5 三池各 +1——照抄 44 → 45、换说法 13 → 14(MRR 0.798 → 0.810)、真库换说 11 → 12(0.524 → 0.538),真库自找 149/150/150 不动,五池 233 题没有一题变差。验收时抓到一个设计错:第一版只在低覆盖时 rescue、其余仍走 RRF,于是「装了模型」这件事本身就改回执(真库自找 149 → 138);改成词法有把握就闭嘴,老融合保留成显式开关denseFuse: true——能力不砍,只是不再默认。四道门都可收回(denseRescue: false/rescueCover: 0/rescueHead/rescueCos),收回后与没有这个功能时逐位相同;没装模型时整条路径一次都不触发。探针 G24 九项判据 + 四条行为 + 阴性对照,验收块 HZ 七条。 -
同一串字,有时是坐标,有时是主语(0.2.178):真库里问「0.2.148 的时候基线收敛了两轮吗」,答案那条词分 22.29 却排第 2,被一条词分只有 8.54 的「0.2.148 已交付」压住——赢的不是词,是
bandize()里的 -1 特权档:谁把版本号写进 keywords 首位,在任何提到 0.2.148 的问句下都排第一。这一版把「时间状语里的标识符」判成坐标:档位、词分加成、加法补分三条路一起关(只关一条会被另两条顶回去);判据只认结构词(的时候/那会儿/当时),泛时间词一个都不许进。宽池时间锚档 0.778 → 0.889,照抄/换说法/真库三处零漂移。同轮试了因果证据、长度封顶、新鲜度不看重要度三个机制,读数全部否决,三道否决记录进文档——否决也是产出。 -
0.4.0:先把账算清,再动检索和写入两头(0.4.0):这一版七件事,全部带读数、全部有回滚开关(另有一次 2026-11-22 的本地 LoCoMo 检索重测:不算这一版的功能,但读数记在
docs/EVAL-CLAIMS.mdA2——hit@200.651 → 0.7546、MRR0.3768 → 0.4953,全程无 LLM)。①口径单——新建docs/EVAL-CLAIMS.md,把「现在能引用的」与「已过期不得当现状的」分成两张表:表 A 是仓库闸门读数(30 支自检 / 3,511 条断言 / 两棵树 181 个文件字节一致),表 B 是 2026-11-20 那次 LoCoMo 端到端(71.95、recall@20 0.672 等),表 B 一条都不许当现状引用——2026-11-20 之后检索层又动了上百个版本,这期间没有重跑过端到端评测。②查询分解(multiQuery,默认off)——复合问句按「跟 / 和 / 还是 / 哪个」切成 ≤3 段子查询,各补 ≤2 行到原榜尾部;原榜前 N 名一个字不动(append-only 是硬约束,不是优化项),所以这条改动能给的收益是「召回别漏」而不是「名次变好」:20 题双实体实测切开 20/20、救回 1 题、hit@30.900→0.900(数学上不可能涨,补充只落尾部)、命中率0.950→1.000、MRR0.777→0.784、延迟 p500.13→0.39ms;gold 四档两态逐题相同,即「关了没损失、开了没退化」。③写入端巩固(consolidate: 'off' | 'suggest' | 'write',默认suggest)——写记忆时按三个信号判断这批材料该不该收成一条事件摘要:同项目关键词交集 ≥2 的近 7 天 ≥3 条(重复模式)、该层语义条目 < 8 条(慢路有空位)、这批里还没有巩固句(未巩固)。suggest只把材料端给你,一个字不写库;write才落一条topic摘要并在被合并条目尾部加一句(已巩固进:…)——status一个字不动,巩固不等于作废。判据是「桩 flow 数调用」而不是「看回执好不好看」:off零次检索且回执逐字节不变、suggest两次检索零次写入、write恰多 1 条。顺带修掉一个真退步:巩固检查的两枪检索带internal: true,不写「本会话已端给你看过」的账、也不抬召回次数——否则写完一条紧接着问「跟这条像的有哪些」会得到「候选一条都没有」。④写入端通胀体检——memory_admin(action="hygiene")从六类扩到九类,新三把尺子都量比值(绝对量得跟「库里应该有多少条」比,那个数没人知道):selfecho关键词自证率(keywords里有多少逐字出现在正文里,>0.7 报——那些词靠 BM25 本来就能命中,等于没扩召回面;关键词少于 3 个不判)、unused召回闭环(命中过却一次没读过:为此在memory_read路径上新记一个read_count,只加在读路径,不加在检索路径,否则「排进候选」会被当成「被读过」;老库从 0 起算所以刚升级会偏大,这写进了 hint)、inflate层通胀(近 30 天fact条数 > 结论层 3 倍就报「写得多、收得少」,6/2 恰好 3× 不报)。memory_read同时多一句抬头:正文里有巩固句时先说「这条是历史材料,没作废,但要看现在的口径读那一条」——巩固是归档(status不动),与取代的退位(status变 stale)必须分开说。⑤写入端自动取代(autoSupersede: 'off' | 'suggest' | 'apply',默认suggest)——meow 早就会认「同一件事的另一种说法」,但只印一句提醒,标不标 stale 全靠人;而长期库里最伤的不是「有条过期的」,是旧结论冒充现状。这一版把「判」与「处置」接起来:判据只吃五类硬事实(版本号不同 / 日期不同 / 状态词反转 / 同一单位的数值不同 / 同一文件名换目录),优先级也按这个序;不吃「读起来像」——代价不对称,漏报只少一条建议,误杀会安静地丢掉一条真结论。两道门槛分开:相似度0.3决定够不够格当候选,数值与路径两类另要逐字重复度0.5(3 条、某个脚本路径这种 token 满库都是);版本/日期/状态不吃第二道。三态与巩固同一条纪律:off连那一枪检索都不打,suggest只把建议贴在回执尾部、一个字不动库并给可照抄的supersedes: [...],apply才真走 0.2.117 的markSuperseded,写错的值一律当off(这开关会改别人记忆的状态,配错必须退到最保守)。判据是数真调用而不是看回执:off零检索、suggest一枪internal检索且memory_update0 次、apply才status: 'stale';能红证明两条——把suggest也接上写库 → S2 红,去掉repeat门槛 → S7 红。⑥实体层与动态跳数(entity/dynamic_hops,默认都开;回滚另有NEBULA_ENTITY_LAYER=0/NEBULA_DYNAMIC_HOPS=0)——星图原来只连「记忆↔记忆」,实体(项目名、文件路径、工具名、版本号)在图里没有位置,问「这条路径出现在哪些记忆里」既问不出也没法从查询直接跳过去。这一版把实体抽成独立一层(graph.entityLayer)而不是塞进节点:nodes的口径是「记忆」,节点数、度数、孤立、聚类、召回结果位全按它算,混进 400 个实体这些读数一起改写。只收四类硬事实,四个上限防它长成第二个图(minMembers=2/ 上限 400 / 每条最多 6 个 / 标签 ≥4 字);缓存是 JSON、Map存不住,读回来按list现建索引自愈。第二件事是动态跳数:hop >= 1时每条软边先问「这个邻居与本次查询还有没有词面关系」,低于0.2就跳过,有关系也只给0.45 + 0.55 × 匹配度,而explicit/entity/project三条硬边照走(人工策展、同一标识、同一项目名都不是「读起来像」)。顺带修掉一个既有沉默 bug:hops: 2从来没真正跑过第二跳——energy[]只在种子阶段写过,第二跳的e0恒为 0,被if (e0 < 0.06) continue整片跳过,于是MAX_HOPS = 2与「二跳再打一次」的注释一直是空的,而没有任何一条判据发现过它(探针都只问「一跳能不能捞到」)。回执三数齐报(问到几跳 / 走了几跳 / 砍掉几条邻居)——只报「省了」会掩盖「变笨了」。诚实读数:纯共激活边权重封顶0.440,两跳衰减到≈0.049,正好卡在合成门槛0.05下面,所以「拦掉串味邻居」省的是计算不是结果;第二跳真能产出条目靠强链路。能红证明三条:e0回退 → E21/E22/E24/E31 红;去掉硬边白名单 → E23/E24 红;关层开关失效 → E29 红。⑦共现自学习扩词(coocLearn,默认开;coocLearn: false退回手工表口径,synBridge: false整层关)——换说法档 0.929 里有多少是人手写出来的?把同义词桥关掉只剩 0.714,也就是说那十八组手工词表补了 +0.215,而表没覆盖到的新说法一个字都不沾。这一版不再扩表,改成跟着库自己学:词源取每条记忆的keywords(人写的真词,不是滑窗切出来的碎片),两级证据——同一条里出现的一对词记 +2,同一项目里跨文档各出现一次记 +1(不把项目内的并集直接两两配,否则「同条」与「同项目」会互相凑分,共享汉字的降权等于没降);三道门(出现 ≥2 次、条件概率 ≥0.25、共享汉字的对子权重降到 1)加一道形态门(2–8 字、非纯数字、英文要像标识符)。学出来的表与手工表在synExpandOf第四参合流,只扩 query 不扩库。第一版拿tokenize的 bigram 当词源,真库 635 条、22,956 个 token 里只有 223 个词学到扩词,全是地全→门读这种碎片,14 道换说法题零增量——那段失败读数留在源码注释里。修好之后实测:窄池换说法 0.929 不动,宽池照抄 0.977 → 1.000、换说法 0.929 → 1.000(14/14),把coocLearn关掉退回 0.929 —— 增量可归因,不是池子变大的运气;真库 hit@1 0.925 不动。这里还有一个必须说的边界:桥词得先在库里出现过(df > 0)。「自测 / 反省 / 远端 / 仓库」这类从没被写下来的说法,任何「从库里统计」的机制都学不到——那是词典问题,不是检索问题。能红证明四条:把词源换回tokenize→ K1 红;项目层改回「整份并集两两配」→ K2 红;去掉条件概率门 → K3 红;关掉共现后宽池仍 1.000 → G-W4 红。 -
0.3.0:把「能自证」收成可发布的东西(0.3.0):这一版不动检索算法,做的是把 0.2.x 一百八十轮攒下的东西收口成对外承诺。三件事:①接口冻结——8 个
memory_*工具的名字与必填参数、1,235 字符的常驻注入、7 层 SQLite 主库布局、plugin-market/index.json的 format 1,从 0.3 起只加不删(只加字段不删字段、只加工具不改名,旧调用原样能用);②读数封版——146 条宽池三档(照抄 44 问 1.000 / 换说法 14 问 0.929 / 时间锚 9 问 0.889)连同 24 支自检的 3,323 条断言一起作为发布基线,tools/baselines.json记每支条数,少一条判红;③发布面收窄——npm 包只带lib/vendor/cordis.patch.yml/README.md(约 2 MB,verify.mjs与 24 支探针留在仓库里),装包的人拿到运行面而不是开发面;repository/homepage/bugs三个字段指向 GitHub,dsh.bundle.patch指向cordis.patch.yml,所以dsh plugin add dsh-macro-memory免构建授权直接装。 -
折价要乘在分档上,不只乘在分数上(0.2.180):0.2.179 把规矩条在缘由句里折到 0.6,照抄档打到 1.000,换说法档还停在 0.857。剩下那条最刺眼的错题是「那个跑榜单的评测台还能不能用」——正解折后 14.31、压制者折后 7.70,分数差 1.86 倍,名次倒着。根因在分档:
bandize()按_raw分档、档位优先于分数,只折score等于在一个看不见的账本上打折,折到 0.1 也翻不过去(实测那条只剩 2.385 分,仍排在 9.131 前面)。现在折价做成ruleFoldOf(di)一个 helper,三处引用同一个乘子(_raw分档 /score排序 / explain),两档常量:缘由句 0.6、现状句 0.3(问「还能不能用」时规矩条连问题的形状都不对)。换说法 0.857 → 0.929、hit@3 0.895 → 0.952,照抄档与时间锚档一位不动。顺带一条:讲「开个小门」的词原本躺在噪声组里,把它从噪声组挪到例外组,这一题直接翻成第一——同一个词放进两组,会把两道题一起搅坏。 -
问「为什么」和问「该怎么做」不是同一件事(0.2.179):真库里问「评测台为什么封存」,正解那条 611 字、覆盖度 1.00、词分 10.76;压住它的是一条 102 字的规矩(「评测台禁止无预算花主人的 key…」),词分 18.45——它一个字都没答「为什么」,只因为同一个实体而词面全中。这一版:缘由/现状问句里规矩层折到 0.6 倍、新鲜度不折,「上限怎么设」这种问句一刀不切。宽池照抄 0.955 → 1.000,
causeAware:false一键回旧口径逐位相同。顺带留下「长度惩罚按覆盖度打折」——它扫参时读数一动不动,撤掉却掉一条(1.000 → 0.977):判一个值该不该留,看撤掉之后的读数,不是看加上它的时候读数有没有动。 -
同义词表该是「动作表」,不是「同义词表」(0.2.177):宽池换说法档 14 条错 4 条,其中最难受的两条
cover = 0——问句说「远端仓库」,正文写「上传到远端」;问句说「自测」,正文写「自检三问」。一个词都不重,不是权重没调好,是词法检索根本没有「这两句在说同一件事」这个维度。补这个维度只有两条路:让机器算相似度(稠密向量),或让人把同一件事的几种说法写下来。前一条 0.2.176 已经用宽池走完并否决(三档全输,这个库满是标识符,稠密对标识符最不敏感),于是这一版只做后一条:表从 15 组扩到 18 组,扩的方向从「同义词」改成「同一个动作的两种叫法」——推送/远端/仓库并列进了上传/发布/提交,自测并列进了自检/体检/验证,另外补上封存、阈值、口径三族。读数:宽池换说法档 0.714 → 0.857,照抄档 0.955 与时间锚 0.778 一处不动,真库 45 题逐位相同。这一版最花时间的是修探针本身——原来的阴性对照要求「宽池必须比窄池差」,同义桥把两档拉平之后它必然假红:它守的其实是「引擎还没变好」,不是「宽池接进去了」。改成守「前 5 条序列至少一处不同」之后实测 40 处不同、宽池独有条目进榜 38 处,对照才重新有区分力。 -
问状态的时候,去仓里取,别去词面上撞:状态是「仓」不是「词」(0.2.176):真库 581 条里问「现在主线推进到哪一版」,正确答案就是那条「项目现状(0.2.177)」,可它连候选都不是——问句说「主线 / 推进 / 哪一版」,条目写「24 支自检 / 3,249 条断言」,一个词都不重。这不是权重没调好,是问句问的层级变了:它不问「哪句话讲了这件事」,它问「现在什么情况」。于是认出「局面词」(到哪一版 / 推进到 / 当前待办 / 项目现状)就直接去 project 仓取,分数跟榜首的实际分走(词分 0 也抬得起来);同时三道让路——问原因、问方法、带版本号的问句一概不插手,泛时间词(现在 / 当前 / 最新)一个都不留在识别词里,否则「现在推送欠账什么规矩」这类对象问句也会被卷走。读数:真库 36/41 开关两端逐位相同(零退化),三池 630/630/629 问逐位相同,成本快照两档 90 题名次 0 动。顺带把稠密检索正式否掉(三档全输 0.933→0.644 / 0.714→0.357 / 0.700→0.500,这个库满是标识符,BM25 是精确打击),并把两条时效题的 want 标成
live——答案随库变,不该每过一版回去改标注。 -
量具要按生产规模建:40 条样张是小房间(0.2.175):0.2.174 之后 45 题 gold 的 hit@1 = 0.933、MRR = 0.956,可那是在 40 条样张 的池子里跑出来的,生产的池子是 578 条。同一批问句在 578 条里跑,未中第 1 的是 5 条(多出 #7、#26——样张池里根本没有能压住它们的干扰条目)。这一版不动引擎,只把尺子摆对:从真库按层比例抽 106 条冻结快照(fact 25 / lesson 40 / topic 6 / rules 16 / user 5 / project 14,
tools/fixtures/gold-wide.json,按created_at升序等间隔取、content 截 700 字、排除 40 条样张已含的 id),探针里docs.concat(wideFx.documents)拼成 146 条池,同一批问句同一个measure()再跑一遍。读数:照抄档 0.933 一点没掉(词面强制命中,加干扰压不动它)、换说法档 0.786 → 0.714、时间锚档 0.800 → 0.700——换说法与时间锚才是真实用户的样子(用户不会照抄我的正文,也不会永远问「现在」),它们在窄池里的高分有一半来自「房间里只有 40 个人」。三条守卫线 G-W1 ≥ 0.93 / G-W2 ≥ 0.71 / G-W3 ≥ 0.70,配第四道阴性对照 G-W4:宽池换说法档必须比窄池难(读数一样好说明宽池没真接进去)。顺带修了一处量具疏漏:临时诊断脚本的ALS漏了project层,让 #37/#38/#39/#45 假死三个版本、账上写成「gold 过期」——取数口径不能有第二套。冻结快照是可复现的前提:探针仍是文件指纹,不随真库漂移;快照过期靠「重新导出 + 换代记账」解决。验收 HZ10 六条。请求前缀 0 字节。 -
要的是那条断言,不是那段背景:结论有形状(0.2.174):45 题 gold 池首位 36/45 之后,剩下的四道全属「差一点点」(#17 只差 0.382 分、#18 差 0.321 分)。把 want 与压制者摆在一起读,形状是同一个:正解的第一句就是结论,压制者的第一句是背景——#17 问「publishTimestamp 该写什么值」,正解写「必须是过去的秒级时间戳」,压在上面的那条讲「有两套时间戳、别只改一处」;#18 问「市场索引要改几个文件」,正解写「只有两份要改」,压制者讲「市场索引由几个部分构成」。两边词分都够、都在同一档,差的是「答的是不是问的那个」。结论有形状:
必须/一律/只认/只有/至少/不许/绝不/禁止/都要/统一/固定为。三版探路:①全文断言密度无条件加成 → 33→34 但 #1 #2 #3 退步(铺垫里也散着断言词);②求值型问句 × 密度、且「不抬原 top」→ 真库 #17 从第 1 掉到第 3——这个门本身就是伤害源(正解已是榜首,旁边的铺垫被抬起来反超它);③去掉门、无条件按密度加成 → 坏题 9→7(#17 #18 归位)、fixture 四池名次零变动。两个真坑:const tipAssertW漏写(ReferenceError打在_raw那行,看着像表达式写错);_raw只参与bandize分档、score 另算,同档内名次一点不动——补 score 侧乘法后坏题 7→6、#11 也归位。读数:45 题坏题 9 → 6(其中 4 条是want = null的过期样本,真错只剩 #7 #26,即 39/45、真错 2/41 ≈ 95.1%);probe-goldhit@1 0.911 → 0.933、MRR 0.944 → 0.956;自找池三池(621/621/620 问)开关两端完全相同,触发求值型的问句只有 1/9/8 条;成本快照 40 档 16 题变(名次动 2 题:#11 第 3/4/5 名互换、#18 第 4/5 名互换)、1200 档 16 题只分数变、名次 0 动、首位一处未变。做法:tipAssertOn(query)只认求值型形状(不收裸多少/几个,那是第一版 G22 假红的来源);assertRatioOf(text)只看开头 60 字、min(1, 命中数/2);两处落地(_raw进档 +score档内);tipAssertW = 1.2。出口tipAssert:false/tipAssertW:0(与关掉同分)/explain.tipAssert。probe-gold的 G20 阴性对照补tipAssert:false(和 G18/G20 同一规矩:当轮替它干活的刀一起关掉)。验收 R12 六条 + HZ9 七条。请求前缀 0 字节。 -
问的是规矩,就别拿经验来答:问句的语法形状是意图(0.2.173):45 题 gold 池首位 34/45,剩下那批错得很有规律——#21「反思应该由什么触发」正解在 rules 层 19.18 分,压在它上面的是一条 lesson(19.86 分);#40、#26 同样。差的那几毛不是词没匹配上(两条关键词都够、教训那条还更短更密),是问的层和答的层错位:问「该由什么触发」,要的是一条规矩,不是一段经历。做法:
intentLevelsOf(query)从问句形状判意图层(要不要|该不该|该由|规定→ rules;改了什么|交付态|什么版本→ fact;来龙去脉|为什么|经过→ topic;怎么跑|怎么写|踩过|经验→ lesson),一个问句可同时命中多层。三层探路都不对:①层级项直接进_raw、不加门 → 36/45,但probe-cost#39 出现 1.435 分排在 2.545 分前面(分档是硬门槛,一跨过去分数低多少都一样在前面);②改成h.score *= 1 + w的档内乘法 → 一位不动(正解与压制者本就不在同一档,档内调序追不上);③_raw加法 + 比率门(raw[di] >= lvRatio * maxRaw,lvRatio = 0.5,只帮「本来就近」的)→ 36/45、变差 0、成本名次不动;④再补 score 侧乘法,两处分工:_raw管「够不够格进这一档」,score 管「进了这一档排多前」——受控探针 R11 才真过(只有前者时,条目进了第一档却还是第二名)。中间抓到一个真 bug:乘法段一开始插在if (verbHay !== null)分支里(那是 0.2.148 的补分块,只在有原样命中时才进),受控语料整段没跑,症状和「权重太小」一模一样——「参数不生效」的第一嫌疑该是作用域,不是数值。读数:45 题首位 34 → 36/45(#21 #40 归位,变差 0;w从 0.2 到 0.8 读数全同,取 0.3);自找池三池(615 / 615 / 614 问)在w=0与w=0.3下两端完全相同;成本快照 40 / 1200 两档 名次 0 变化、13 题分数 ×1.3(层级命中的确在调相关性,换代按「名次不变、分数按系数放大」记账)。#26 那条 lesson 32.53 分本身太强,比率门按设计挡住加成、正解仍第二——这条属设计内放弃,写进文档而不是偷偷调一个刚好能过线的门槛。出口:levelIntent:false/levelIntentW/levelIntentRatio;explain.levelIntent只在真抬了的时候出现。验收 R11 六条 + HZ8 七条;probe-gold的 G18 阴性对照补levelIntent:false(和 G20 同一条规矩:对照只关被测的那把,但必须把当轮替它干活的刀一起关掉)。请求前缀 0 字节。 -
主语位:问句点名的那个东西,正文第一个词就是它(0.2.172):问「0.2.148 改了什么」时,正解(正文开头就是
0.2.148 交付态:…)排在一条教训后面——那条只在句中顺带提了这个版本号,更短、词更密,词分高出十三分。词分只数次数、不分位置,这类错必须单独说。先试的「标题里点名 → 加_raw」七档扫下来一位不动,实测真库里 fact 92 / lesson 385 / rules 33 的title全是空串——FIELD_TITLE_W = 0.6从 0.2.133 起一直乘在空串上,这是比这轮改动更值钱的发现。换判据:正文trimStart()后以问句点名的标识符(版本号/路径/短 id/commit)开头就算主语(subjRatio),_subj === 1进 bandize 第一档(和「问的就是这条 id」同档);只在句中提到的不算。为什么不用权重:identSubjW2.4 不过、2.5 过,悬崖太陡——能靠档说清的事别用权重硬顶,权重默认定 0。45 题 gold 池首位 31 → 34(#1 #2 #3 全归位),变好 3、变差 0;正常检索 45 问 × {40,1200} 成本快照逐位全同(零副作用)。出口:identSubjBand:false/identSubj:false/identSubjW;explain.subjBonus只在真加了权重时出现。验收 R10 六条(走引擎 APIV.search,不走工具层——工具层读不到band)+ HZ7 七条;probe-gold的阴性对照NB补identSubjBand:false, identSubjW:0(漏一把刀就不叫对照)。 -
历史不是「没有」,是「过期了」:点了名就该翻出来,还得说清它过期(0.2.171):真库 45 题 gold 池(k=10)首位只有 30/45,而最刺眼的四题(「0.2.148 改了什么」「0.2.148 做了什么」「0.2.147 改了什么」「0.2.146 加了什么」)前 10 名一条正解都没有——不是排错,是正解根本不在候选集里:
listSearchable只回status='active',每条版本的交付 fact 都被下一版取代成 stale,于是读者拿到的是五条正文里顺带提过这个版本号的 lesson,一句提示都没有。两层原因:一、stale 不进候选池(主人拍板「其他类别过时不检索」,这条口径不动);二、bandize(hits,'_raw')按纯 BM25 分档,而 0.2.148 的标识符补分只进score不进_raw——最强的那类证据,在分档那一层完全不算数(问「0.2.148 改了什么」时0mwq84ts分数 14.70 却排第 4,_raw5.03 被_raw7.95 的压在 band 0)。做法四条:①补分也进_raw(IDENT_BAND_W=0.8,只乘不加——分成 3 倍跨不了档,乘上去才在接近时翻面;默认档 45 题读数一题不变,是给下一刀的地基);②只补「点了名」的那几条(identsOf(query)取版本号/路径/短 id/commit,才去 stale 里找含这个标识符的条目,include_stale:false可关);③先打分再取前 N(第一版按库顺序取两条,0.2.147的正解被两条同版本条目挤到第 3——按顺序取等于「先来的赢」;改rankForSearch(..., { k: HIST_LIFT_MAX }),HIST_LIFT_MAX=3);④翻出来的要自己报名(search.histLift一句「只出现在已过期的条目里:顺带翻出 N 条,它们已被后续版本取代,别当现在的结论用,要通看历史传 status:"all"」)。读数:首位 30 → 32、次席 6 → 7、触发 6 题,逐题只有 #1 −1→0、#2 −1→1、#3 −1→4、#4 −1→0,其余 41 题一位不动;#13/#16 触发了但正解不在 stale(#13 的 want 已 archived),属池过期。连带假红一处:identBand 一开,probe-goldG20「旧口径下锚点池没变差」失效(新刀替关键词权重干活)——修法与 0.2.170 同一条,对照组只关被测的那把({ identBand: false })。验收:probe-recall R9 六条、verify HZ6 七条、probe-gold 全绿、成本快照换代(40 档 4 题变 / 1200 档 0 题变)。请求前缀 0 字节。 -
疑问词不是证据:中文切词会把「什么时候」切出「么时」(0.2.170):换说池 13 题里有两题(「什么时候才轮到把代码放到远端仓库」「它自己什么时候该回头反省一次」)的榜首是同一条笔记
0mwpfhh3——它正文里写的正是「什么时候」这类闸门词,bm25 拿了 9.24 / 9.41,而两条正解只有 5.84 / 3.61;#3 的第二名还是它的同族。不是排错了,是问句里的疑问词把一条讲疑问词的笔记顶上了桌。根子在切词:tokenize对中文走二元组,什么时候会产出什么 / 么时 / 时候——CJK_FUNC_WORDS剔掉了「什么」「时候」,跨界碎片「么时」「己什」「候该」全漏网;碎片 df 极低、idf 极高,一个假词就够把错的那条顶到榜首,而噪声地板只认「出现在一半以上条目里的词」,管不到它。做法是在分词前把疑问框架整段剥掉:stripQuestionFrame(text)把什么时候|多久|怎么办|怎么|为什么|为啥|是不是|能不能|会不会|有没有|该不该|哪些|哪个|多少|是否|如何|是什么替换成空格(不是删掉——空格负责切断 bigram,删掉会让两侧粘成新假词),返回{ text, stripped };三条护栏:剥完不足 4 个字符就整句回退(「为什么」这类问句宁可带噪声,不许凭空空手)、只作用问句不动索引与文档切词、questionStrip: false一键关。读数(真库 554 条,工具层 k=10):换说池 11/13 · 首位 4 → 5 · 4.23 → 4.15 条;自找池 150 题 525/554 · 首位 509 · 2.65 条一位不动(那批问句是 keywords 拼接,天生不含疑问词)。逐题看只有两处变化:#3 第 2 → 第 1、#9(「把一个文件拆开之后,怎么确认行为一点没变」)第 1 → 第 0,其余 11 题名次一位没动。可追溯性:explain.stripped只在真剥了的时候出现——默认回执一个字节不花;工具层 note 加一句「疑问框架按虚词处理了:{words}」,只有 explain 模式才有值。连带修了五处老刀的假红(NF2/NF3、VT2/VT3、G9、GW、VW10):新刀一开,老刀的阴性对照仍被它挡住,「噪声回不来」看起来像地板失效——修法不是调阈值,而是对照组只关被测的那把刀,五处统一补questionStrip: false。探针 R8 八条(函数口径 / 短句回退 / 标识符不损 / 切断碎片 / 只在问句侧剥 / 受控库那刀真能红 / explain 看得见 / 关掉不谎报),验收块 HZ5 八条;粗胖线 105,000 → 106,000(实测 105,156,+0.15%)。请求前缀 0 字节。 -
语义补位第一次真跑起来:救一条正解,别把陪跑一起端上来(0.2.169):0.2.154 的「词法没把握就按语义补位」和 0.2.166 的「不沾边就弃权」在本机一次都没真跑过——稠密模块那行加载判据把「包名里有斜杠」当成路径,
@huggingface/transformers被拼成file:///@huggingface/transformers,抛File URL path must be absolute之后被 catch 成off,降级了半年,一声不响。判据改成「只有真的像路径才按路径 import」之后denseStatus()才第一次变成ready(bge-small-zh-v1.5#q8 / dim 512 / 549 条全编码 5,328 ms)。第一次真跑读数就分叉:换说池里「它自己什么时候该回头反省一次」词法把正解排第 5(正解 5.858 分 vs 榜首 14.296,两条正解原词命中都是 0、分数全来自同义桥),稠密单独排第 1——词法单独 10/13、稠密单独只 3/13,但两者互补。第一版把denseRes.ranked(cos ≥ 0.45、上限 30 条)一路塞进回执、还顺手关掉收口、把词法 head 之后的尾部整段接回:换说池从 4.54 条 / 943 字涨到 8.23 条 / 1746 字——命中多一题,代价是三四条陪跑,而且收口一关、那句「和榜首不是一个量级」也不说了。定案是限量 2 + 折尾部:DENSE_RESCUE_MAX = 2(opts.rescueMax可覆盖,if (added >= maxRescue) break;,只有真 push 才added += 1;——数的是补进来的不是扫过的候选),词法 head 之后默认折掉(rescueDropTail: false才接回)。读数:换说池 11/13、首位 5、4.23 条 / 870 字(比不开稠密还短 0.31 条 / 73 字),自找池 149/150 · 2.17 条一位不动。账也补平了:const dropped = sliced.length - out.length + upstreamTrim;——0.2.167 只报「这一刀折了几条」,上游折的会被这一层的slice悄悄抹平;词法尾部折的另记rescueTrimmed、补进来的记rescueAdded,两笔都非枚举。note 只出一句(search.rescue):「这次词法没把握(榜首只覆盖了这条问句的 10%):已按语义补了 2 条(余弦 ≥ 0.45,分数与词法不是同一套量纲);词法里没把握的 13 条没展开」——这条路径上「弱命中」与「回执没给满」说的都是同一件事,一律让位,三句同义话变一句。探针 R7 七条(常量限量 / 循环生效 / 折数累加 / 来路分开记 / note 报名 / 加载判据 / 两次调用逐位相同),G25 的trimmed挂载点从「唯一」改成「两处、来路不同」,验收块 HZ4 七条。rescueMax/rescueDropTail不进 schema(只给内部探针用),请求前缀 0 字节。 -
隐形的一层:默认检索范围里一直没有 user(0.2.168):自找池 150 问里有 8 题在工具路径上一条都不回,而同样的 8 题在 API 层名次全是第 1——不是排序排错了,是根本没进候选池:默认检索范围写死
fact/lesson/topic/rules,user层(主人的偏好、约束、交付口味)从来不参与关键词检索,回执的 note 里也只字不提「别的层还有东西」。这一版把它补进默认,同时把相关度地板从 0.35 收到 0.30。读数(真库 545 条、真调memory_search.execute):自找池 150 问命中 142 → 150、首位 141 → 149,而回执反而更短(2.18 → 2.01 条 / 531 → 493 字——正解进榜,弱候选被地板挤出去);换说法池 13 问 9 → 10 题,代价 +0.31 条 / +59 字;地板 0.25 与 0.30 在换说池同分,取自找池更瘦的 0.30。边界是量出来画的:soul 与 project 仍不默认——project 层天生跟任何问句都沾一点,掺进来换说池首位就从 5 掉到 4。零命中文案跟着改口,从「不说的默认」变成「说清的不查」。探针 R6 五条(含「显式只查四层时那条 user 一条不剩」「边界没破」「不传参数与显式传参逐位相同」三条阴性对照),验收块 HZ3 七条。 -
回执的欠账要报出来,而且要给一个关得掉的出口(0.2.167):0.2.165 的置信档收口上线两版,一直在切回执,切完一声不响——读者看到「只给了 5 条」,既不知道同档之外还有多少,也不知道该不该要全量。这一版把刀摆到台面上,顺便量清了到底是谁在切:把真库 540 条塞进工具路径、真调
memory_search.execute(20 个关键词问句),默认回执平均只有 2.35 条,band_keep:false3.05,再配上min_rel:0才 9.70——三把刀里主导的是相关度地板min_rel=0.35,置信档收口只占 0.7 条(这也纠正了 0.2.165 文档里「回执从 9.80 收到 4.97」在工具路径上的归因:那里根本没有 9.80 条可收)。做法三段:trimByBand把折掉的条数记成返回数组上的trimmed,非枚举(Object.defineProperty(..., { enumerable: false }),JSON.stringify/Object.keys/for...of全看不见,旧调用方的逐位相同性一字不改——「改口径不许顺手改协议」);回执只在短于k时说一句「这次回了 N 条,没到你要的 k 条」,候选池多大不印(那只说明库大,不说明少看了什么);出口band_keep: false写进统一工具与 meow 原工具两处 schema、一路接进rankForSearch,并明说「配合min_rel: 0才是真全量」。读数(真库 150 问 k=10):名次一位不动(hit@1 149 / hit@3 150 / hit@5 150,均值仍 4.97),148/150 题报出收口、合计 731 条、单题最多 5 条,每题「保留 + 折掉」都等于关掉时的条数(账平),bandKeep:false时报数 0。代价:memory_searchschema 6,852 B(单项上界 6,500 → 7,500,按老规矩只给实测值 +9.5%),回执多一行。探针 G25 十二项判据,验收块 HZ2 五条。 -
回执按置信档收口:同档才回,能少给一条就不给(0.2.165):
bandize早就算出「这条和榜首是不是一个量级」(IMP_BAND = 0.85,0.2.150 起就在用它护短查询),但回执这一步完全没用它——不管榜尾差多少,一律把k条捞满。量一下很清楚:1200 条真库 150 问,正解进 top10 的 150 题里 150 条都落在 band 0(100%),band 0 平均只有 1.08 条,而实际回的是 9.80 条——多出来的八条九条本来就是「不该给」的。这一版把已经算出的判断接到出口上:trimByBand只回_band <= 0的那几条,至少 5 条(RESULT_MIN_KEEP = 5)兜底、绝不超过k;bandize现在无条件把_band挂在 hit 上(以前只有explain带 band),词法一路、稠密融合一路、dense: false退路三处共用同一个裁剪函数(退路自己另写一套,早晚会长出两种口径)。下限是量出来的取舍点:minKeep=3 会把真库「换说法」池掉 2 条(9/14),5 与 k=10 的读数逐位相同(三池 hit@1 / top5 一条不丢),8 开始又往回涨。读数:照抄 6.13 → 4.40 条(省 28.2%)、换说法 7.93 → 4.79、锚点 7.40 → 4.60、真库自找 9.80 → 4.97(省 49.3%)、真库换说 10.00 → 5.00,五个池的 hit@1 与 top5 一处没动。minKeep: 0或bandKeep: false逐位回到旧口径。探针 G23 十一项判据 + 五条阴性对照(回满 k / 下限调到 3 / 退路不裁剪 /_band只挂 explain / 常量另写一份),各改一处当场变红。成本:请求前缀 0 字节。 -
读数工具自己也是被测对象(0.2.164):三版「真库自找回」都是拿
SELECT *的原始行当语料,而库里keywords是 JSON 文本、引擎三处按数组判空——关键词通道一直静默失效。走db.listSearchable→fromRow之后同一个引擎从 0.867 变 0.993,覆盖度口径随之回到 0.45/线性(三池一位不动、真库换说 top5 9 → 12)。 -
覆盖度是内容证据,不是装饰(0.2.163):照抄池卡在 42/45,两条是同一对条目的错位——问「评测台为什么封存」,榜首是一条 102 字的规矩(正文只提到
评测台),正解是 611 字的记录(正文里有评测台 + 封存)。问句里最值钱的那个词只有正解有,榜首却还是它:字段加成把短条目的两个词放大到 2.2 倍,再叠上重要性/新鲜度乘子,最后按raw分档——跨档不许越级,排序层根本没机会。覆盖度(问句词的 idf 覆盖率)其实早就算好了,但只按COORD_W = 0.35轻轻乘一下,缺一半词才掉 17%,掰不过 2.2 倍。这一版只动这一个口径:COORD_W0.35 → 0.5,并给覆盖度一个 1.2 的幂(缺口越大掉得越快),两个常量各定义一次、都能用 opts 覆盖。读法先立规矩:三池一条不亏——照抄 0.933 / 0.978 / 0.956、换说法 0.714 / 0.929 / 0.798、锚点 0.800 / 1.000 / 0.883 一位没动;赚在真库:150 问自找回 hit@1 0.860 → 0.873,14 条换说法问句 0.286 / 0.500 / 0.413 → 0.357 / 0.571 / 0.455,逐题是三好一坏。网格扫过 coordW 0.35–0.6 × 幂次 1–1.6:0.5/1会把锚点池打到 0.700,0.55起照抄池开始掉条目,0.5/1.2 是两头都不亏的平台起点。探针 G22 一条聚合 + 九项判据(单一来源 / 兜底同源 / 只动一处 / cover 不跟权重走 / 导真值 / 行为分差 / 幂次更疼 / 老规矩 / 文档在案)+ 五条阴性对照(回 0.35 / 去幂次 / 改线性 / cover 跟权重 / 常量不导出),各改一处当场变红。如实说边界:评测台为什么封存那条没救回来——根在字段加成 2.2 与跨档,是另一层的事;真库净 +2 条命中,不是「准确性提高一大截」。成本:请求前缀 0 字节。* -
词面上根本没有可比的词时,换个说法也找得回来(0.2.162):换说法池 hit@1 从 0.2.152 起卡在 0.500,此前几轮都在排序上找原因(分档、时间折扣、字段加成、弱命中提示),每一刀都挪得动一两条,都挪不动这个数。拆开才发现是更前面一层:
tokenize对中文只产二元组,反省与反思、推送与远端在倒排表里是两套互不相干的词——不是排得不够靠前,是没有可比的词。这一版只补词面这一层:15 组手工同义词表,只扩问句、不动文档,扩出来的词按SYN_W = 0.6单独计分(帮忙可以,顶替原话不行),覆盖度分母qIdfSum一个字节不动,倒排候选集并进同义词的 postings(只加分不进场的条目等于没写)。读数:照抄 45 池与锚点 10 池一处不动(0.933 / 0.978 / 0.956 与 0.800 / 1.000 / 0.883),换说法 14 池 0.500 / 0.714 / 0.601 → 0.714 / 0.929 / 0.798(四条变好:反省↔反思、推送↔远端、筛掉↔过滤、一段虚词没剔)。顺带补了两条虚词:不要(要不早就在表里,另一半一直没剔,于是「要不要问」这类问句里不要一直在打分)与一段(一个/一下/一次/一点/一些同族)。真库迁移要如实说:14 条换说法打 573 条真库只是同向很小(MRR 0.399 → 0.405,且一进一退),fixture 上的结构性收益不等于真库也这样。探针 G21 一条聚合 + 十一项判据 + 五条阴性对照(synBridge:false照样扩 / 候选集不并 postings / 扩词混进覆盖度分母 / 虚词表拿掉不要/ 权重压到 0.05),各改一处当场变红。第一版表里写了单字的门/笨/慢,二元组永远命不中——表要能被检索到才算表。成本:请求前缀 0 字节。* -
关键词是唯一长在数据里的标签(0.2.161):真库 569 条的
title一条都没填(实测null),引擎里 0.6 的标题权重一直在空转,而用户自己写的keywords只按 0.25 倍词频、+0.35 加成参与打分——顺序反了。这一版把它们抬到 0.35 / 0.6 并收成两个模块级常量(KW_TF_W/FIELD_KW_W_DEF,kwTfW的三处兜底——索引、缓存键、取索引——同读一个来源,否则换权重后缓存会继续喂旧表)。读数:照抄 45 池一处不动(0.933 / 0.978 / 0.956)、换说法 14 池 0.500 / 0.714 / 0.598 → 0.500 / 0.714 / 0.601、锚点 10 池 0.700 / 1.000 / 0.833 → 0.800 / 1.000 / 0.883(「0.2.148 交付时改了几处」从第 2 名进榜首);真库自找回:拿 keywords 当问句找自己 0.940 → 0.961,拿正文头 40 字找自己 0.974 → 0.977。为什么是 0.35 不是 0.5:两个组合读数一分不差,但 0.5 会把「只在 keywords 里提到的条目」压过「正文命中的条目」,当场打红 0.2.152 立下的「标签不是正文」——扫了 52 个可行点才找到的唯一「读数峰值 + 不破老规矩」的组合。试过给真库补伪标题(正文首句截 20/30 字):真库 7 条换说法排得更差、keywords 自找掉到 0.933 → 不造数据,宁可承认这列空着。探针 G20 八项判据 + 五条阴性对照(退回旧口径 / 抬到 1·1.2 / 只抬词频 / 换成会破规矩的 0.5 / 只抬加成),各改一处当场变红。成本:请求前缀 0 字节。* -
弱命中就说清:分低时把「差在哪」说出来(0.2.160):换说法池 hit@1 只有 0.500——词一个都对不上时(
tokenize产的是中文二元字组,虚词也在打分),任何加分、改档、调权重都是在猜。这一版不加分、不改档、不动排序,只加一句诚实的说明:引擎把「榜首覆盖了问句 idf 权重的几成」(cover)与「第二名/第一名」(gap)算出来,cover < 0.2或gap ≥ 0.95时 note 里出现「这次弱命中:榜首只覆盖了这条问句的 15%……库里是这么说的:key、花钱、预算」,让调用方用库里的话再问一次。三条底线:强命中零字节(不弱就返回空串)、版本号问句不误报(榜首自己就带那个日期时闭嘴,锚点结论直接复用)、提示不进打分路径(45 池 0.933 / MRR 0.956、换说法 0.500 / 0.714 / 0.598 逐位不变,cost 快照也不用重落)。真库 630 条 69 问实测:触发 30%,真没中的抓到 16/31,误报 5(7%)——cover低是事实、答案恰好对了不算说谎,所以文案说的是「先看正文确认」而不是「这条不准」。句长最长 129 字;探针 G19 自带三条阴性对照(不闭嘴 / 误报版本号 / 抽词不剔,各改一处当场变红)。* -
断言数基线:
tools/baselines.json记每支的 PASS 条数——少了判红(有人删了东西),多了只提醒。 -
耗时预算:每支 4×实测且不低于 30s,超时 SIGKILL;比基线慢 1.5 倍只提醒不判红(慢不等于坏)。
-
vendor 账本:
vendor/VENDOR.json记两棵 vendor 树的文件数/字节/整树指纹,改过没重记就 FAIL;另有 89 条「我们故意打的补丁还在位」的内容断言。 -
阴性对照:每轮都先把判据打红一次再还原,证明判据不是纸做的。
目录结构
lib/
  index.js            唯一入口:Config(平铺 volatile)、装配、热应用
  client.js           浏览器侧产物(build.mjs 从两个 vendor client 拼出)
  macro/
    bridge.js         收下与转调(createBridge / errText / wrapPlugin)
    facade.js         三个 Proxy:ctx.tools / ctx.systemPrompt / 最外层
    render.js         纯函数出文本,零 import
    tools.js          8 个统一工具的装配器
    defs/             一个工具一个文件(remember/search/read/update/project/link/dream/admin)
    linkflow.js       待补连线队列(排队、节流、补连、判永久失败)
    brand.js          名字级改口(不改返回正文)
    prompt.js         L0 注入文本 + 完整手册
    store.js          唯一碰 node:fs 与 DSH_HOME 的地方
    cost.js / links.js / shared.js / panel.js
vendor/
  meow-memory/        主库内核(MIT,见第三方声明)
  dsh-memory-nebula/  星图内核(MIT)
tools/                自检与探针(15 支 + 账本/体检)
plugin-market/        市场索引(格式 1)
DESIGN.md             设计取舍与教训(内部)
docs/                 INTERNAL.md 逐轮开发日志、images/ 配图
第三方声明与来源
本包 MIT 许可(见 LICENSE)。
内置两份第三方代码,均为 MIT,完整许可原文随包保留:
| 组件 | 来源 | 许可 | 说明 |
|---|---|---|---|
meow-memory@0.32.8 | Phant0Meow/dsh-meow-memory | MIT © 2026 Phant0Meow | 主库内核:七层 SQLite、梦境巩固、反射。vendor/meow-memory/LICENSE 为其原文 |
dsh-memory-nebula@1.11.74 | 本仓库作者 | MIT © 2026 主人 & 小代码酱 | 星图内核。vendor/dsh-memory-nebula/LICENSE |
改动说明(MIT 要求「显著修改需说明」,逐条记在 THIRD-PARTY-NOTICES.md):
- meow:注入消息的来源
kind改为plugin:macro-memory(老值仍认);设置页文案与热应用说明改写;其余内核逻辑未改。 - nebula:
systemPrompt.context恒返回一条稳定 RULE(移除每轮自动邻域注入);recall过滤归档节点;工具归因表统一到plugin:macro-memory。
两棵 vendor 树的可核指纹在 vendor/VENDOR.json,任何人都能验证「这是一份改了哪几处的副本,而不是另写的东西」。
English
Macro Memory (DSH plugin, MIT) folds several memory plugins into one surface: 8 tools + a single 1,235-character standing injection, while the storage engine stays meow-memory's seven-layer SQLite and the graph becomes a rebuildable index.
Headline numbers (v0.4.0, all reproducible offline):
- Tool schemas: 17 tools / 56,759 B → 8 tools / 13,567 B (−76.1%).
- Standing prompt: 4,085 chars → 1,235 chars (−69.8%); per-turn fixed cost ~14–16K → ~2.2K tokens.
- Retrieval latency on a 1,200-memory store: p50 2.9ms (vs 107.2ms with three plugins stacked).
- Nothing was dropped: every original tool is reachable through the unified surface (audited by
tools/coverage-audit.mjsandtools/param-audit.mjs). - Writes land in the main store first; graph links that cannot be written are queued, not lost (500 entries, 7-day TTL, auto-flushed).
- 30 self-check suites / 3,511 executable assertions / ~220s, and the assertion count itself is pinned per suite — deleting an assertion turns the run red.
- Self-built gold set (146 memories, no LLM): verbatim 1.000, paraphrase 1.000 (0.929 with co-occurrence expansion off), time-anchored 0.889.
- Real local library (635 memories, 40 questions): hit@1 0.925, hit@5 1.000, MRR 0.963.
- LoCoMo 1,536 questions (no LLM): hit@20 0.7546 (old pipeline 0.651), MRR 0.4953 (old 0.3768), 17.77 average retrieved memories (old 19.99).
Why it beats stacking another memory plugin:
- It cuts the cost you re-pay every turn — tool schemas and the standing injection are request prefix, so a byte saved is a byte saved on every single turn.
- Every feature has an off switch with a proven on/off gap — query decomposition, consolidation, auto-supersede, entity layer, co-occurrence expansion, synonym bridge (
multiQuery,consolidate,autoSupersede,entity,coocLearn,synBridge); default is the most conservative setting. - One criterion, one implementation, and every criterion is proven able to fail — no criterion is written twice with different strictness, and each one ships a fixture that must turn exactly that one red.
- Nothing new is allowed to lie — write-side inflation checks (
selfecho,unused,inflate) and supersede/carry-forward notes, so a stale conclusion never silently outranks the current one.
Honest limits: the gold set is self-built, not a public leaderboard; real-library numbers move as the library grows and are not comparable across time; no end-to-end LLM-judge run has been repeated since 0.4.0, so we claim no end-to-end gain.
Bundled third-party code is MIT: meow-memory © 2026 Phant0Meow (source), dsh-memory-nebula © 2026 the authors. See THIRD-PARTY-NOTICES.md for the exact list of modifications.
内部开发日志(0.1.x 起逐轮记录,含每次事故与判据)在 docs/INTERNAL.md;设计取舍在 DESIGN.md。lib/client.js 为构建产物:163,239 B,sha256 2F546AA8…。