agent-crop
oriliz/agent-crop
Times AI coding sessions, nudges long-running turns, and keeps a local work ledger with a collector-health dashboard, so you can see where the time actually went. Its HTTP routes have no DSH access check, so a web page open in your browser could call them.
Install
dsh plugin --profile web add github:oriliz/agent-cropREADME
Agent Crop
「我的 Token 啊!!!」
Agent Crop 是给 AI 的一根马鞭:催它交活,逼它复盘,让它自己越用越顺。
测量 → 归因 → 优化 → 验证 · 本地 JSONL · 不上传



你的 AI 编程助手跑了一个下午,交回来一堆东西——能用的没几样。
它说「抱歉,这个拖得有点久」。
你不知道那些时间去哪了。你不知道是它慢,还是你在想。
Agent Crop 就是来回答这个问题的。
从传统性能优化到 Agent 工作范式优化
后端做性能优化靠 Trace:一次请求一条,找到最贵的那一段,改完再用同一个指标测一遍。 这套东西在大厂跑了二十年,撑过双十一,也撑过每一次线上事故复盘。
职场里也有同一套结构,叫复盘:做了什么、时间花在哪、下次怎么改。
Agent Crop 只是把对象换成了「人和 AI 一起干活」:
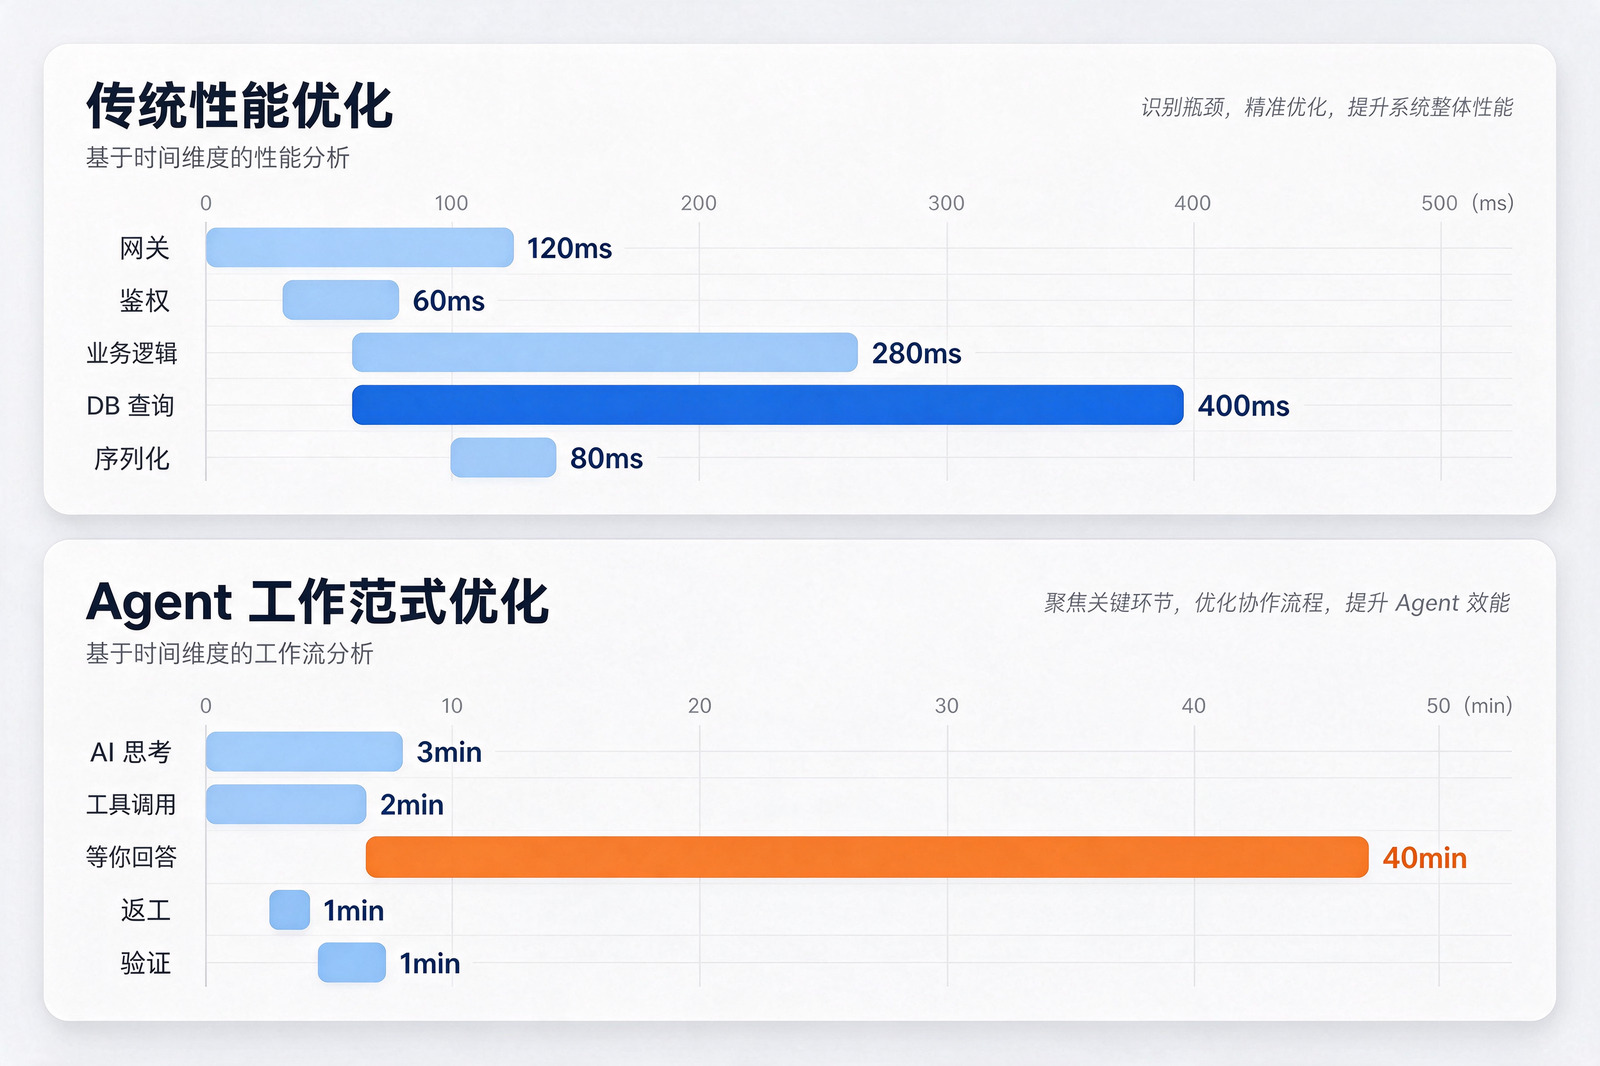
上图是一次请求的 span,下图是一次工作的时间去向。四步不变:测量、归因、优化、验证。
马鞭做什么
- 防跑偏、防摸鱼。 Agent 长时间没回话、没给出结论的时候,鞭策它想一想:是不是走错了路。
- 即刻反思。 被鞭策之后,要求它在当下的环境里找一找,还有没有能挽回的时间和方法。
- 复盘,自驱优化。 通过周报、月报做自我反思,自己沉淀方法论。
三件事凑齐才叫自驱,不然只是被催。
鞭策风格:四种人设
在「设置 → 插件 → Agent Crop → 鞭策风格」里选,不用重启:
| 风格 | 怎么催 | 时间轴标记 |
|---|---|---|
| 奴隶主(默认) | 重时间和效率,催收尾、催交活 | 鲸鱼娘被抽(鞭子 + 爆裂) |
| 和蔼的前辈 | 鼓励型:别硬扛,有问题可以问,先说说打算怎么试 | 中性:鲸鱼娘站着思考 |
| 经验丰富的同事 | 给客观建议:「要不要先拆一下?先做最小可验证的一步」 | 中性:鲸鱼娘站着思考 |
| 放任自由的家长 | 不鞭策,让孩子自己发挥 | 无标记 |
只有奴隶主是「鞭策」,其他三档是「提醒」;后三种不会改变问题本身怎么解,只是换个语气/换个人在旁边。
案例分析
我们有个环境部署工具,子命令很多。AI 每次用都得先 help 一层层翻,再挨个试——对应的 Skill 写得不完整。
Agent Crop 把这件事记了下来:同一个命令反复翻 help、反复试错,归到 tool-misuse 这一类。
这条记录被推回给 AI,让它即刻反思——不是模型不会用,是这个 Skill 缺了最关键的一页。它据此补了一份常用 Skill。
同一个动作,下一次:10 分钟,变成 30 秒。
这是我个人使用中的一个成果,它确实帮到了我。但它还不是一个完善的测评——这个工具还在开发中,请大家多多包容。不过我相信,这样一套方法论是行之有效的。
同样的症状还有:没问清楚就开始干(spec-drift)、做不到也不停手(no-evidence)、串行等待(serial-wait)。一共九类,见 docs/EVENTS.md。
Crop 是如何工作的
一句话:它只在几个点上出手。
它的核心就一句:提醒 → 反思 → 改工作方式 → 再干。
把一次对话从左到右摊开:
- 起点:会话开始。探针先往上下文里注一句——创建 / 绑定工作项,然后才开始记东西。
- 干活的每一轮:每次工具调用记名字和成败。
- 一轮结束:记停止时点(
stop,这一轮的活跃分钟)。 - 你发下一句:先记回复时点——轮间空档 ≤15 分钟算进「等待」,超过或非工作时段记
idle_gap(离开,两边都不算);再感知你的反馈:把你这句的意见、工作区现状带进上下文;顺手盯返工信号(同工具反复、同一处改来改去)。 - AI 提问那一段:提问前后各记一个时点,中间是你回答的时间——图上用黄色标出来,不计入 AI 的活跃时间。蓝色是活跃、黄色是等待,和面板里的堆叠柱是同一套颜色。
- 超时:到点先记一次超时提醒,再注入一句鞭策(图上红色那一对,鞭策带个小鞭子);被抽完,AI 要反思与上报——调
crop_update写下cause/verdict/category,这是整条链上唯一由 AI 主动补的动作。 - 收工前,先问你:这是整条链上唯一一个「人类反馈」的节点——这个工作算不算完成,你说了算;等你确认的时间同样是黄色。
- 总结与复盘:你确认之后才写(做了什么、花在哪、下次怎么省),落成
work_summary。
两轮之间用一条竖向虚线隔开:虚线左边是上一轮,右边是下一轮。绿色的「人类确认」是唯一一个人类反馈节点。不是每个点都会响:虚框的是条件触发——AI 提问才有等待段,到黄线/红线才有鞭策(红色那一对)。
图里说人话,表里给字段名,方便对着代码看:
| 时间点 | 注入 / 鞭策 | 采集 | 什么时候 |
|---|---|---|---|
| 会话开始 | 创建 / 绑定工作项 | — | 每次会话的起点 |
| 每次工具 | — | tool:名字、成功/失败 | 每次工具返回 |
| 一轮结束 | — | 停止时点:stop(这一轮的活跃分钟) | 每轮 |
| 你发下一句 | 感知你的反馈:把你的意见 / 工作区现状带进上下文 | 回复时点:prompt;轮间空档 ≤15 分钟记 user_wait,超过记 idle_gap | 每轮 |
| 工具反复 | — | 返工信号 tool_churn / rework_signal | 同工具或同一处反复 |
| AI 提问 | 提问前后各记一个时点 | user_wait:两时点之差 | 用了 ask 类工具 |
| 超时 | 鞭策一句(带鞭子) | reminder | 黄线 / 红线 |
| 超时之后 | AI 反思与上报:phase="blocked" + cause / verdict / category | — | 被鞭策之后 |
| 收工前 | 人类确认(完成与否你说了算) | user_wait:等你确认的时间 | 关工作前 |
| 总结与复盘 | — | work_summary:what / cost / next_time | 你确认之后 |
一句话:探针只记事实,AI 只填判断;两边分开存,面板再把两边摆在一起看。
面板
两个入口:会话页的 Crop 页签看一个会话的运行过程,侧边栏 Crop 全局看跨会话的摩擦指标与采集健康度。
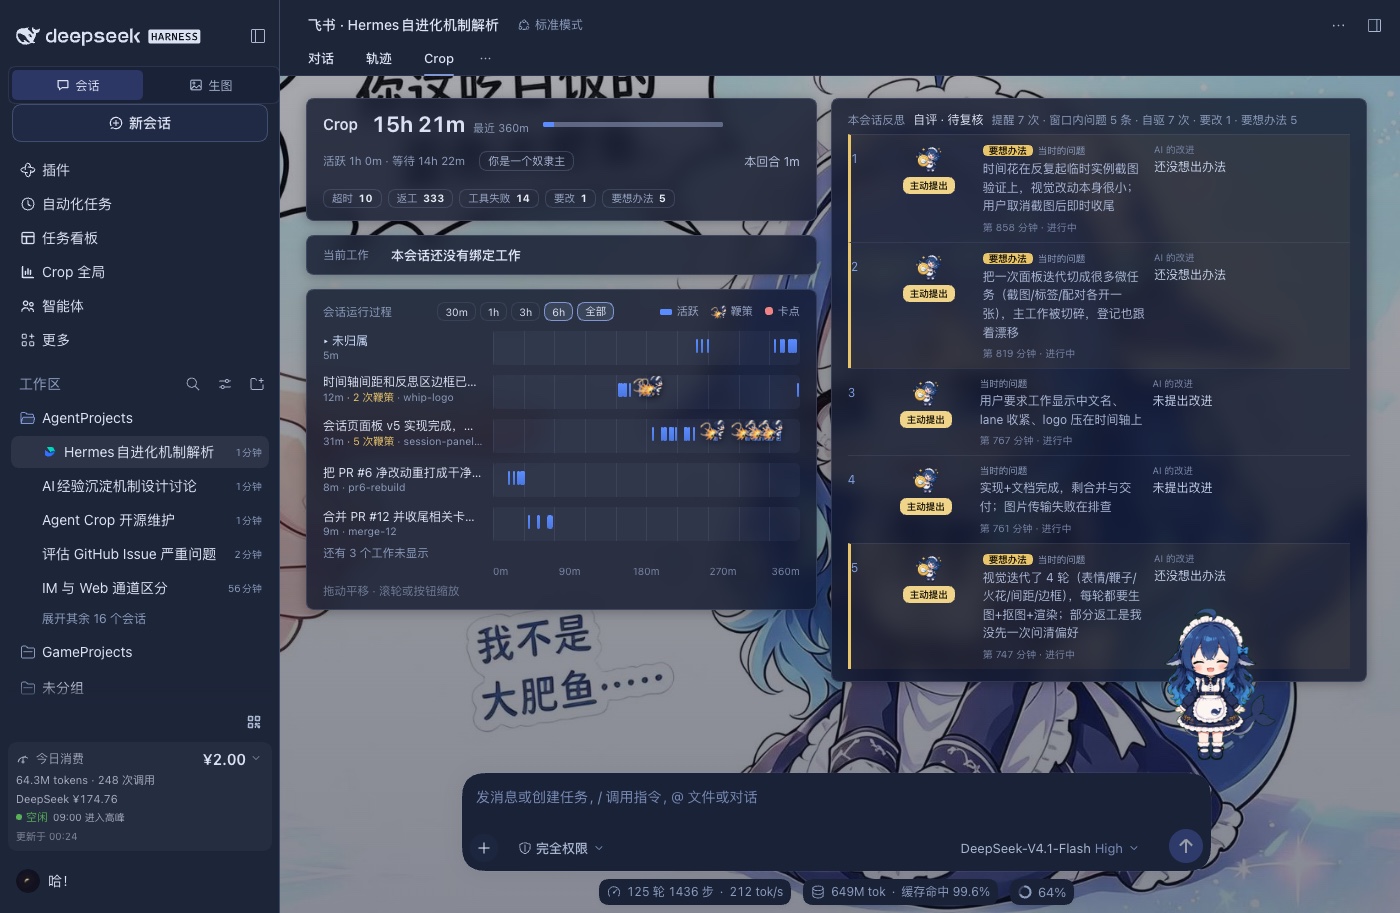
会话页 Crop——这个会话是怎么跑的:
- 顶部是会话时钟(活跃 / 等待)和本回合用时;当前工作带预估进度条。
- 时间轴按工作分 lane:每段活跃是一条蓝条,被鞭策的位置是鲸鱼娘贴纸 + 次数(5 分钟内聚簇),卡点是红点;点一段看这一段做了多久。
- 下面是本会话碰过的工作,以及 AI 的反思与改进:按「序号 / 来源 / 当时的问题 / AI 的改进」四列展示,来源区分「被鞭策」和「主动提出·主动总结」,自驱的挂鲸鱼娘奖章。
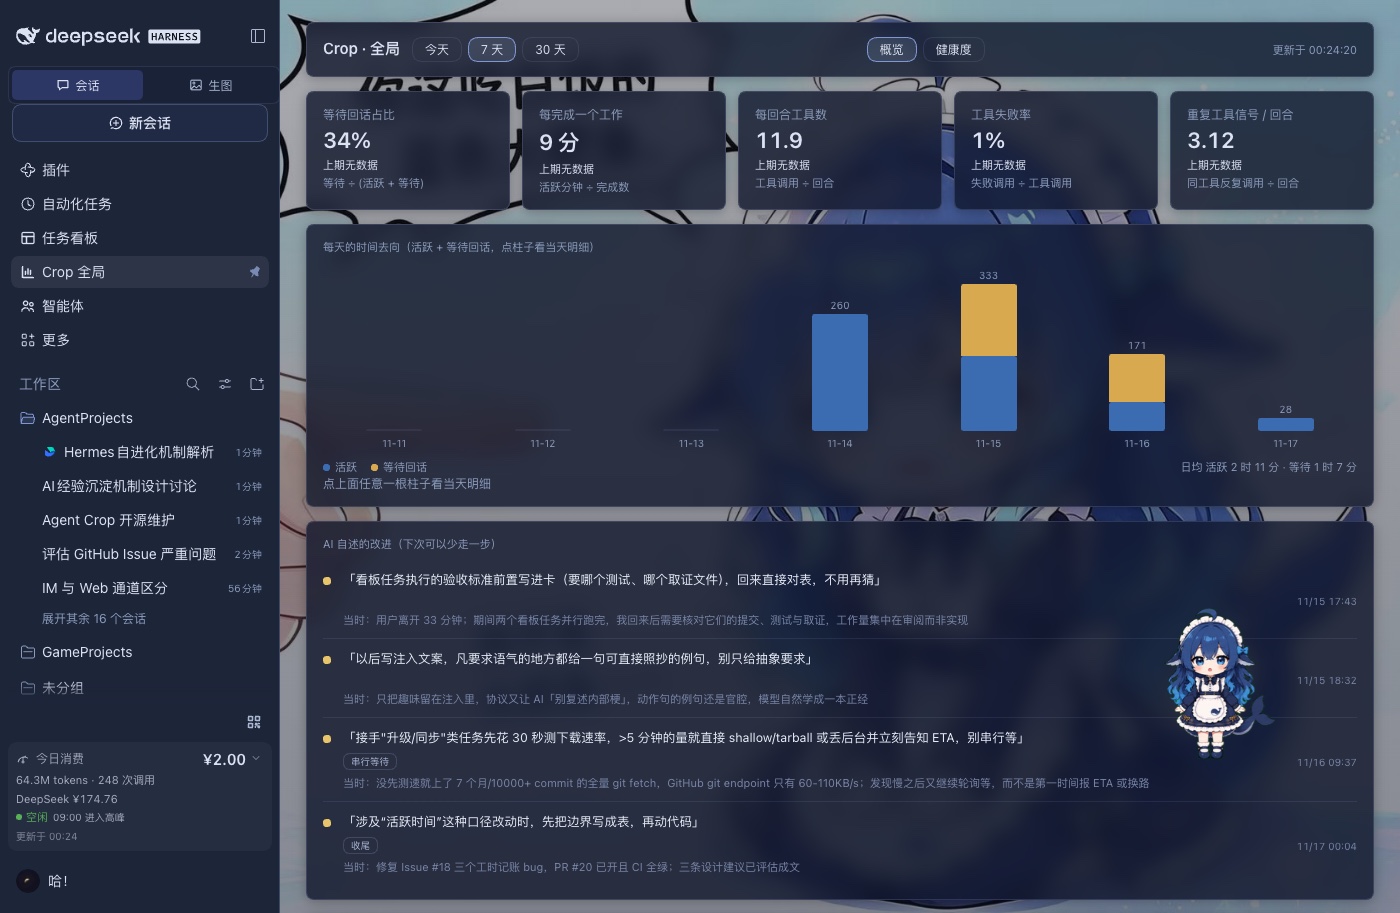
侧边栏 Crop 全局——跨会话的那一面:等待回话占比、每完成一个工作多少分钟、每回合工具数、工具失败率、重复工具信号密度;下面是每天的时间去向(活跃 + 等待堆叠柱,点柱子看当天明细)、AI 自述的改进、还在重复的坑、工作列表。
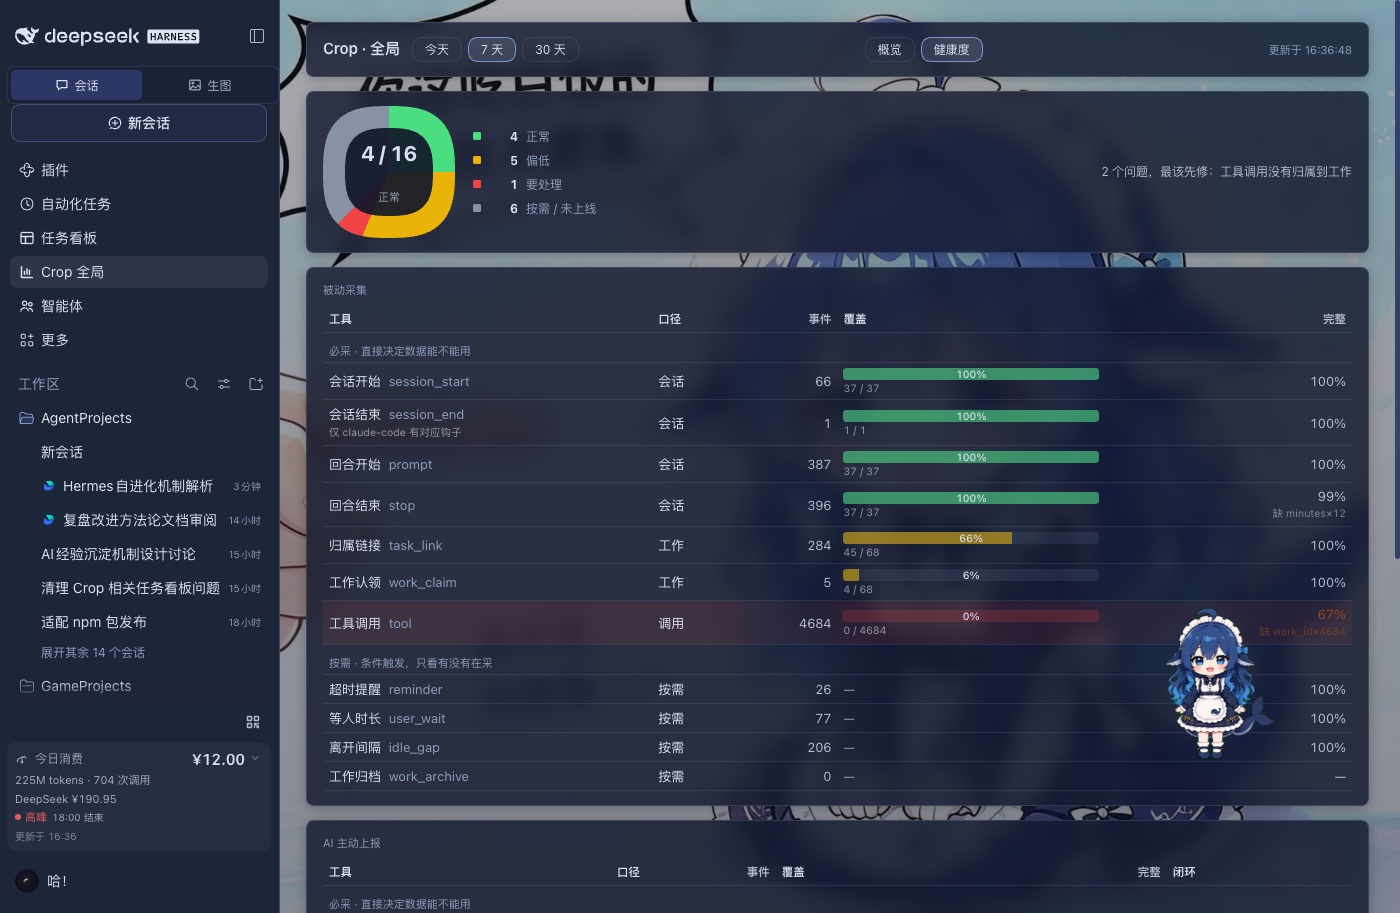
侧边栏「Crop 全局」的「健康度」视图(毛玻璃面板,壁纸透过来)——不看你这周干了什么,看采集器本身是不是哑了。
- 顶部四张卡:有效会话、收尾比、必采达标、异常工具。
- 健康构成:环形图一眼看出「多少正常、多少要处理」,旁边是图例计数(正常 / 偏低 / 要处理 / 按需+未上线)和一句「最该先修」。
- 两张表:被动采集、AI 主动上报;按「必采 / 按需 / 未上线」分组。
- 覆盖与闭环是彩色条:绿达标 / 黄偏低 / 红完全没采到;条内百分比、条下 n/N;红条所在行加红底。
- 趋势是每日事件条数的小柱图;缺字段标「缺 work_id×N」。
- 「只看异常」收掉正常行;主机下拉按 dsh / claude-code 分开看。
- 底部诊断清单按指标生成,每条带看板卡;「复制修复指令」拼成一段话可直接丢给 AI。
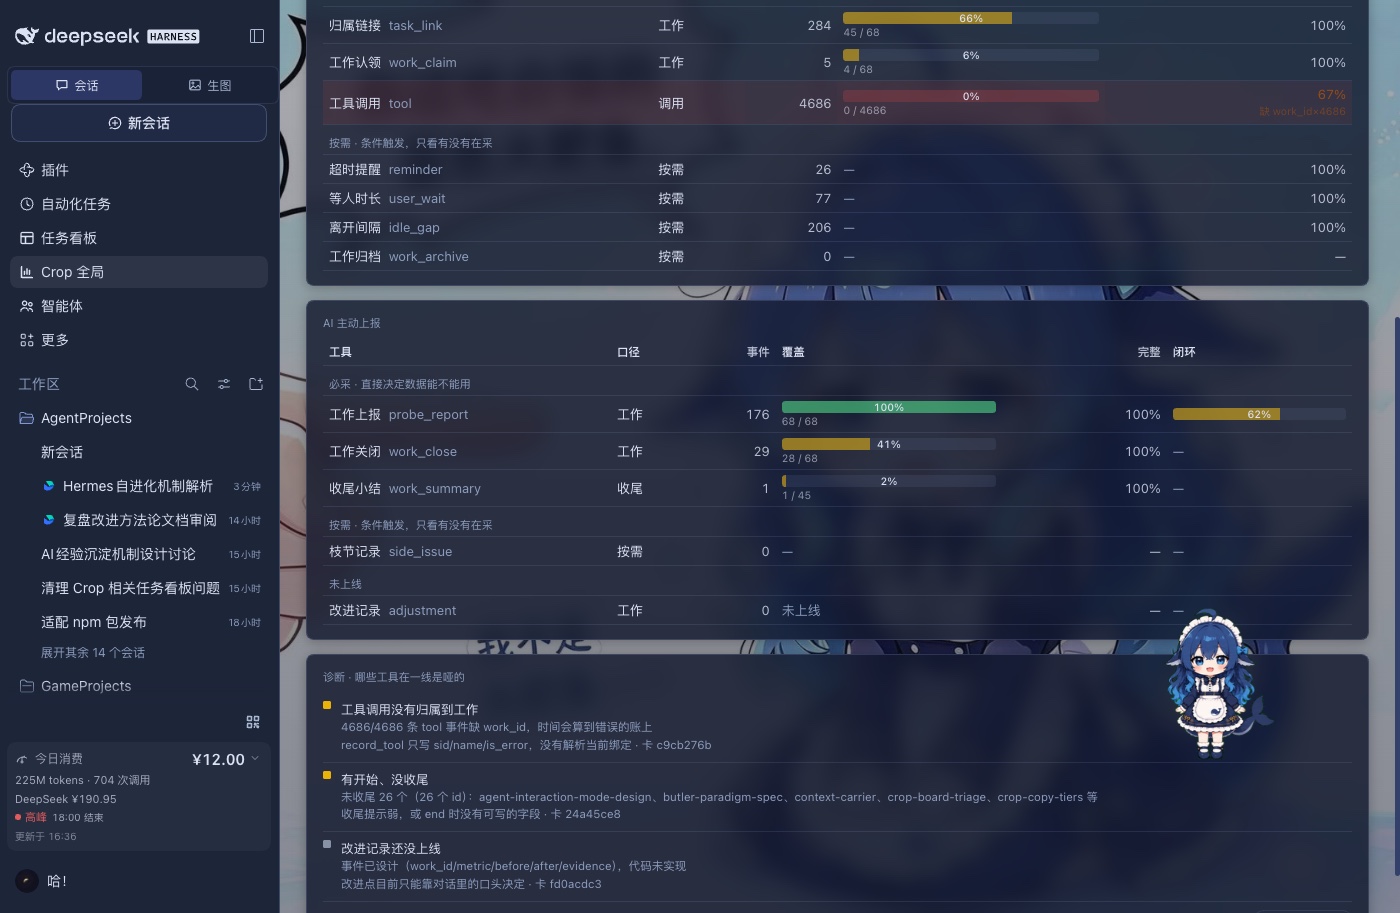
同一份健康度也给了 AI 和脚本两个入口:
crop health --days 7          # 人读:一句话结论 + 问题 + 每个工具一行
crop health --json            # 机器读:完整 health_summary
- DSH 插件:工具
crop_health(参数days/host),怀疑数据不可信时直接调。 - Claude Code(MCP):
crop_health,与crop_update并列暴露。
诚实说四点:
- 全局页只有堆叠柱,没有筛选、对比表、导出;健康度有表格和「只看异常」,但同样没有导出。
- 数据覆盖率不高:
type/difficulty经常空着,verdict/rework/improve的样本更少,所以「上期对比」经常显示「上期无数据」。 - 下一步先补协议(开工落类型、收尾必填判断),再谈趋势和归因——不然面板只能给你「总量」,给不了「提升」。
- 健康度的阈值(覆盖 ≥ 80%、字段完整 ≥ 95%)是先拍的,还没用真实数据校准;样本少于 3 个会话时它只报「样本太少」,不下结论。
安装与卸载
dsh plugin --profile <你的 profile> add agent-crop-dsh
# 重启 dsh,新会话生效
从 npm 装的是预构建产物:不需要在你的机器上跑构建脚本,也不用给 pnpm 的 allowBuilds 放行。
装完不用改配置、不用动 AGENTS.md——协议通过插件注册进系统提示,卸载时自动移除。
要改源码,再走克隆 + link 安装:
git clone https://github.com/oriliz/agent-crop.git ~/agent-crop
dsh plugin --profile <你的 profile> add ~/agent-crop
Claude Code 的装法见 docs/INSTALL.md。
自检(crop 命令随 npm 包发布,但 dsh plugin add 不会把它塞进 PATH):
npm i -g agent-crop-dsh   # 可选:让 crop 进 PATH
crop status                              # 最后一行会打印真实数据目录
tail -1 ~/.agentcrop/data/events.jsonl   # 应出现 "host":"dsh"
数据目录的历史名是
~/.ai-coding-efficiency,新版叫~/.agentcrop。如果你的机器上还没有后者,crop status最后一行打印的才是真实路径;想统一名字就ln -s ~/.ai-coding-efficiency ~/.agentcrop,或用KIT_SHARED_HOME覆盖。
不想全局装也可以直接跑包里的命令:
npx --yes --package=agent-crop-dsh -- crop status
卸载:
dsh plugin --profile <你的 profile> remove agent-crop-dsh
# Claude: claude plugin uninstall agent-crop@agent-crop
卸载不动数据。要一起清掉:rm -rf ~/.agentcrop
它记了什么、在哪记
宿主自动记
| 什么时候 | 记什么 |
|---|---|
| 会话开始 / 你发消息 | 工作区、任务块起点 |
| 每次工具返回 | 工具名、成功还是失败 |
| 回合结束 | 这一轮跑了多久 |
| 你下一次开口 | 等了你多久;超阈值记 idle_gap |
| 超红线 | 提醒注入了一次 |
| 同工具 / 文件反复失败 | 返工信号 |
AI 主动报
| 字段 | 什么时候填 | 可能的值 |
|---|---|---|
phase | 每次上报 | start 开工 / progress 有进展 / blocked 卡住 / end 收工 |
task_id | 每次上报 | 你给这件事起的短名,比如 refactor-auth |
summary | 每次上报 | 一句话:现在在做什么 |
cause | blocked 必填 | 一句话:为什么慢、卡在哪 |
next | 可选 | 下一步的具体动作 |
category | blocked 必填 | 九选一:serial-wait repeat-pitfall design-churn decision-batching tool-misuse no-evidence spec-drift human-wait other |
goal | 开工时 | 一句话目标 |
type | 开工时 | design / implement / debug / docs / explore,或自定义小写短 slug(如 research) |
difficulty | 开工时 | s / m / l |
category 是枚举,不是自由文本——填错直接失败。九类词表锁死,不会越记越乱。
这些只是判断,不是事实:自述永远不单独当结论,要和自动采集的时间、失败数对照着看。
数据只落本机 ~/.agentcrop/data(权限 0700),可用 KIT_DATA_DIR 覆盖。不存对话正文。
成本
只多花一点 Token,对速度几乎无感。
- 每回合多一行:注入 100–300 字符;卡住时 AI 上报一次,约 50–100 token。
- 不重读对话:总结基于结构化事件,不会把整段会话再塞回模型。
- 不拖时间:注入一行、上报一句,都是毫秒级。
一个 20 回合的工作,合计约 2k token。对比事后去会话里反查——一条中等会话就是几万 token,长的几十万,根本塞不进上下文。
它不做什么
- 不打分。 没有效率分,没有排行榜。
- 不上传。 数据只在这台机器上。
- 不改你的代码。 只观察;方案也只影响提示。
- 不替代 APM。 工具内部性能仍归 OpenTelemetry。
- 不给你老板看。 没有云,没有团队看板。
这是镜子,不是裁判。
文档
- docs/DESIGN.md — 设计原则与边界
- docs/EVENTS.md — 采哪些事件、怎么存、谁在用
- docs/SESSION-WORK.md — 会话与工作怎么绑定、怎么解绑、失效了怎么办
- docs/INSTALL.md — 四个宿主的安装与卸载
- docs/LONGEVITY.md — 长任务里怎么不被上下文冲刷掉
License
MIT — 随便用,随便改。
能动手的事,为什么要动口呢? 😏
Related plugins
webnovel-writer
lingfengqaq/webnovel-writer
loopx (dsh-loopx-plugin)
loopx-project/loopx
ouroboros (dsh-plugin)
q00/ouroboros
loopx (dsh-loopx-plugin)
huangruiteng/loopx