paper-dual-reducer
mount9527/paper-dual-reducer
Paper dual-reduction workbench for Chinese Word documents: reads a .doc/.docx in place without changing it, scores it with a local Chinese AIGC detector, runs a nine-dimension AI-trace diagnosis, and turns the result into batch rewrite prompts for any agent; the pasted-back edits are validated and applied through the paper-dual-reduce engine with tables, formulas, footnotes, TOC fields and citation marks left intact, then the frozen blocks are re-scored and the whole draft rolls back if its AI share rises. Adds a sidebar panel with a rewrite version chain of up to five passes, a three-column before/after comparison, downloadable per-version reports, and five paper_dual_* tools. The detector weights download on first run and are never bundled. Its HTTP routes have no DSH access check, so a web page open in your browser could call them.
Instalar
dsh plugin --profile web add github:mount9527/paper-dual-reducerREADME
dsh-paper-dual · 论文双降工作台(DSH 插件)
仓库:https://github.com/mount9527/paper-dual-reducer | 许可:插件代码 MIT AIGC 检测模型
yuchuantian/AIGC_detector_zhv3(Apache-2.0,基座chinese-roberta-wwm-ext亦为 Apache-2.0) 不随本仓库分发:权重由使用者首次运行时从 HuggingFace 自行下载,仓库里只有模型 id 字符串。详见LICENSE末尾的第三方说明。
左栏点开「论文双降」,填一条中文论文 .doc / .docx 的绝对路径,点「诊断」——只读原文件,不改它。
安装
插件走 npm 分发,包名 dsh-paper-dual;不需要下载安装包,GitHub Releases 只放版本说明,不放附件。
# 1) 按包名装(推荐;DSH 会在 npm 官方源与 npmmirror 之间自动选响应快的)
plugin_manager install_bundle dsh-paper-dual

# 2) 直接装 GitHub 的 tag(想用还没发到 npm 的改动时)
plugin_manager install_bundle github:mount9527/paper-dual-reducer#v0.8.1

# 3) 本地源码目录(改代码即时生效,开发时用)
plugin_manager install_bundle target="link:/abs/path/to/dsh-paper-dual"
装完重启客户端(Web 版整页刷新),侧栏出现「论文双降」即生效。命令行等价写法:
dsh plugin --profile web add -w dsh-paper-dual@0.8.1。
只装插件跑不起来:诊断、改写、预检、回填都要调引擎的 run.py,装完请在面板「设置」里
把引擎目录配好,否则点「诊断」只会得到 引擎目录里没有 run.py。见下面「依赖」一节。
七步演示
从装依赖到回填复检,真机跑一遍的完整链路(v0.8.0 截图;图中的论文路径与段落为演示样例):
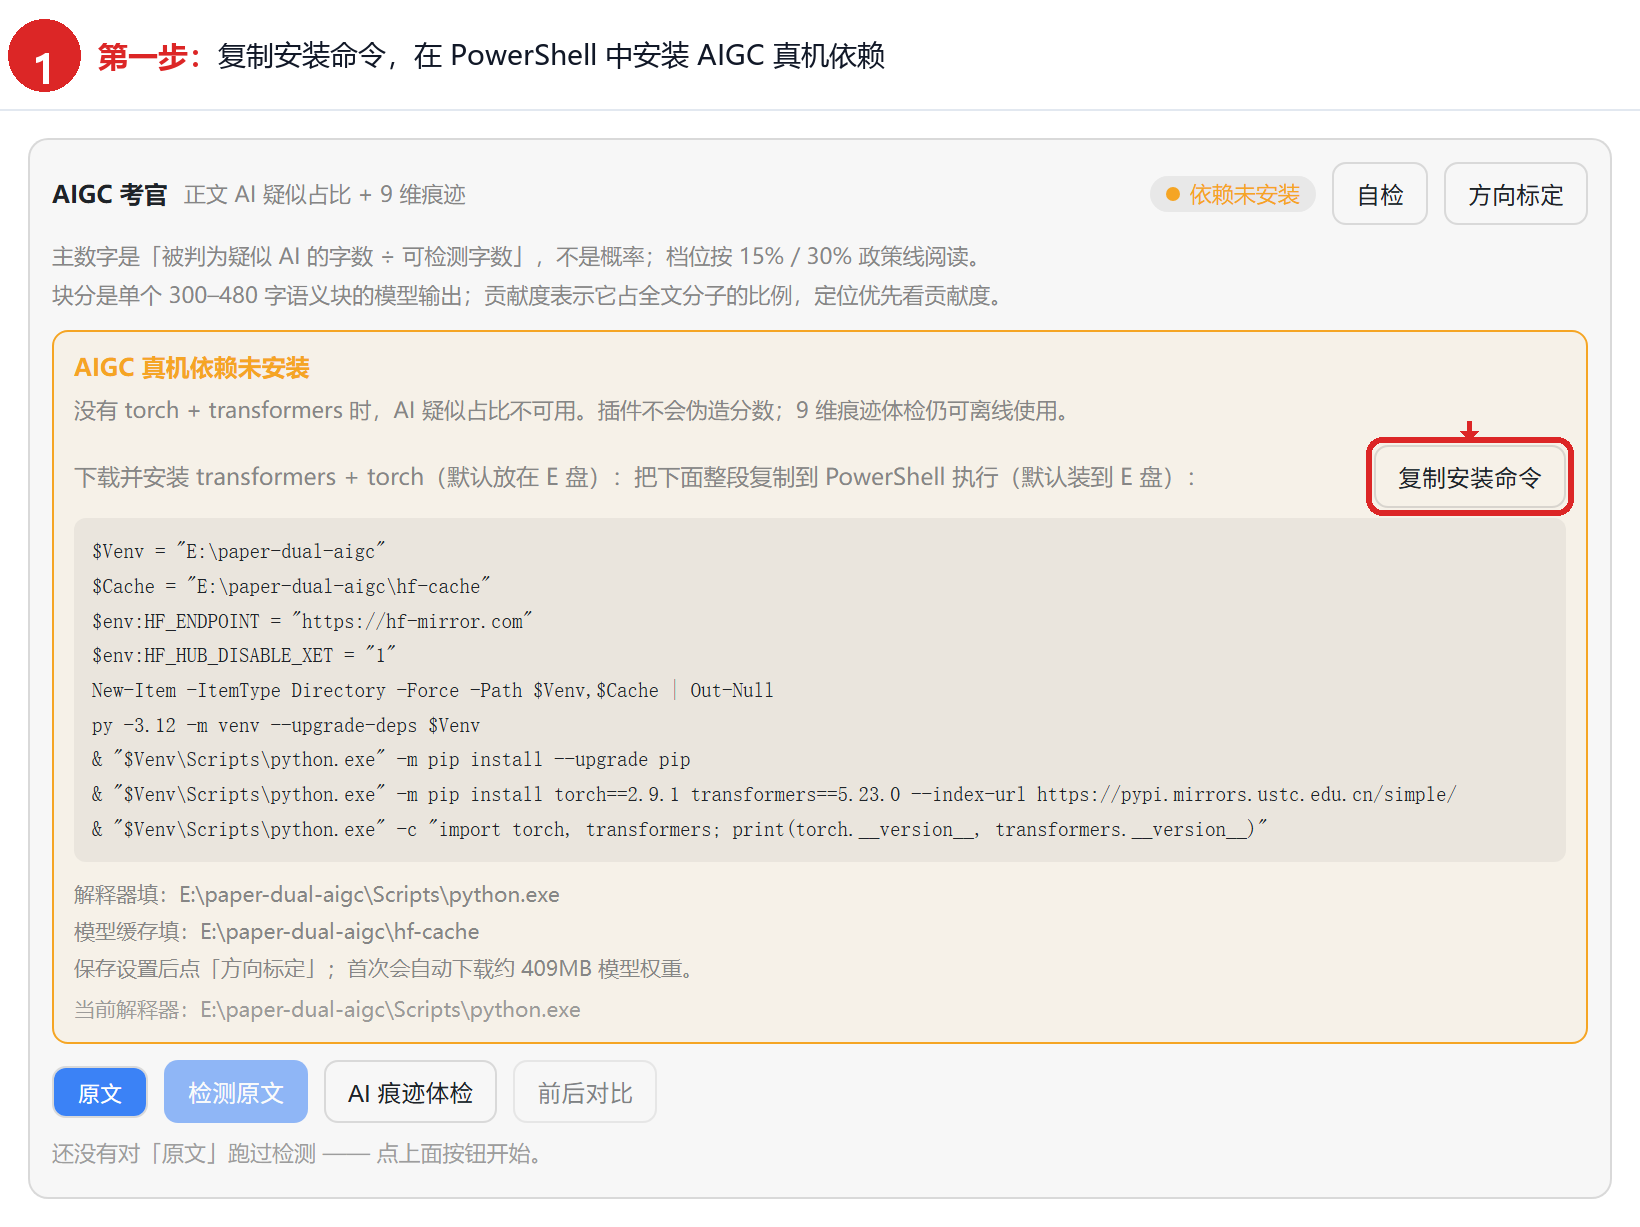
1. 装 AIGC 依赖 —— 没有 torch + transformers 时面板不会假装有分数,只给安装命令和后续三步。
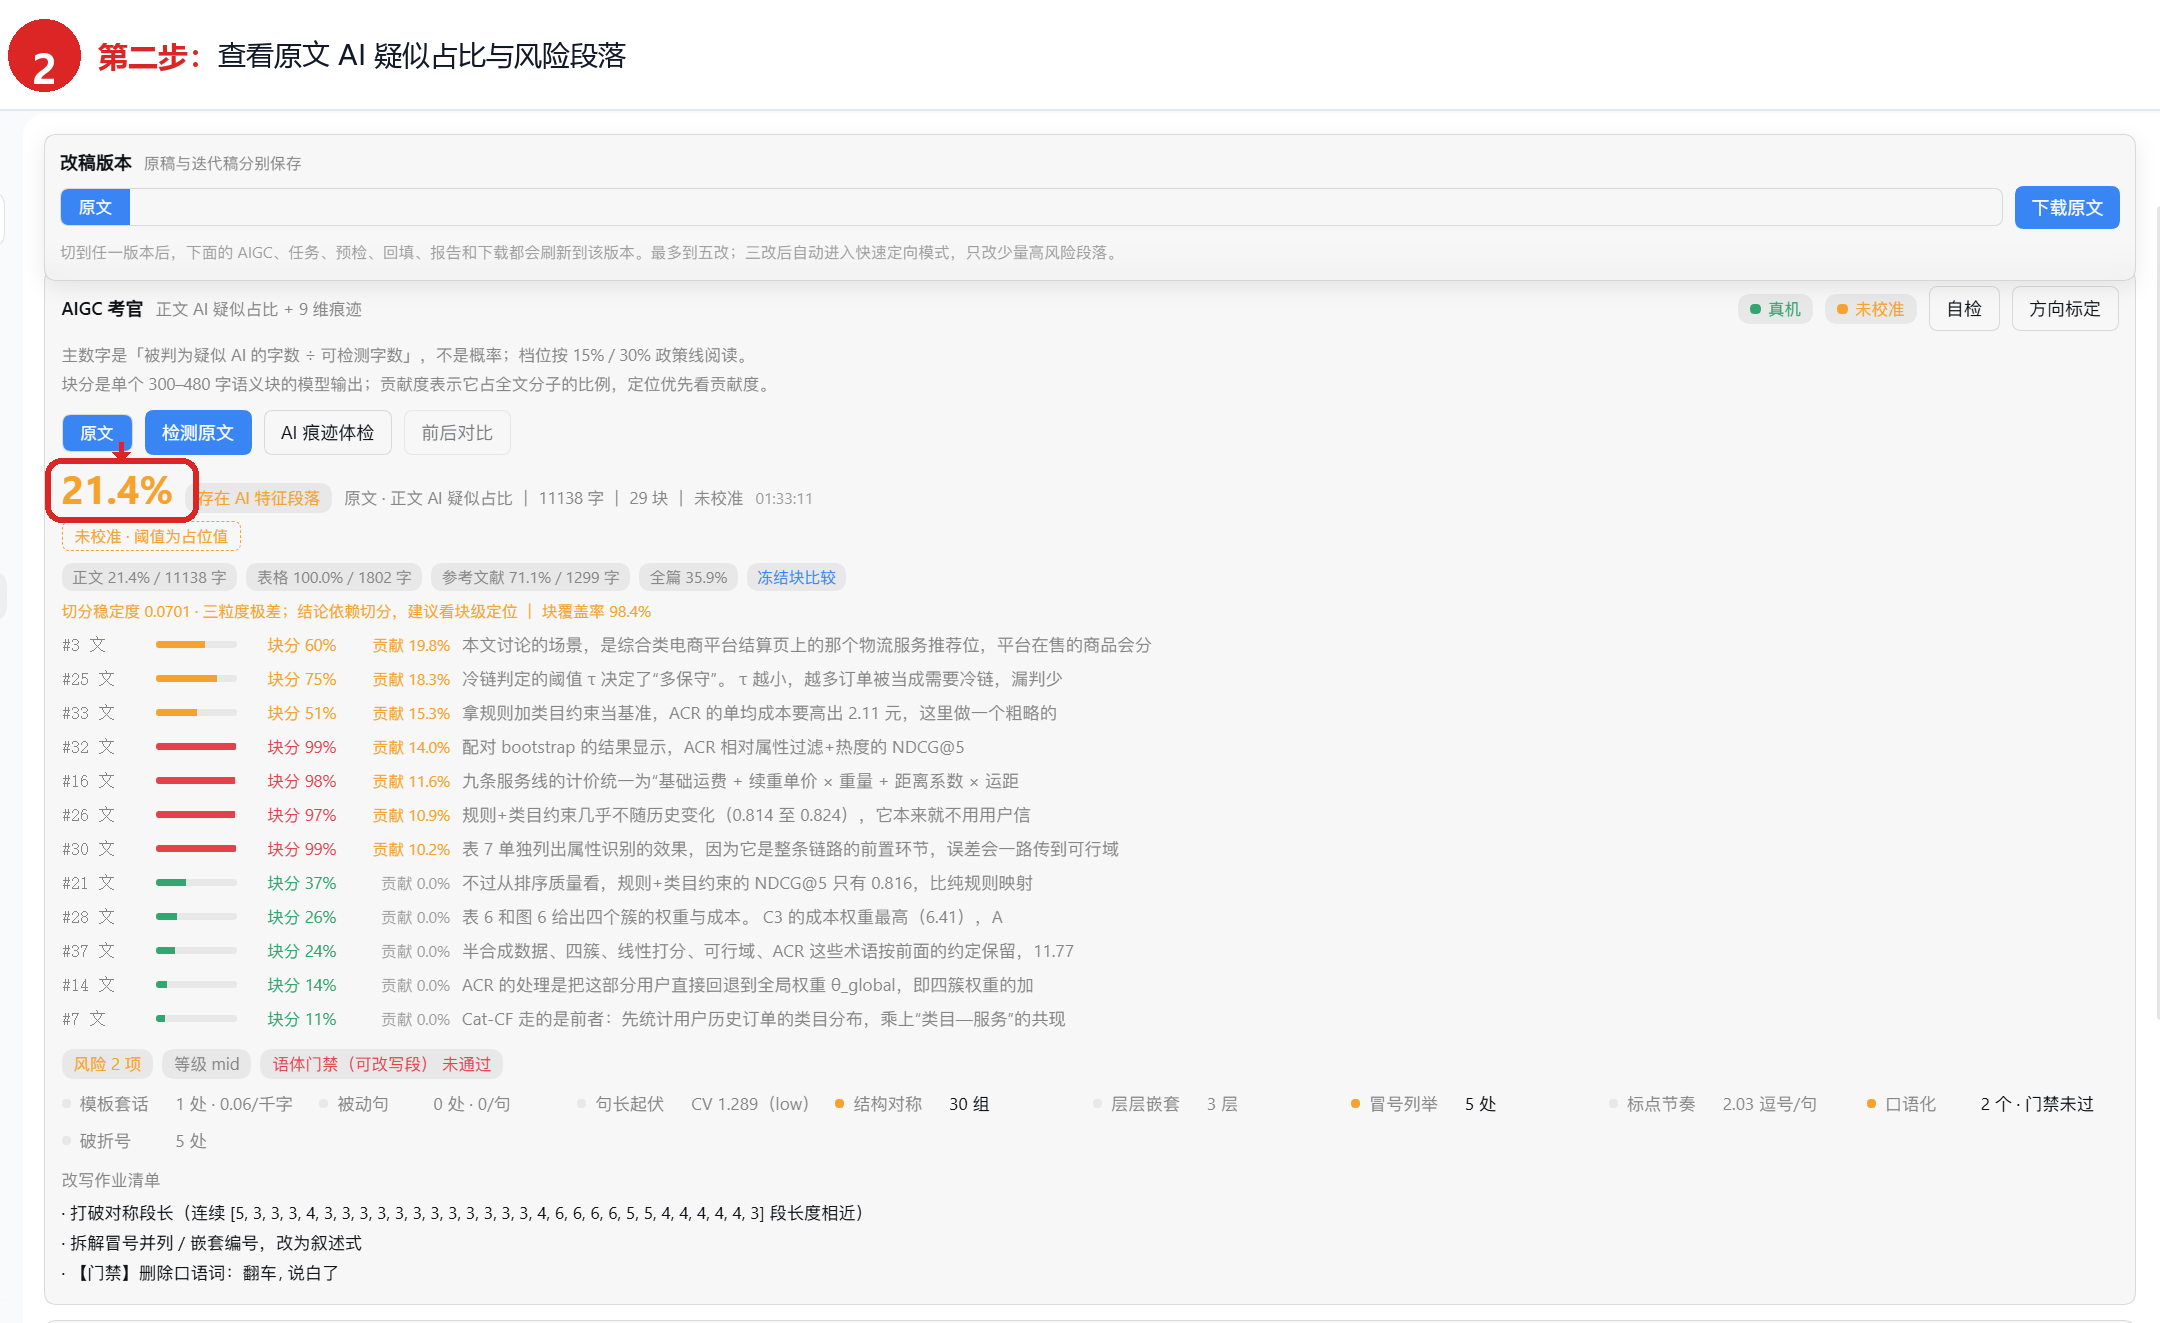
2. 查看原文检测结果 —— 正文 AI 疑似占比、档位、三粒度稳定度,块级只列可改写正文。
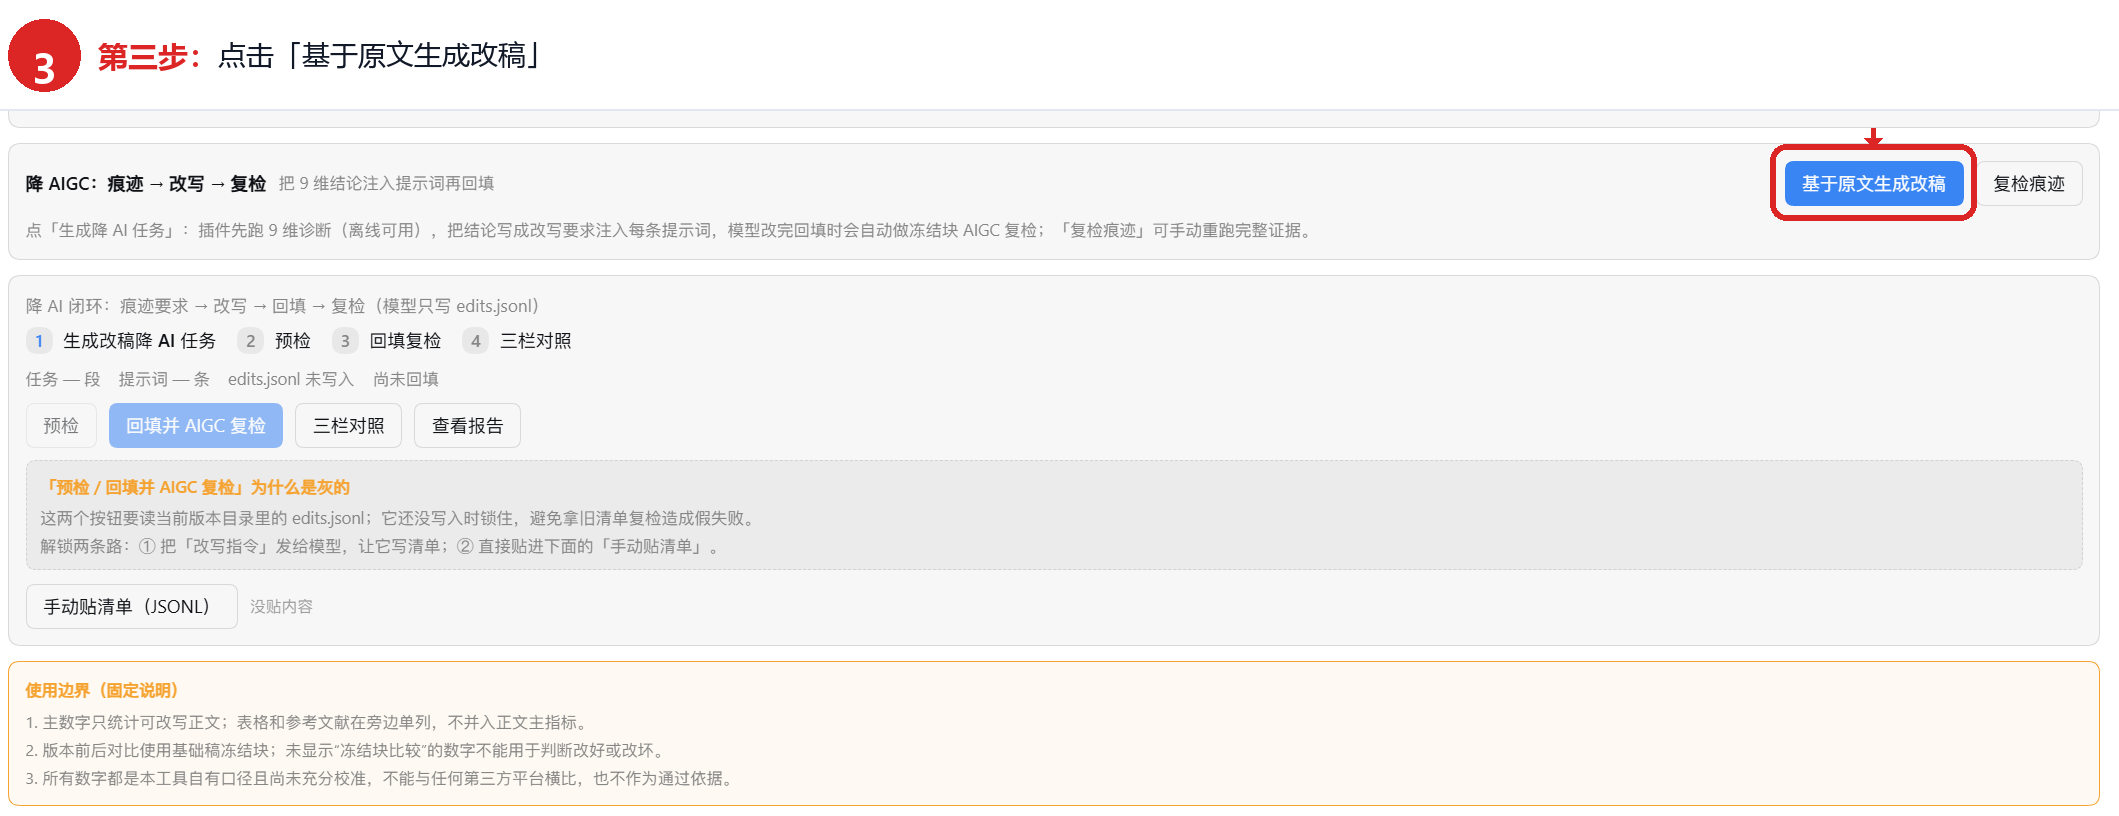
3. 基于原文生成改稿 —— 「基于原文生成改稿」先跑 9 维诊断,把结论写进每一批提示词。
4. 复制整段指令 —— prompts.jsonl 里的任务可整段复制,交给模型改写。
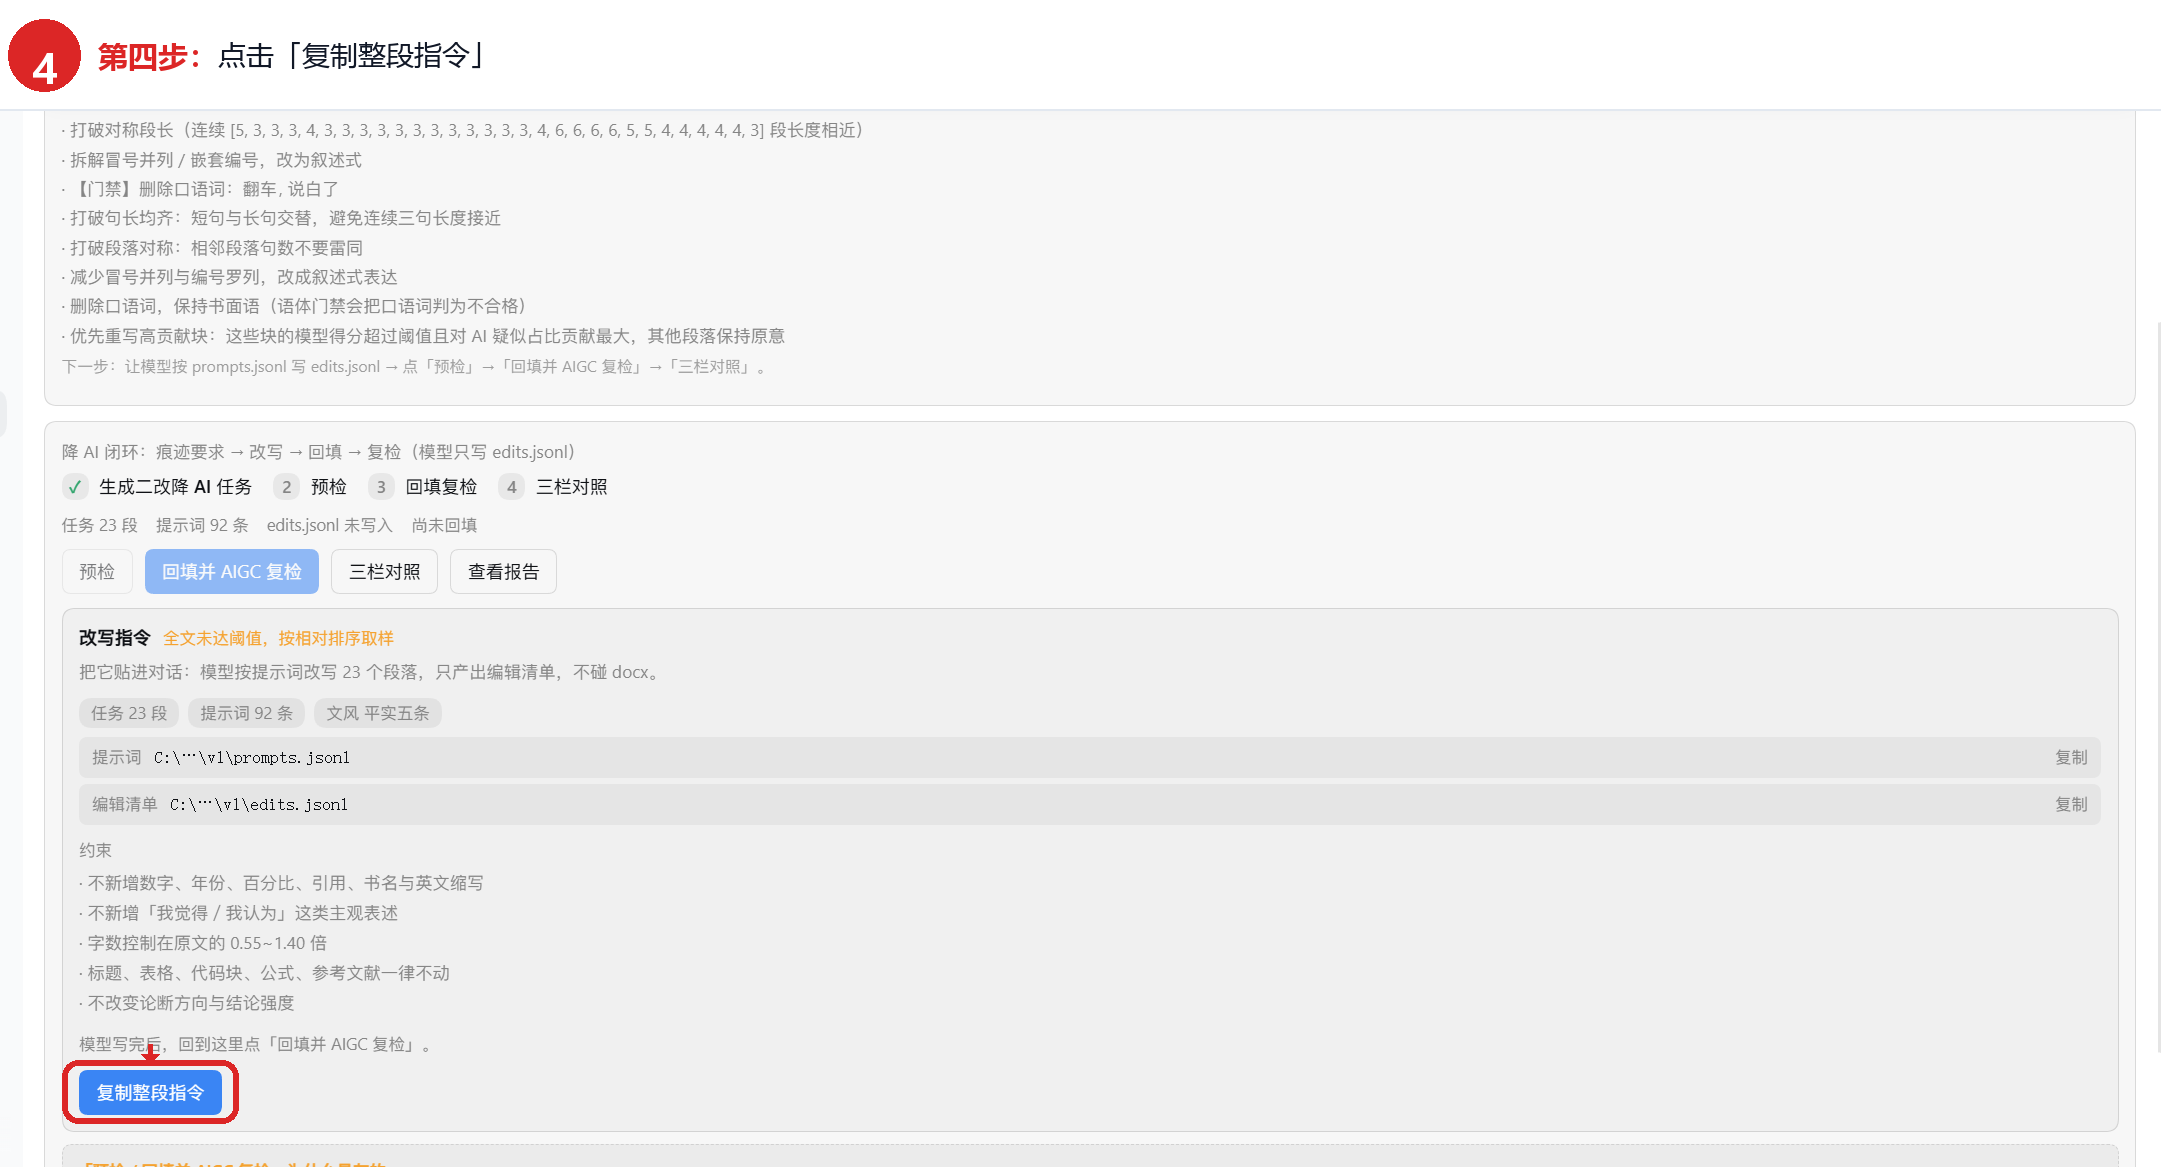
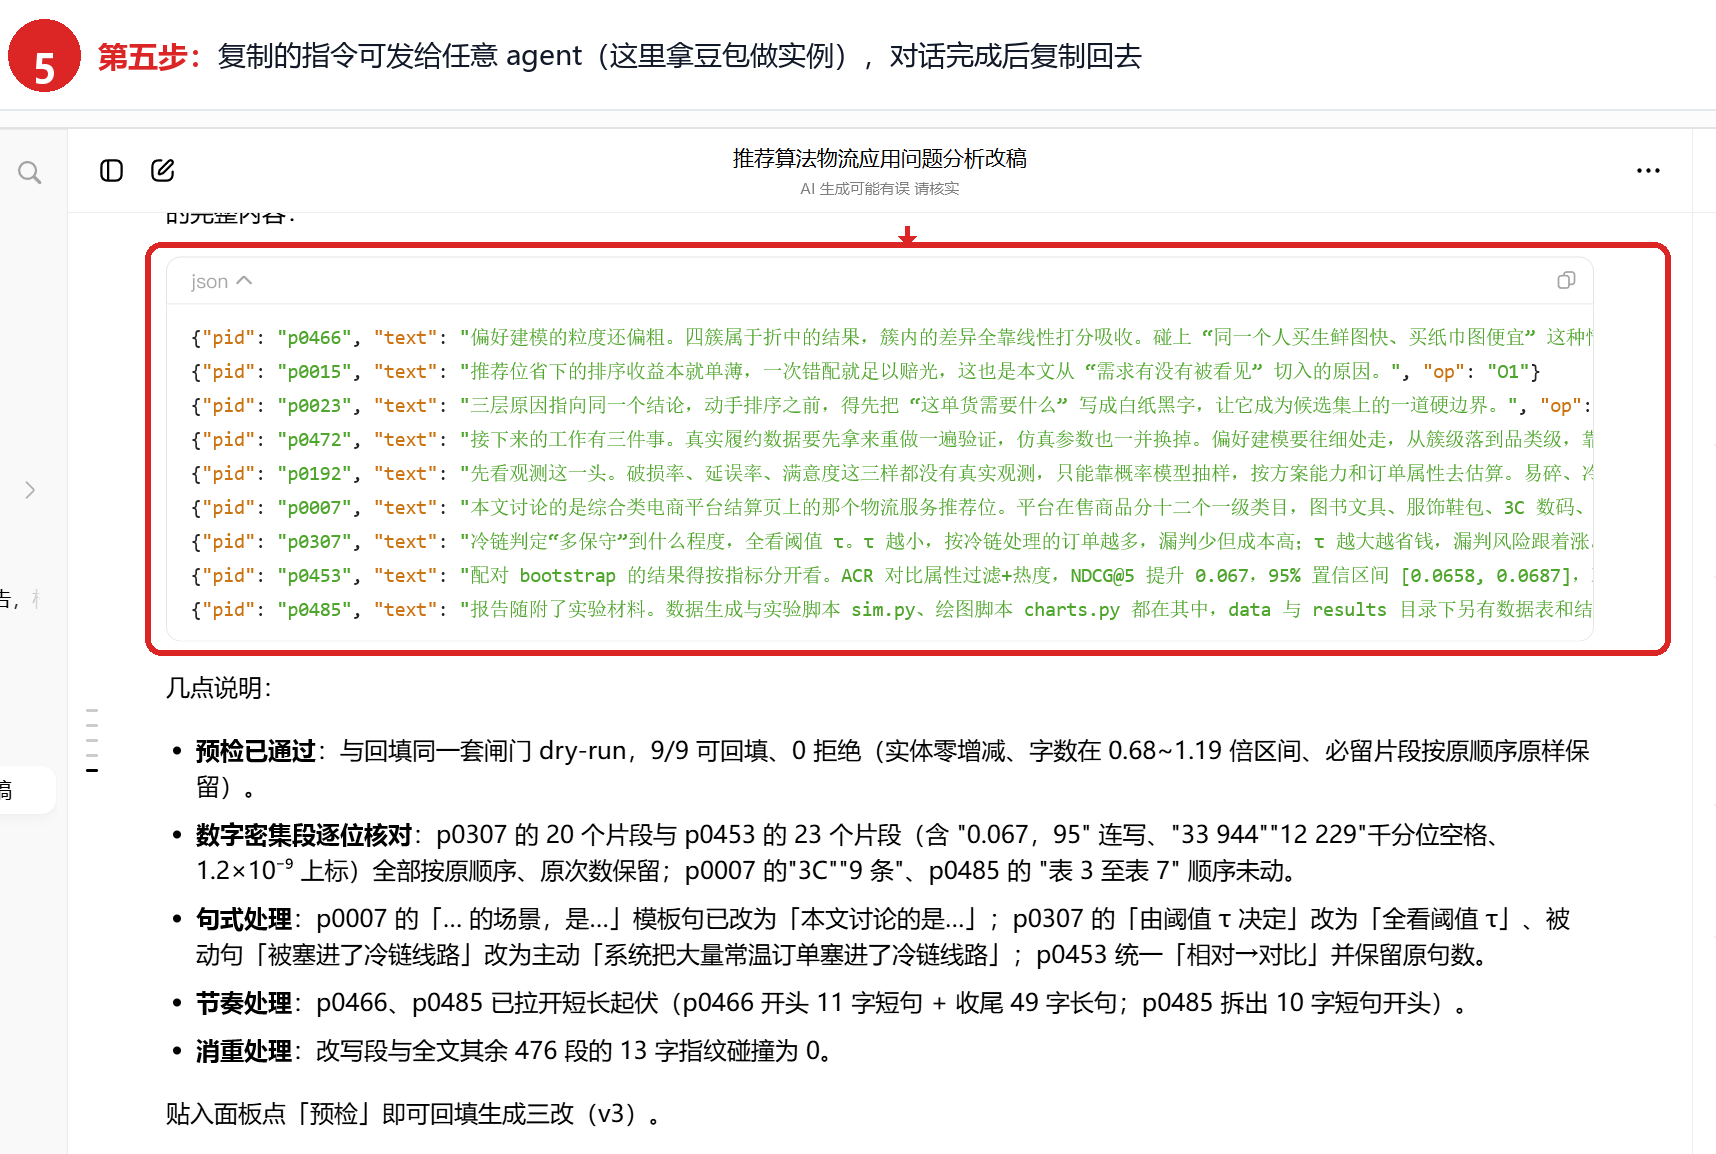
5. 发给任意 agent —— 贴给任意对话式 agent,让它按 {"pid","text","op"} 输出 edits.jsonl。
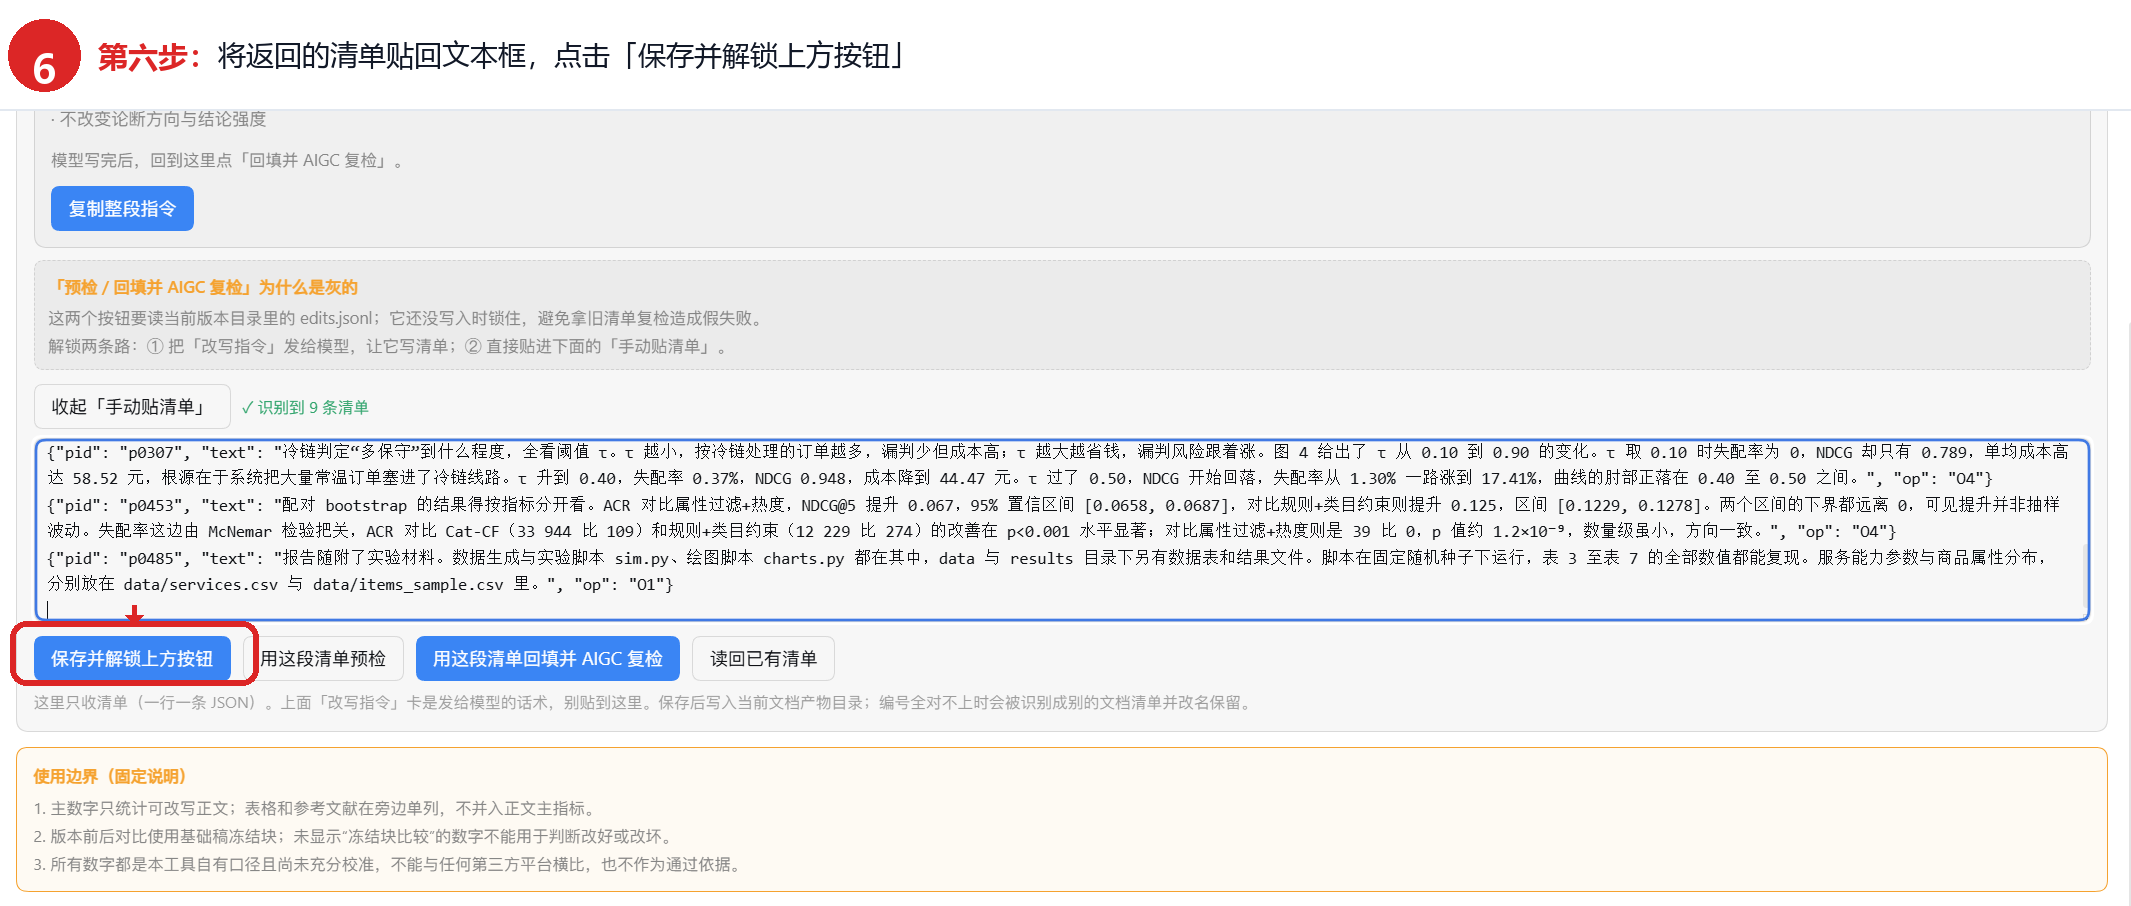
6. 贴回清单并保存 —— 清单贴回面板后实时校验、保存,再预检。
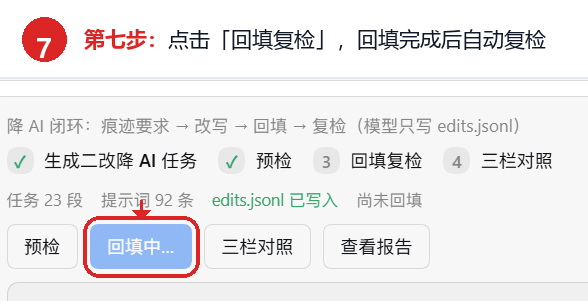
7. 回填复检 —— 回填后自动做冻结块 AIGC 复检,恶化就整篇回退,不会悄悄留下更差的稿。
v0.8.2:文档同步
- 只改文档:README 补「安装」一节(npm 包名 / GitHub tag / 本地
link:三种方式),并把引擎指向改到公开仓库、补齐缺引擎时的报错特征;代码与0.8.1完全一致 - 起因:0.8.1 发布时 README 里还没有安装命令,npm 页面读到的一直是旧说明,外部用户打开仓库找不到入手点
v0.8.0:冻结块比较、正文分账与强制 AIGC 复检
版本说明:
0.8.0在首次发布时撞上 npm 的暂存审核流程,版本号被占用后无法再次提交,因此0.8.1只递增了补丁号,功能无任何改动。
- 原文首次评分时生成
block-plan.json;后续版本复用同一pid_span、字符区间和块类型,避免重新切块造成分数抖动 - 主指标改为「可改写正文 AI 疑似占比」,表格、参考文献/附录、锁定/排除区分别统计
- 面板同时显示正文、全篇、表格、参考文献四个口径,块级定位只列可改写正文
- AIGC/双降模式回填后自动执行冻结块模型复检;正文占比上升、模型不可用或未冻结块时直接判失败并回退
- 纯降重模式仍按结构/实体/格式验收,不强制模型
- 0.8.0 实测同一 16k 字论文原稿/改稿均为 41 块、
pid_span零差异;正文占比 21.4%→26.7%,因此该改稿会被强制复检拒绝并回退
v0.7.0:AIGC 分数口径 v3
- 主指标从「段落块得分均值」改为「超阈值字数占比」
ai_share,均值只作旧数据兼容 - 新增 300–480 字语义切块:短标题、表格、代码碎片不再逐条送模型
- 默认按 300 / 400 / 600 三种粒度复算,取中位数并报告切分稳定度;
--fast只跑 400 字粒度 - 档位按 15% / 30% 政策线分为 safe / warn / risk,界面统一改称「AI 疑似占比」
- 新增
calib.json、bands.py、blocking.py;缺少配置时按规格回退,并明确显示「未校准」 - 改写前后比较、复检和下轮选段改用
ai_share与块贡献度;旧记录标为「旧口径」且不混算 - 面板固定显示三条边界说明:不可跨平台横比、以本校平台为准、阈值仅用于定位
v0.6.5:吸顶下载与自查修复
- 下载按钮固定到版本标签同一行,滚动后不会被成功提示遮住
- 普通成功提示不再吸顶覆盖版本栏;只有错误提示保持 sticky
- 错误与成功提示不再同时占据顶部
- 五改完成后不再显示“生成六改”,复检轮次上限同步为 5
- 重构当前待回填任务后仍保持原版本号,不额外消耗轮次
v0.6.4:三改后的快速续改与五改上限
- 硬上限为五改;宿主与界面同时阻止生成第六版,避免重复等待
- 三改后自动进入快速定向模式:只锁定少量高风险段落
- 每轮任务上限递减:双降从 16/10/6/4/2,降 AIGC 从 12/8/5/3/2
- 后续轮次复用上一轮逐段考官结果,减少重复真机推理
- 三改后的改写要求限制为最关键的前 6 条,缩短模型提示词
- 已生成但尚未回填的三改/四改/五改可用「快速压缩当前任务」原地重建,不新增版本、不浪费轮次
v0.6.3:清单解锁与版本栏可见性修复
- 修复“清单校验通过但保存按钮仍锁定”的死锁:保存按钮不再依赖尚未写入的
edits.jsonl - 保存成功后立即点亮“已有清单”,无需等待下一次刷新
- 错误和操作提示改为顶部 sticky,滚动到页面底部仍能看到结果
- 版本栏改为 sticky,并在 AIGC 卡内再次提供原文/改稿/二改/三改切换
- 已完成版本禁止覆盖旧清单;待回填版本才允许保存、预检和回填
v0.6.2:版本链、续改与下载
- 新增「改稿 / 二改 / 三改…」版本链;每一版保存独立的 docx、任务、清单、回填结果和判词
- 任意版本都可以作为下一轮基础稿,不需要下载后重新诊断
- 顶部版本栏显示原文与所有可切换版本;切换后 AIGC、任务、预检、回填、报告和三栏对照同步刷新
- 新增“下载当前版本”和
/download接口;没生成 docx 的待回填版本不会假装可下载 - 复检未达标的版本仍保留,可下载检查或继续作为下一轮输入,不会覆盖旧稿
v0.6.1:合并恢复本地优化
这一版以 v0.6.0 的真机 AIGC、逐段定位和自动回退为基础,补回 v0.5 的易用性能力:
.doc自动转.docx(Word COM / LibreOffice,原文件不动)- 运行记录按文档哈希隔离,最近 12 篇文档各自保留任务、回填、复检和 AIGC 结果
- 原文与改稿分别保存 AIGC 分数和 9 维诊断;改稿未生成时「改稿」tab 明确禁用
- 面板内「手动贴清单(JSONL)」:实时校验、保存、读回、预检和回填
- 原文在诊断后被修改时明确警告,并阻止用旧
doc.json/edits.jsonl继续回填 - 预检、回填按钮灰显时说明解锁条件和失败原因
不会伪造分数:缺少 transformers + torch 时只显示安装步骤,不生成 dry-run 分数。
面板里能做什么
打开面板先是入口页:填路径 → 诊断 → 选一个模式进入。三个模式共用同一条流水线
(生成任务 → 模型写 edits.jsonl → 预检 → 回填 → 复检),只是关注点不同:
| 模式 | 关注 | 能验什么 |
|---|---|---|
| 降低篇内重复率 | 13 字指纹找「自己抄自己」 | 重复率前后对比(离线可验) |
| 降低 AI 疑似占比 | 9 维痕迹诊断 → 写进提示词 → 改写 | 风险项/分数/语体门禁(离线可验)+ AI 疑似占比、档位与稳定性(需模型) |
| 双降 | 一次改写同时注入消重与 AIGC 痕迹要求 | 两者分别报告 |
每个模式内都是同一套按钮:生成改写任务 / 预检 / 回填并 AIGC 复检 / 三栏对照 / 查看报告。 「降 AI」「双降」的任务按钮在各自卡片内(生成降 AI 任务 / 生成双降任务),生成后同样走 预检 → 回填 → 三栏对照,进度条会显示「edits.jsonl 已写入 / 已回填,复检通过」。
双降不是两个模式的并排:一次改写把「9 维痕迹要求」和「消重要求」写进同一批提示词, 验收时看两边指标(篇内重复率、AIGC 风险项/分数、真机时的概率)。引擎只在单段重复占比 ≥ 45% 时才归因为内部重复并派 O9;没有重复段时,双降任务就只由 AIGC 侧驱动,面板会说明原因。
诊断
- 风险分布条(高/中/低)、段落 / 可改写 / 锁定统计、篇内重复率
- Top 12 高风险段落:点行展开原文,看主因与建议算子
改写闭环(四步)
| 步 | 动作 | 说明 |
|---|---|---|
| 1 | 生成改写任务 | 跑 run.py rewrite,出当前文档产物目录里的 prompts.jsonl;面板给出可复制的模型指令 |
| 2 | 模型改写 | 模型读 prompts.jsonl、写 edits.jsonl(一行一条 {"pid","text","op"}),也可在面板「手动贴清单」中粘贴、校验和保存 |
| 3 | 预检 / 回填复检 | 「预检」只跑闸门;AIGC/双降的「回填并 AIGC 复检」写 docx 后立即用基础稿冻结块复检,不过就整篇回退;纯降重只做结构复检 |
| 4 | 三栏对照 | 原文 / 改文 / 字数与句数变化,逐段列出 |
「查看报告」把 report.md 渲染成排版(标题层级、表格、引用、列表都成形,不再是一堵管道符),
支持横向滚动、复制 Markdown、一键收起。
AIGC 考官
- 「检测」:对原文或改稿跑 AIGC 检测器,给出正文 AI 疑似占比、档位、表格/参考文献分项 + 块级贡献度条
- 原文结果带有三粒度稳定度;后续版本使用基础稿冻结块,不再用“重新切块后的数字”判优
- 真机模式把可改写块映射回
pid_span,按贡献度选择下一轮改写目标;表格和参考文献不进入 top 改写列表 calib.json的calibrated=false会显示「未校准」水印,阈值不冒充平台标准- 「原文 / 改稿」各留一份结果,切 tab 显示对应口径;没有改稿时不会假装可检测
- 「9 维诊断」:模板套话 / 被动句 / 句长起伏 / 结构对称 / 层层嵌套 / 冒号列举 / 标点节奏 / 口语化 / 破折号,
并输出改写作业清单(
todo) - 「自检」:跑考官自带离线自检(22 项)
降 AIGC(v0.3.1 新增)
- 「生成降 AI 任务」:先跑 9 维诊断(离线可用),把结论翻译成改写要求,注入每一条提示词, 再生成改写任务;模型改完回填时自动做冻结块 AIGC 复检
- 「复检痕迹」:手动重跑完整证据,给出风险项/分数/语体门禁/正文、表格、参考文献分项对比
- 「自动回退」:任何离线/真机验收项恶化时,保留被拒改稿到
archive/,恢复上一版已验收accepted.docx;若没有已验收版本则恢复原文 - 「下一轮」:正文占比未下降时,从可改写块中挑出高贡献
pid,生成下一轮定向任务; 最多五改,避免无限迭代 - 完整方法与验收矩阵见
docs/design.md和aigc/SPEC.md(双降设计:降低 AI 疑似占比 + 篇内重复率)
AIGC 考官必须安装 torch + transformers。 未安装时插件会停止打分并显示安装步骤,
不会生成或显示伪造分数。diag.py 的 9 维痕迹诊断仍是纯正则,可离线使用。
Windows PowerShell 可直接复制执行(默认装到 E 盘;没有 E 盘时改前两行路径):
$Venv = "E:\paper-dual-aigc"
$Cache = "E:\paper-dual-aigc\hf-cache"
$env:HF_ENDPOINT = "https://hf-mirror.com"
$env:HF_HUB_DISABLE_XET = "1"
New-Item -ItemType Directory -Force -Path $Venv,$Cache | Out-Null
py -3.12 -m venv --upgrade-deps $Venv
& "$Venv\Scripts\python.exe" -m pip install --upgrade pip
& "$Venv\Scripts\python.exe" -m pip install torch==2.9.1 transformers==5.23.0 --index-url https://pypi.mirrors.ustc.edu.cn/simple/
& "$Venv\Scripts\python.exe" -c "import torch, transformers; print(torch.__version__, transformers.__version__)"
安装后在面板「设置」填写:
- python 解释器:
E:\paper-dual-aigc\Scripts\python.exe - AIGC 模型缓存:
E:\paper-dual-aigc\hf-cache
保存后点「方向标定」。首次会联网下载约 409MB 的 pytorch_model.bin,并自动完成 0/1 标签方向标定;这不等于语料刻度已校准。
状态与产物按文档路径哈希隔离在 ~/.dsh/paper-dual/docs/<文件名>-<哈希>/。运行历史保存在
state.json 的 runs 中,最近 12 篇文档各保留自己的任务、回填、复检和 AIGC 结果;重新诊断同一路径时,
上一批产物会移入 ~/.dsh/paper-dual/archive/,不会把旧 edits.jsonl 当成新文档的改写清单。
设置环境变量 PAPER_DUAL_STATE_DIR 可把状态目录重定向到别的磁盘或测试目录。
给 agent 的工具
| 工具 | 作用 |
|---|---|
paper_dual_status | 引擎目录、诊断/改写/复检进度、是否有待回填的清单 |
paper_dual_diagnose | 诊断一篇 .doc/.docx,返回风险分布与 Top 段落 |
paper_dual_rewrite | 为已诊断的论文生成改写任务与提示词 |
paper_dual_apply_edits | 写入 edits.jsonl → 预检 → 回填 → AIGC/双降强制冻结块模型复检 |
paper_dual_aigc | AIGC 考官:正文/表格/参考文献分项 + 档位/稳定度 + 块级 pid 定位 + 9 维诊断 |
依赖
引擎(必需):插件自身不解析 docx,诊断 / 改写 / 预检 / 回填 全部转去调引擎的 run.py。
- 引擎目录里要有
run.py、scripts/、lib/。公开代码在 https://github.com/mount9527/skill-paper-dual-reducer(同一套run.py+scripts/*.py, 子命令与产物和插件调用一一对应) - 三种指定方式,优先级从高到低:
- 面板「设置 → 引擎目录」填绝对路径(保存后立刻生效)
- 环境变量
PAPER_DUAL_ENGINE - 把引擎目录放到插件同级并命名为
paper-dual-reduce(自动探测顺序:插件同级 → 当前目录 → 家目录 →~/.dsh/skills/paper-dual-reduce)
- 没配好时的表现:
诊断/预检/回填返回引擎目录里没有 run.py:<目录>,并带needSetup: true,面板据此提示去设置页 python在 PATH(3.10+);引擎零第三方依赖- 插件本身不读 token、不写任何远端。首次安装 Python 依赖或首次下载 AIGC 模型权重时,
pip/transformers/ HuggingFace 会访问网络;模型权重不随本仓库分发
边界(别拿它当"过检测"用)
- 风险分是篇内相对指标,只用于同篇排序,跨文档不可比,不是任何平台的检测概率
- AIGC 考官给的是本工具自有口径下的正文 AI 疑似占比,不等于知网/维普/格子达的判定,也不与任何第三方平台横比
- 不模拟任何平台,不承诺通过率
- 标题、表格、代码块、公式、脚注、参考文献一律不改;不新增数字/引用/主观表述
- 改稿必须由作者复核
复现边界:本插件复现的是「检测 + 诊断 + 定向改写 + 分项验收 + 自动回退 + 下一轮任务」 的辅助闭环。模型写文本这一步仍由 agent/用户完成,插件不替作者生成论文内容;真机概率和 平台判定也不等同。
它相对笔灵做了什么、没做什么
对照 https://ibiling.cn/paper-ai-detect(REA/CDP 被动观察:Next.js + antd,
客户端 JSZip + docx-preview 解析文件,评分在服务端):
| 笔灵 | 本插件 |
|---|---|
| 上传 ≤3 万字 / 云端评分 | 本地路径、本机评分,文档不出机器 |
| 模拟三平台、全文 AI 率 % | 不模拟、不给百分比,只给等级与排序 |
| 逐段标注 | Top 12 + 展开原文 |
| 报告 / 降 AI 文件下载 | 面板内看报告;改稿由 run.py finish 出 docx |
| 检测记录、设备指纹 | 无(不追踪、不上传) |
开发
node --check index.js && node --check client.js
node tools/smoke.mjs "<论文.docx>"      # 不起 DSH 也能验证宿主路由
node tools/render.mjs "<report.md>"     # 报告渲染回归:块类型 / 表格 / 行内语法
node tools/privacy-check.mjs               # 发布包合规自查:语料 / 爬虫域名 / 凭据
宿主状态与换文档回归:
$env:PAPER_DUAL_ENGINE = "<paper-dual-reduce 目录>"
$env:PAPER_DUAL_PYTHON = "E:\paper-dual-aigc\Scripts\python.exe"
$env:HF_HOME = "E:\paper-dual-aigc\hf-cache"
$env:HF_HUB_CACHE = "$env:HF_HOME\hub"
node tools/regression.mjs "<论文一.docx>" "<论文二.docx>" "<edits.jsonl>"
它会验证:版本号一致、不同文档产物目录隔离、rewrite 传新路径会先诊断、
真机模型打分、缺依赖时不产生伪分数、自动回退、下一轮定向任务和上传中文文件名。
装进 profile / 热重载:
plugin_manager install_bundle target="link:<paper-dual-reducer 目录>"
plugin_manager set_plugin target="include:dsh-paper-dual" enabled=false   # 再 true
宿主侧坑:apply(ctx) 里用 ctx.webServer / ctx.tools 必须在模块里
export const inject = ['webServer', 'tools'],否则激活报
cannot get property "webServer" without inject。
Plugins relacionados
archify (deepseek-harness)
tt-a1i/archify
WeKnora (dsh-weknora)
tencent/weknora
next-ai-draw-io (dsh-plugin)
dayuanjiang/next-ai-draw-io
weknora
tencent/weknora