dsh-event-fix
sshooting/dsh-event-fix
只读分析 DeepSeek Harness 会话中每一步的报错与无效动作:统计工具与命令失败、模型重试、重复调用、轮次中断和空转步,并归因对应浪费的 token 与耗时。它的 HTTP 路由没有 DSH 的访问检查,浏览器里打开的网页可以调用它们。
安装
dsh plugin --profile web add github:sshooting/dsh-event-fixREADME
dsh-event-fix
DSH 会话日志的 step 级错误统计与浪费核算。
它不改请求、不改工具、不调模型;只读取事件流,回答「哪些 step 白干了、白花了多少 token 和时间」。
dsh-event-fix 是 DeepSeek Harness(DSH)的一个只读分析插件。定位很窄:event sourcing 里的一个小分支——
只解释那些语义明确的会话事件(工具报错、模型重试、轮次中断、重复调用、空转步),
不做意图判断,也不假装能评价「这次回答好不好」。
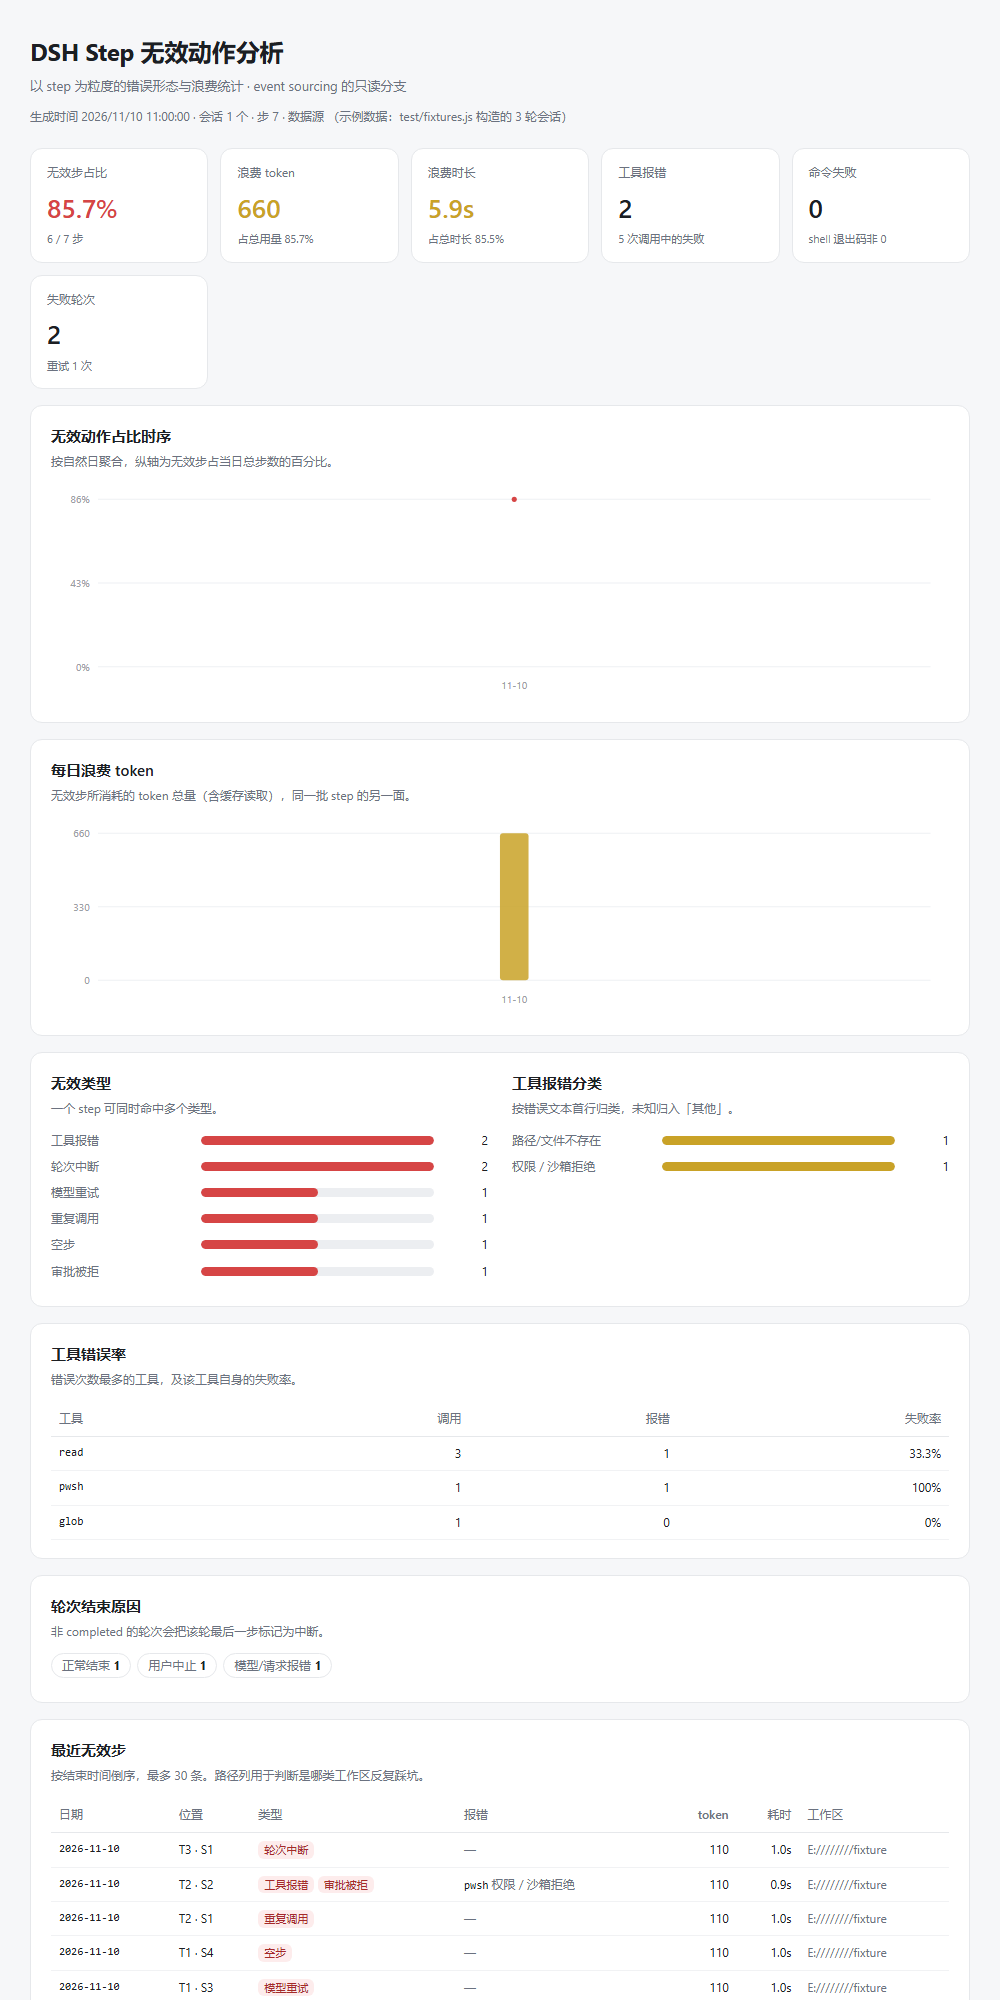
四个问题
1. 一个会话里,哪些 step 是无效动作?
以 step 为粒度归因,每一条无效步都能对上原始事件:
| 无效类型 | 判定依据(事件) | 说明 |
|---|---|---|
| 工具报错 | tool/result 的 isError = true,message 级与 part 级都算 | 最硬的一类,按错误文本再分类 |
| 命令失败 | shell 结果出现 [exit code: 非0],或 command/done.kind = error | DSH 不把命令失败当 isError,必须读退出码 |
| 模型重试 | 同一步内出现 llm/retry | 说明该步的首次请求失败,token 白付 |
| 轮次中断 | turn/end.reason.kind ≠ completed | 归因到该轮最后一步 |
| 重复调用 | 与本会话早前 name + arguments 完全一致 | 若两次调用之间有成功写入,则不算重复 |
| 空转步 | 一步既无文本也无工具调用 | 只有 reasoning 也算空转 |
| 审批被拒 | approval/decided.outcome ∈ rejected/cancelled | 用户明确拒绝的动作 |
工具结果在日志里有两种结构,都要读,否则会漏掉一大半失败:
扁平  { message: { role: 'tool', isError: true, content: [{ type: 'text', text }] } }          # 只用来表示失败
嵌套  { message: { role: 'user', content: [{ type: 'tool-result', isError, toolCallId,
               content: [{ type: 'text', text }] }] } }                                        # 成功与失败都用它
嵌套结构的 source 只带 callId 不带工具名,工具名要用早前的 tool/call 回填。
2. 一共浪费了多少 token 和时间?
- 浪费 token = 上述无效步实际发生的
usage之和(input / output / cache read / cache write)。 这是「无效动作附带的算力」,不是账单;缓存读取单价低,所以 token 占比通常高于费用占比。 - 浪费时长 = 无效步
step/end - step/start的墙钟时间之和,模型重试的退避时间包含在内。 - 两个指标都同时给出绝对值与占比,避免只看占比产生错觉。
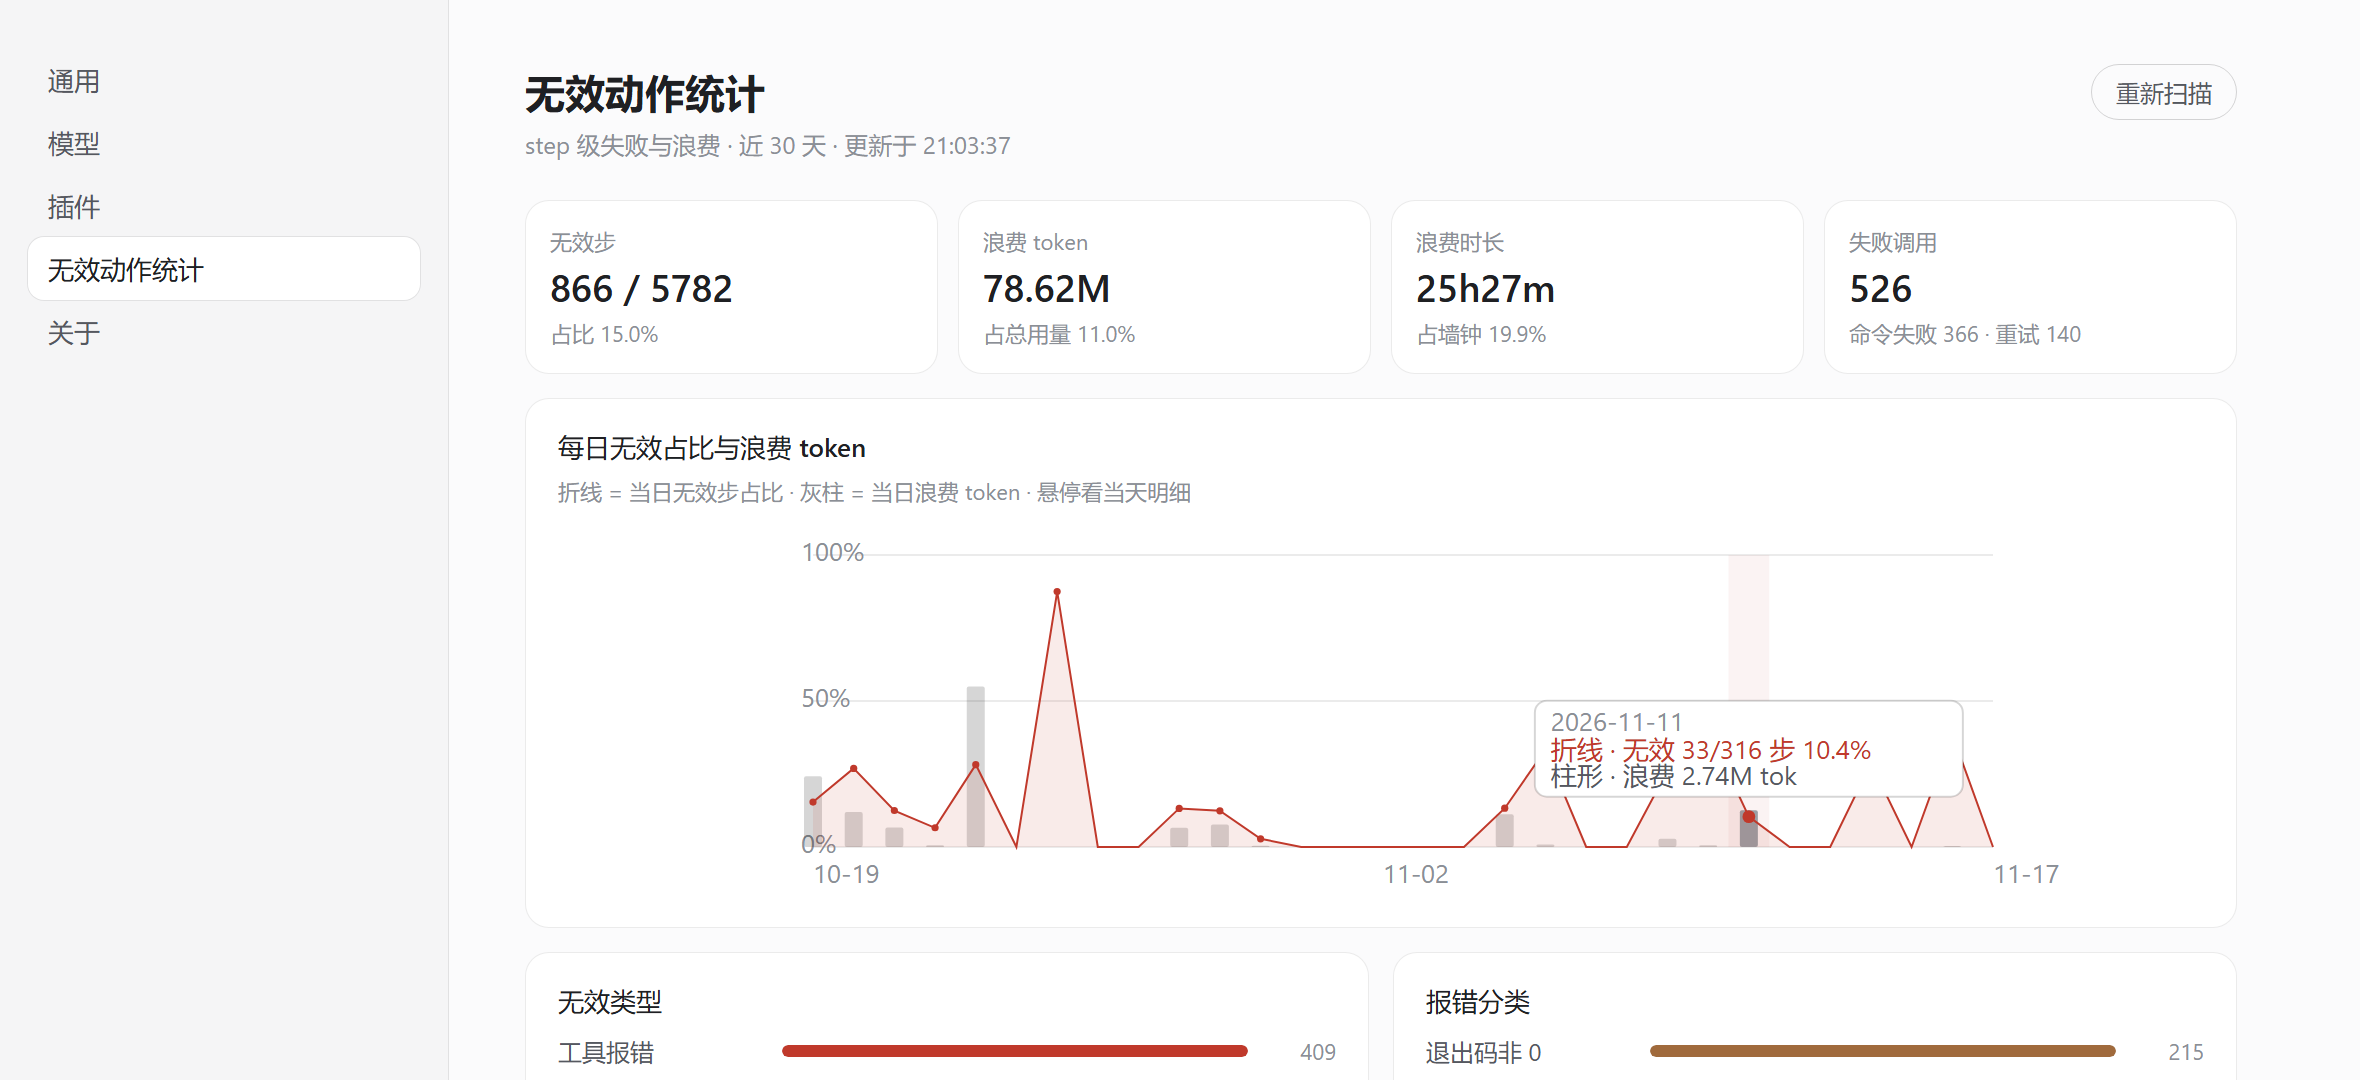
3. 无效动作的占比随时间怎么变?
- 会话内:面板里的「每轮无效占比」折线,一眼看到哪一轮开始跑偏。
- 跨会话:设置页按自然日聚合,给出占比时序 + 每日浪费 token。
- 图是可悬停的:鼠标移到任意一天,会高亮该日的柱子与折点,并当场给出
「日期 / 无效 x/y 步 z% / 浪费 n tok」。空白日显示
当天无 step而不是0%—— 没有执行和「执行了但全对」是两件事。
4. 失败之后,agent 做了什么?
这一节回答的是「失败本身不是问题,失败后的反应才是」。以每一次失败为起点, 沿着同一轮里的下一次调用看它怎么接:过程序里叫失败回合(failure episode), 一个回合由「失败 → 下一次调用 → 那次调用的结果」三段组成。
       失败调用 A                     下一次调用 B               B 的结果
  ┌──────────────────┐        ┌──────────────────────┐    ┌────────────┐
  │ same 原样重试    │──┐     │ 认定「故意重试」的只有 │    │ ok  → 恢复 │
  │ changedArgs 改参 │──┼───▶ │ 这一种                │──▶ │ fail → 仍失败│
  │ changedTool 换工具│─┘     │ 后两种是「换路子」     │    │ 无结果 → 未知│
  └──────────────────┘        └──────────────────────┘    └────────────┘
            │
            └── 这一轮结束了还没有下一次调用 ──▶ 放弃(abandoned)
实测结论和直觉相反,也正是这个指标值得做的原因:
| 失败后的动作 | 次数 | 下一步成功 | 怎么读 |
|---|---|---|---|
| 改参数再试 | 420 | 74% | 默认行为,最容易掉进「在参数上反复调」 |
| 换工具 | 288 | 92% | 明显更有效,但 agent 用得少 |
| 原样重试 | 0 | — | 罕见(708 次里只有 2 次字节级重试) |
| 放弃 | 25 | — | 这一轮没再试 |
- 「重试率」单独看是没有意义的:字节级的原样重试只占 0.3%。 真正该看的是动作分布 × 成功率,它把「怎么试」和「试得对不对」放在同一张表里。
- 换工具 92% vs 改参数 74% 这条差距(18 个百分点)是可执行的结论: 失败时更该换路子,而不是在参数上反复调。
- 下一步成功率的计算是严格同轮次的:跨轮次的动作不算「对上一次失败的反应」, 否则「用户又问了句话,agent 顺手 read 成功」会被算成恢复。
- 恢复的归属记在失败的那个工具上,不记在补救成功的工具上——
要修的是
pwsh,不是把功劳给read。
页面上的「失败最多的工具」表因此多了一列 失败后下一步(76% · 280/369),
低于 50% 标红:这个数低,说明该工具失败后经常把整轮带进死胡同。
真实数据样例
本机最近 150 个 DSH 会话、5782 个 step 的实测结果(2026-11-17,v0.3.0 口径, 是设置页「近 30 天」默认窗口):
无效步 866(15.0%) · 浪费 token 78.62M(11.0%) · 浪费时长 25h27m(19.9%)
失败调用 526(命令失败 366 · 模型重试 140)

无效类型:工具报错 409 / 命令失败 329 / 重复调用 67 / 模型重试 61 / 轮次中断 53 / 空步 40 / 审批被拒 3
报错分类:退出码非 0 215 / 网络 176 / 跨域重定向 99 / 其他 73 / 权限 67 / 超时 65 / 路径 49 / 限制 45

失败回合 733 → 下一步成功 574(78.3%) · 仍失败 134(18.3%) · 放弃 25(3.4%)
改参数再试 420(74% 成功) · 换工具 288(92% 成功) · 原样重试 0

Top 工具:pwsh 414/2902(14.3%)· web_fetch 297/1704(17.4%)· subagent 44/103(42.7%)
         web_search 52/779(6.7%)· edit 29/658(4.4%)
几点值得注意的结论:
subagent的失败率 42.7%,是所有工具里最高的,是最值得优先修的一类。web_fetch17.4%、pwsh14.3%:两个高频工具都在「六分之一的调用是白跑」的量级。- 命令失败 366 次:这些在旧口径里完全不可见——DSH 不把 shell 非零退出当
isError, 只看isError会让 pwsh 的失败率从 14.3% 掉到 1.5%。 - 时长浪费比例(19.9%)高于 token 比例(11.0%):无效步主要烧在工具等待上,不烧 token 但烧时间。
- 失败后 78.3% 能接回来,真正的损失集中在 25 次直接放弃和 134 次「换了还是错」。
四种用法
1. 设置页:跨会话汇总(推荐入口)
DSH → 设置 → 左侧导航「无效动作统计」。页面自己拉 GET /dsh-event-fix/stats,
不用开会话、不用敲命令:
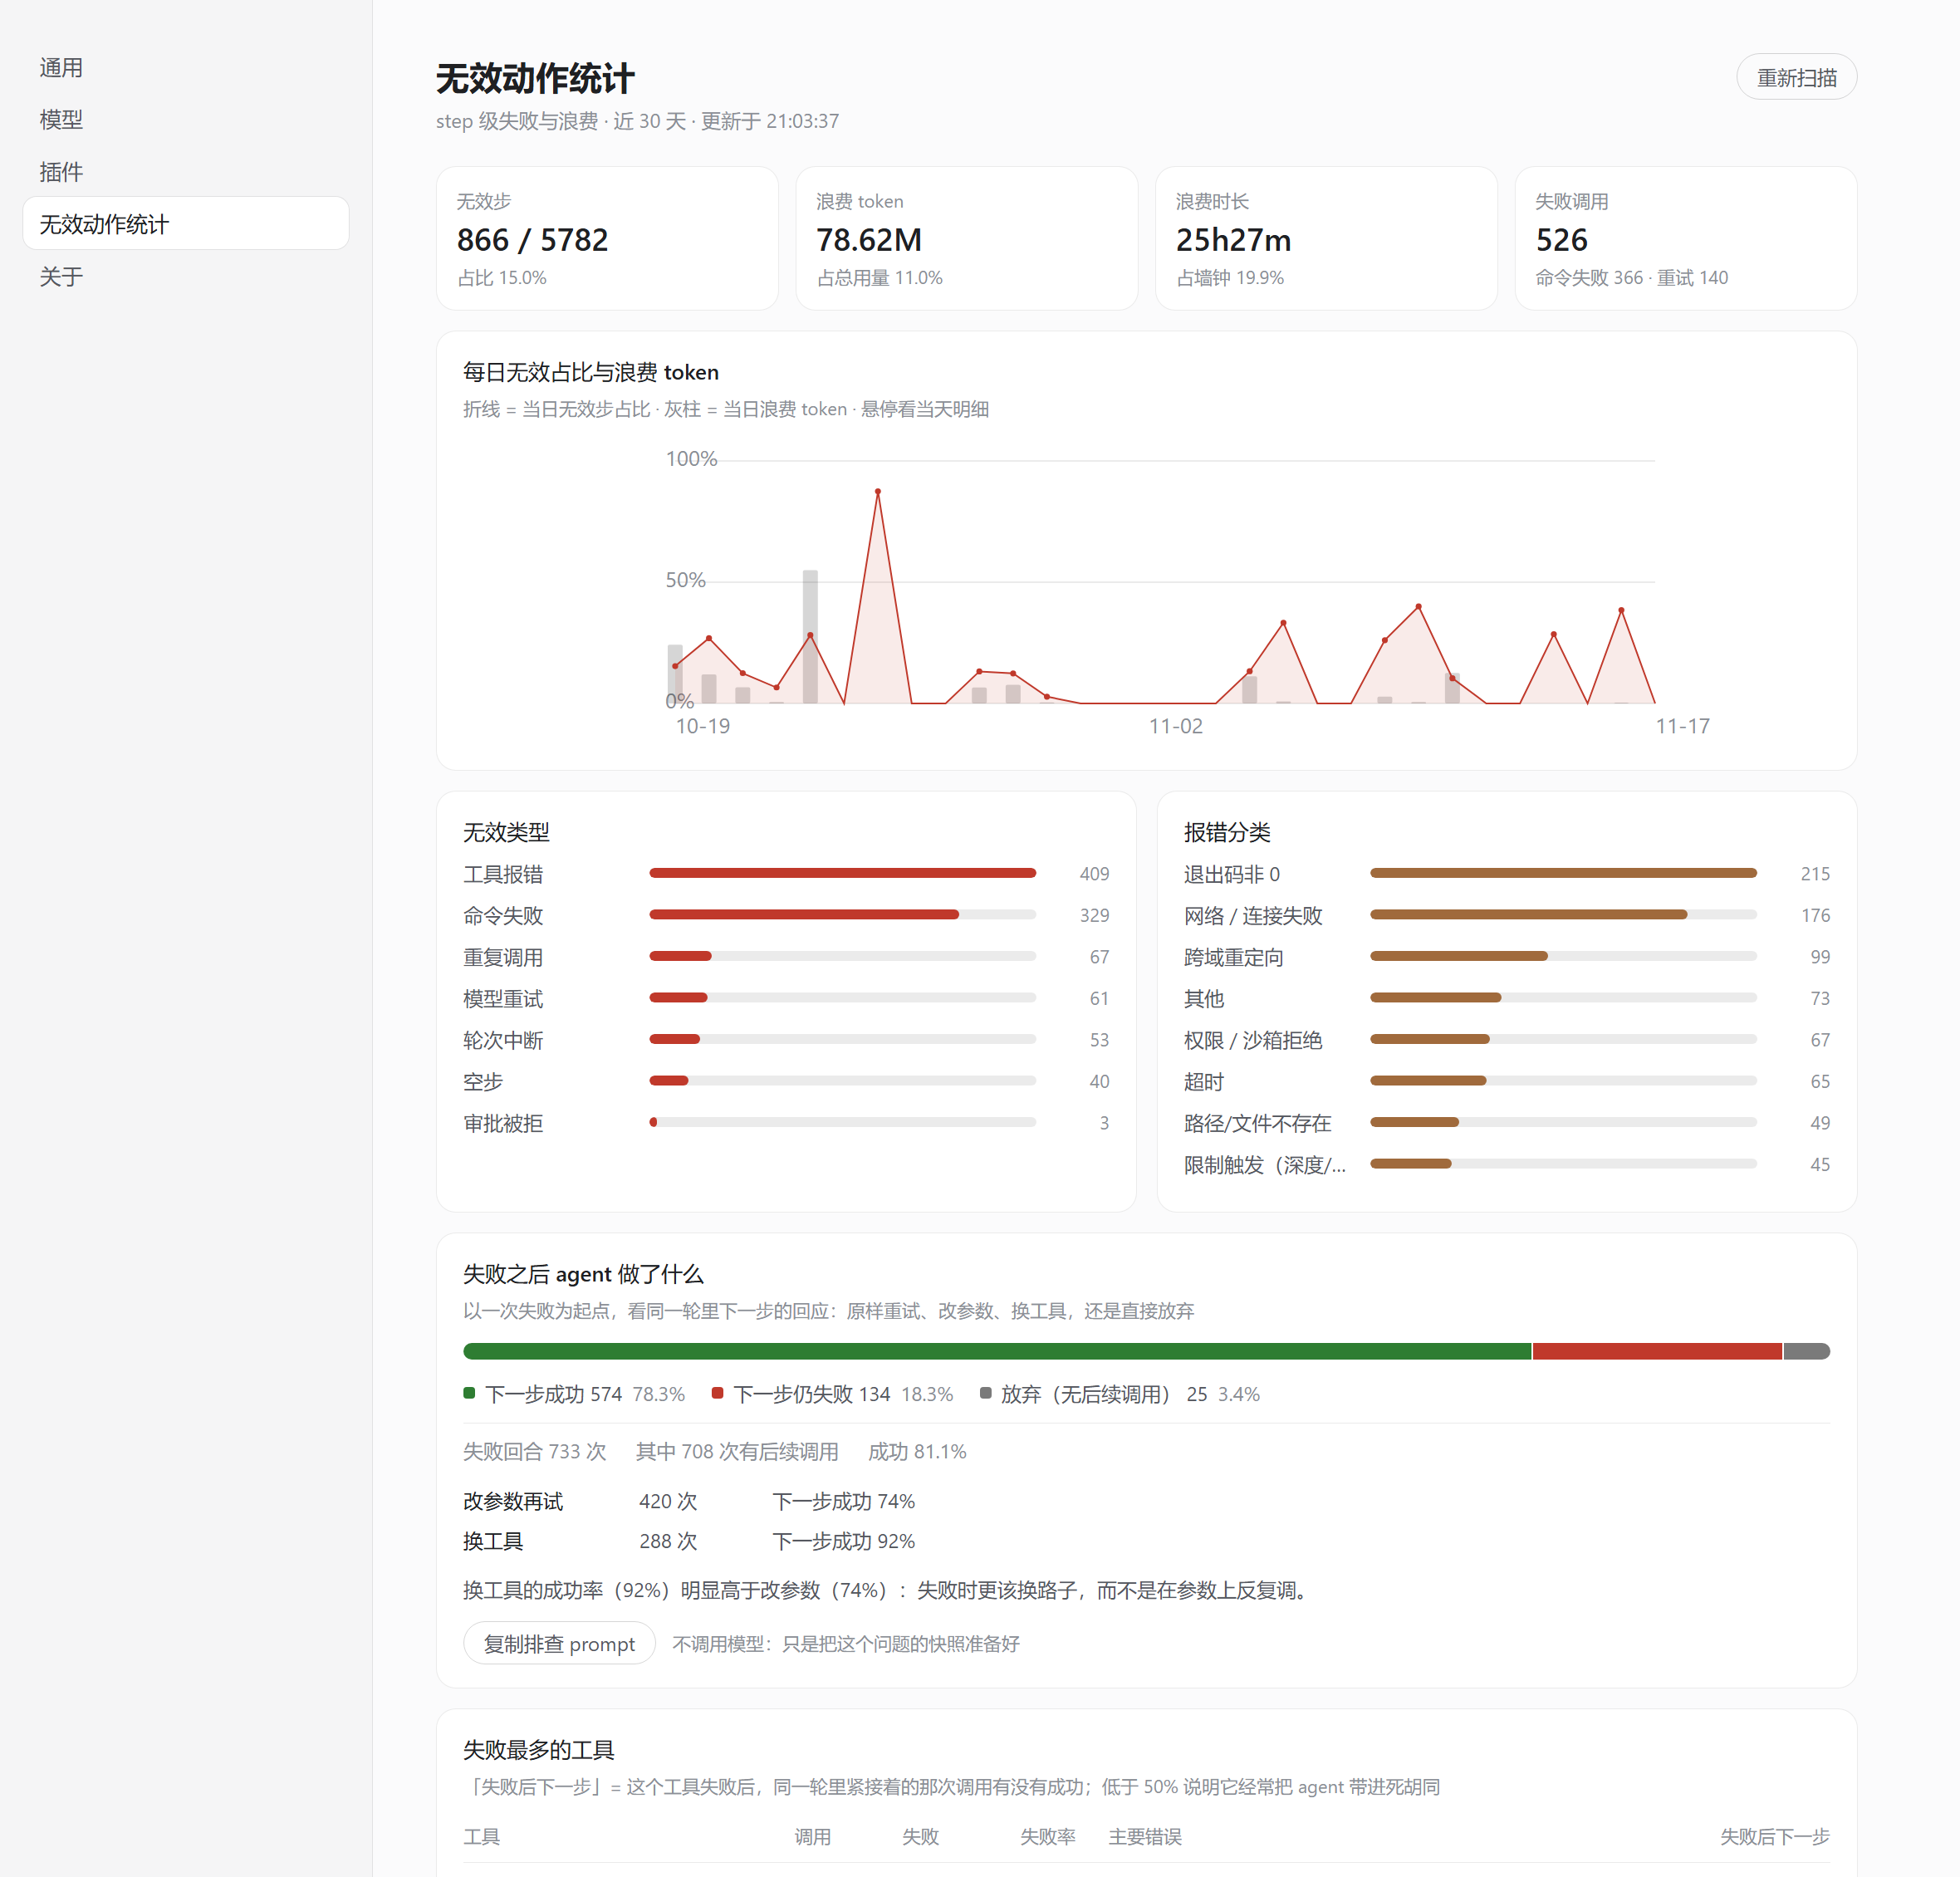
页内包含:KPI(无效步 / 浪费 token / 浪费时长 / 失败调用)、近 30 天「每日无效占比 + 浪费 token」 可悬停趋势、无效类型与报错分类排行、失败之后 agent 做了什么、失败最多的工具。 右上角「重新扫描」会重放日志补全历史。
「失败之后」那一节带一个 复制排查 prompt 按钮:它把当页的数字压成一段结构化的排查指令
(含 Top 工具、主要错误类、恢复率、以及「换工具比改参数有效」这类结论),
粘到对话框里就是一次自带数据上下文的复盘。插件本身不调模型,只是把问题快照写清楚。
2. 会话内胶囊:单个会话实时看
输入框下方出现胶囊:无效 2/9 · 12.3k tok。点开是当前会话的分项面板:
KPI、每轮无效占比折线、无效类型、报错分类、失败之后、最近无效步。
面板底部有「接着修」按钮,把失败现场一键交给对话框,三级降级依次尝试:
captureInsertion() + insertText()   →  插到光标处,保留用户已写的内容
setDraft(text)                      →  拿不到选区时覆盖整段草稿
navigator.clipboard.writeText()     →  两者都不可用时退回剪贴板
这样做的理由很实际:插件不该替用户按回车。它只把「哪些调用失败了、错在哪类、 下一步试过什么」写进草稿,是否发送、怎么问,仍然由人决定。
3. 命令:/steps
/steps        文本摘要(与 CLI 同口径)
/steps json   当前会话的完整视图 JSON
4. CLI:一次性扫描全部会话
# 摘要(默认读 $DSH_HOME/sessions)
node bin/dsh-event-fix.mjs scan

# 最近 7 天 + 生成离线面板
node bin/dsh-event-fix.mjs scan --since 7d --html .\reports\report.html

# 导出机器可读结果
node bin/dsh-event-fix.mjs scan --json .\reports\report.json --quiet
参数:--root <dir>、--since 7d|24h|2026-11-01、--session <id>、--limit <n>、--html、--json。
架构
session events            step 投影              per-step facts
step/start · tool/result  ──────────▶  analyzer  ──────────▶  kinds + usage + duration
llm/retry · turn/end                                  │
tool/call ──────────────┐                             ├──▶ 失败回合(failure episode)
                        └──▶ 同轮下一次调用 ──────────┘      └─▶ 动作 × 结果 → 恢复率
                                                      ├──▶ 会话视图 view
                                                      │      ├──▶ 会话内胶囊(conversation.composer.dock)
                                                      │      ├──▶ /steps 命令
                                                      │      └──▶ 跨会话聚合 → GET /dsh-event-fix/stats
                                                      │                          └──▶ 设置页
                                                      └──▶ step ledger(data/step-ledger.jsonl,可选)
                                                              └──▶ CLI 聚合 → 离线 HTML 面板
这条分支只依赖事件,不依赖 DSH 内部状态:同一份会话日志用 CLI 重放,得到的数字必须和面板一致 (测试里对此有断言)。
失败回合的判定是同一轮次、更晚的 step:同一 step 内的并行调用不算「对失败的反应」 (它们本来就同时发出,看不到彼此的结果),跨轮次也不算(用户又说话了,那不是 agent 的自救)。
安装
先确认 dsh 能跑
DSH 是自带 Node 运行时的绿色发行版,CLI 没有被装进全局,所以直接敲 dsh 会报
The term 'dsh' is not recognized。三条路,任选一条:
A. 一次性的完整调用(不改环境,立刻可用):
& "E:\program\DeepSeek\runtime\node-v24.19.0-win-x64\node.exe" `
  "E:\program\DeepSeek\app\node_modules\@deepseek-ai\dsh\lib\bin.js" `
  plugin --profile web add link:E:/programs/dsh-event-fix
注意:必须用发行版自带的 node.exe,并且 DSH_HOME 指向 <发行版>\.dsh,否则会读到空 profile。
B. 放一个 shim 到已在 PATH 的目录(推荐,之后 dsh 就一直能用):
Copy-Item E:\programs\dsh-event-fix\install\dsh.cmd "$env:USERPROFILE\.local\bin\dsh.cmd"
install/dsh.cmd 会设好 DSH_HOME、把便携 Node 加到 PATH 前面,并在启动 app 时清掉
代理变量(代理残留会让模型请求变成 Connection error),但保留代理供 pnpm 装包。
C. 跑 CLI 命令用绝对路径,不装插件,只出离线面板(见上文「CLI」)。
本地开发链接(推荐)
dsh plugin --profile web add link:E:/programs/dsh-event-fix
装完 dsh plugin --profile web list --depth 0 应能看到 dsh-event-fix@link:...。
然后确认 profile 的 package.json 包含依赖与 bundle:
{
  "dependencies": { "dsh-event-fix": "link:E:/programs/dsh-event-fix" },
  "dsh": { "profile": { "bundles": ["dsh-event-fix"] } }
}
重启 DSH web 进程;日志出现 [event-fix] active 即生效。之后发一轮请求,输入框下方会出现胶囊。
不想重启也能先验证:dsh web --help 会把插件树完整挂载一遍再打印帮助,日志里出现
[event-fix] active; projection=step-errors; ledger=... 就说明宿主侧加载成功(客户端胶囊仍需重启才出现)。
重启方式(DSH 那个控制台窗口里 Ctrl+C 也行):
# 1. 找出并关掉旧的 web 进程
Get-CimInstance Win32_Process -Filter "Name='node.exe'" |
  Where-Object { $_.CommandLine -like '*dsh*web*' } |
  ForEach-Object { Stop-Process -Id $_.ProcessId }
# 2. 重新启动
dsh web --no-open
改完源码怎么重启(重要)
宿主侧的改动永远需要重启,这是 HMR 的边界,不是插件的缺陷。 三条路径的缓存行为不一样:
| 改了什么 | 需要做什么 |
|---|---|
装一个新的 bundle(dsh plugin add) | 什么都不用做,HMR 会热加载 |
改已装插件的 client 半(src/client.js) | 刷新浏览器即可——它每次请求都从磁盘读 |
改已装插件的 host 半(src/analyzer.js、snapshot.js、index.js) | 必须重启 DSH |
原因:HMR 的 chokidar 默认忽略 **/node_modules,而 link: 安装的包在 node_modules 下、
真实源码在仓库目录,所以监听不到;同时宿主模块在进程启动时就已载入内存。
这种错配的表现很迷惑:页面是新的(标题、卡片都在),数据是旧的(新字段读不到)。 页面现在会自检——响应里缺一个当前版本必有的字段时,顶部显示「当前响应来自旧版宿主模块」, 而不是把版本问题说成「没有数据」。
一条命令完成重启(会先杀掉占用端口的旧进程):
E:\programs\dsh-event-fix\install\restart-dsh.cmd
它会清掉代理变量(残留会让模型请求变成 Connection error)、用便携 Node 启动、
并把输出追加到 .scratch/dsh-restart.out.log。日志最后一行是带 token 的访问地址,
每次重启 token 都会变,所以旧标签页会 401,要用新地址打开一次。
想从任意目录、且不占一个终端窗口,可以注册成计划任务(脱离调用者的进程树):
Register-ScheduledTask -TaskName 'wb-dsh-web' `
  -Action (New-ScheduledTaskAction -Execute 'E:\programs\dsh-event-fix\install\restart-dsh.cmd') `
  -Trigger (New-ScheduledTaskTrigger -Once -At (Get-Date).AddYears(1)) `
  -Settings (New-ScheduledTaskSettingsSet -ExecutionTimeLimit ([TimeSpan]::Zero)) -Force
Start-ScheduledTask -TaskName 'wb-dsh-web'
Start-Process 起 cmd.exe 可能被本机安全策略拦(“bypasses PowerShell command validation”),
计划任务不受此限制。
配置
包内 cordis.patch.yml 的可移植默认值:
- insert:
    - id: event-fix
      name: dsh-event-fix
      config:
        ledgerEnabled: true
        # ledgerPath: '<可写数据目录>/step-ledger.jsonl'
ledgerPath 默认写在包内 data/,升级会丢;需要长期保留就覆盖到用户目录。
ledgerEnabled: false 可完全关闭落盘,只保留内存中的投影与面板。
已知边界
- 只解释明确事件。「方向错了」「提示词写得不好」不在范围内;本插件没有这类判断能力。
- 计数单位是 step,不是动作次数。一个 step 里并行 5 个调用、4 个失败,
无效类型只记 1 步(工具报错KPI 记 4 次调用)。 你「感觉更多」时,通常是在数动作次数,而面板里那一栏数的是 step。 - 退出码非 0 ≠ 一定该失败。
git diff --quiet、Test-Path这类命令用退出码表达布尔结果, 也会被计成命令失败。要看真伪就看该条的报错文本:它优先显示 stderr 的诊断行,而不是[exit code: 1]。 - 重复调用是启发式。同名同参且中间没有成功写入才计入;读取同一文件两次本来就可能是合理行为。
- 失败回合看的是「下一次调用」。若 agent 在失败后改写了代码再验证,那一次验证会被当成「对失败的反应」, 哪怕它其实是对改动的验证;这类跨因果的猜测无法从事件层面区分。
- 恢复率是相关性,不是因果。换工具后 92% 成功,说明「换工具」是好信号,但不等于每一次都该换。
- 浪费 token 不是账单。含 cache read/write,且不区分单价;需要费用请看
dsh-billing-stats。 - 时长是墙钟。并行工具调用会让步时长重叠,因此各步时长之和不等于会话时长。
- 子会话单独统计。subagent 会话是独立 session 文件,不在父会话里合并。
- 轮次中断只归因一步。该轮最后一步背锅,不拆分「哪部分是被中断浪费的」。
- zstd 需要 Node ≥ 22.15 / 24。DSH 自带运行时满足;用系统 Node 跑 CLI 时注意版本。
- 当前实测 DSH
0.2.0-rc.2(web profile);事件字段变化时需要同步更新src/analyzer.js。
开发
npm test     # 51 个测试:taxonomy / analyzer / followup / report / snapshot / plugin / client / store
npm run check  # 19 个文件语法检查
npm run scan -- --limit 5 --html .\reports\preview.html
测试覆盖:错误分类、重复调用抑制、轮次中断回填、失败回合的动作分类与结果归属、 投影增量重放一致性、ledger 落盘、快照折面、宿主路由(含 405 与空目录降级)、 客户端两个席位与 pill 渲染、prompt 生成文本、zstd 多帧解码、HTML 报告自包含。
更多:
License
MIT © 2026 dsh-event-fix contributors