dsh-tc-ima
hughpython/dsh-tc-ima
Browse and search Tencent ima knowledge bases, read files in an in-panel dock, and add links, files and notes via the ima OpenAPI.
Установка
dsh plugin --profile web add github:hughpython/dsh-tc-imaREADME
dsh-tc-ima · ima 知识库
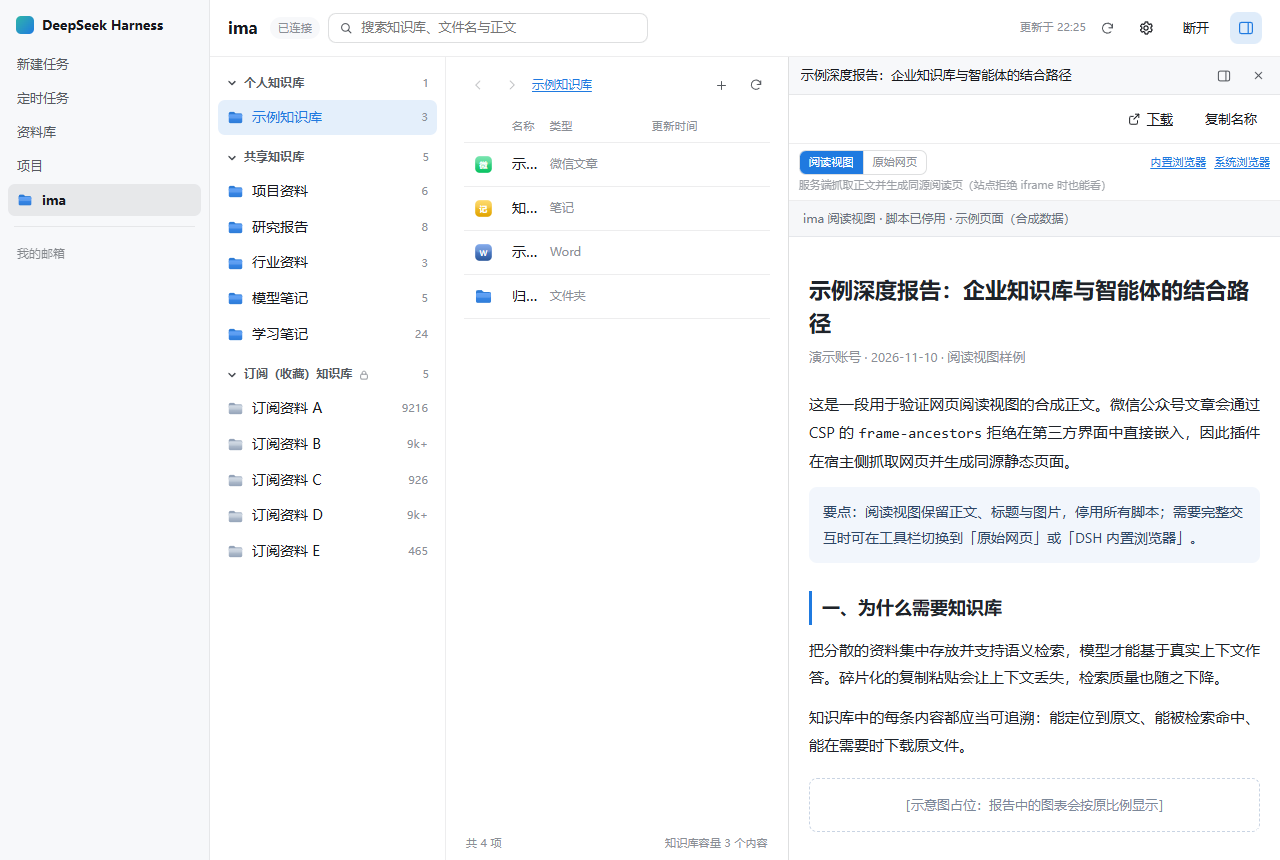
把腾讯 ima 知识库 做成 DeepSeek Harness 的原生面板:左侧栏入口、个人 / 共享 / 订阅(收藏)知识库浏览、搜索、在 ima 界面自带的右侧分栏里阅读文件(不跳回旧会话)、网页 / 微信文章的同源阅读视图、可调字体与配色的设置弹框,以及通过 ima 官方开放接口添加网页链接 / 本地文件 / 笔记。
在 ikevss/dsh-ima 的基础上重做(MIT),保留了它的 ima OpenAPI 客户端、笔记排版还原与一键授权思路,重写了宿主/客户端分层与界面。
同系列插件:dsh-tc-mail(把腾讯智能体邮箱做成 Harness 原生面板,含 mail_* Agent 工具)。
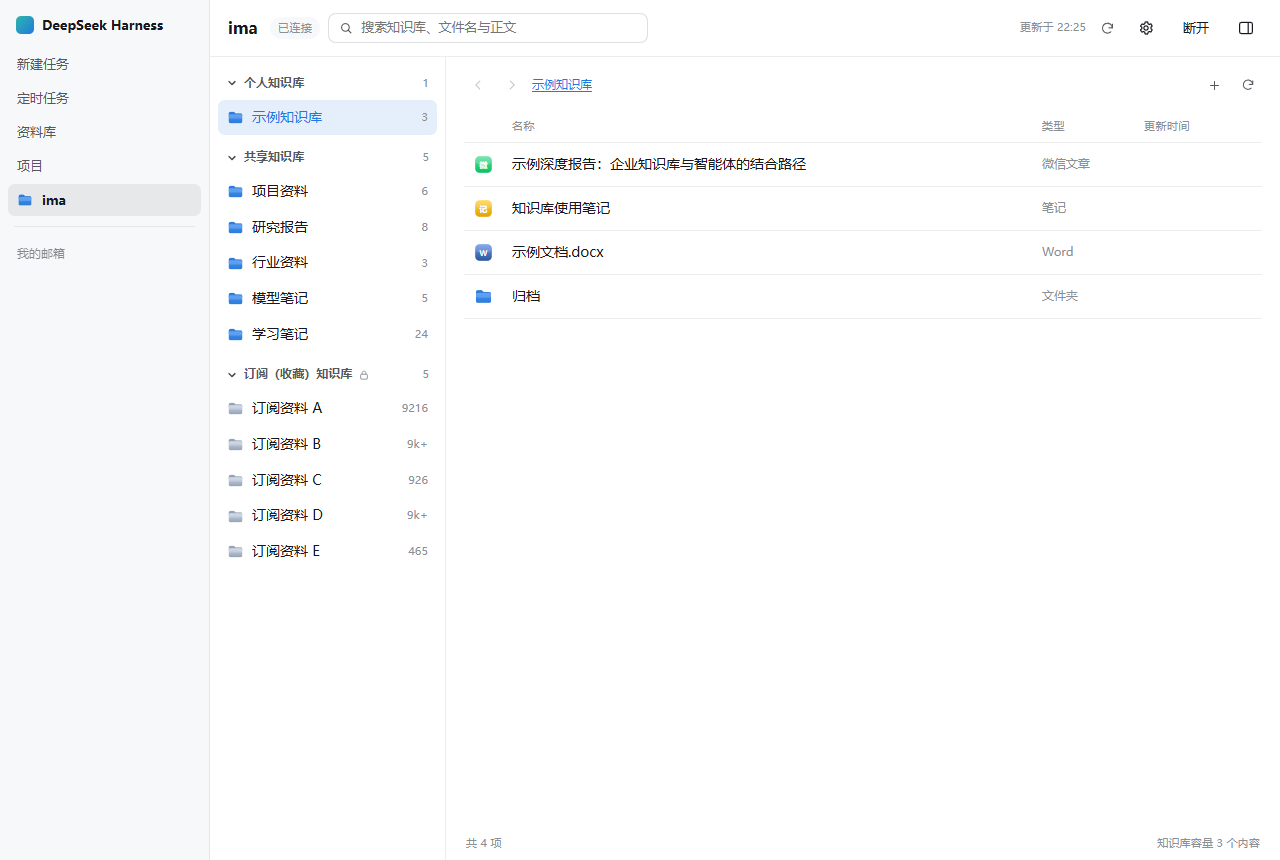
截图来自本地预览挂具(
dev/preview.html)。库名、文件名、正文与链接全部为合成示例数据,不含任何真实知识库内容、账号信息或真实文档统计。
写在前面:
这是我vibe-coding将腾讯生态接入dsh的第二个插件,主要给dsh安装一个有相当容量的知识库大脑(100GB),对你有帮助的话请不要吝啬你的⭐,也欢迎查看我的另一个插件
特性
- 左侧栏入口:挂在 Harness 官方
sidebar.panellist槽位,点击进入main主面板。 - 三组知识库:个人 / 共享 / 订阅(收藏),可折叠;订阅组带锁标记。默认自动选中第一个个人知识库。
- 搜索:顶部搜索框同时匹配知识库名、文件名与正文内容(320 ms 去抖,跨库检索),结果可直接跳转。
- 文件查看(留在 ima 界面内,不跳外部浏览器、不回旧会话):
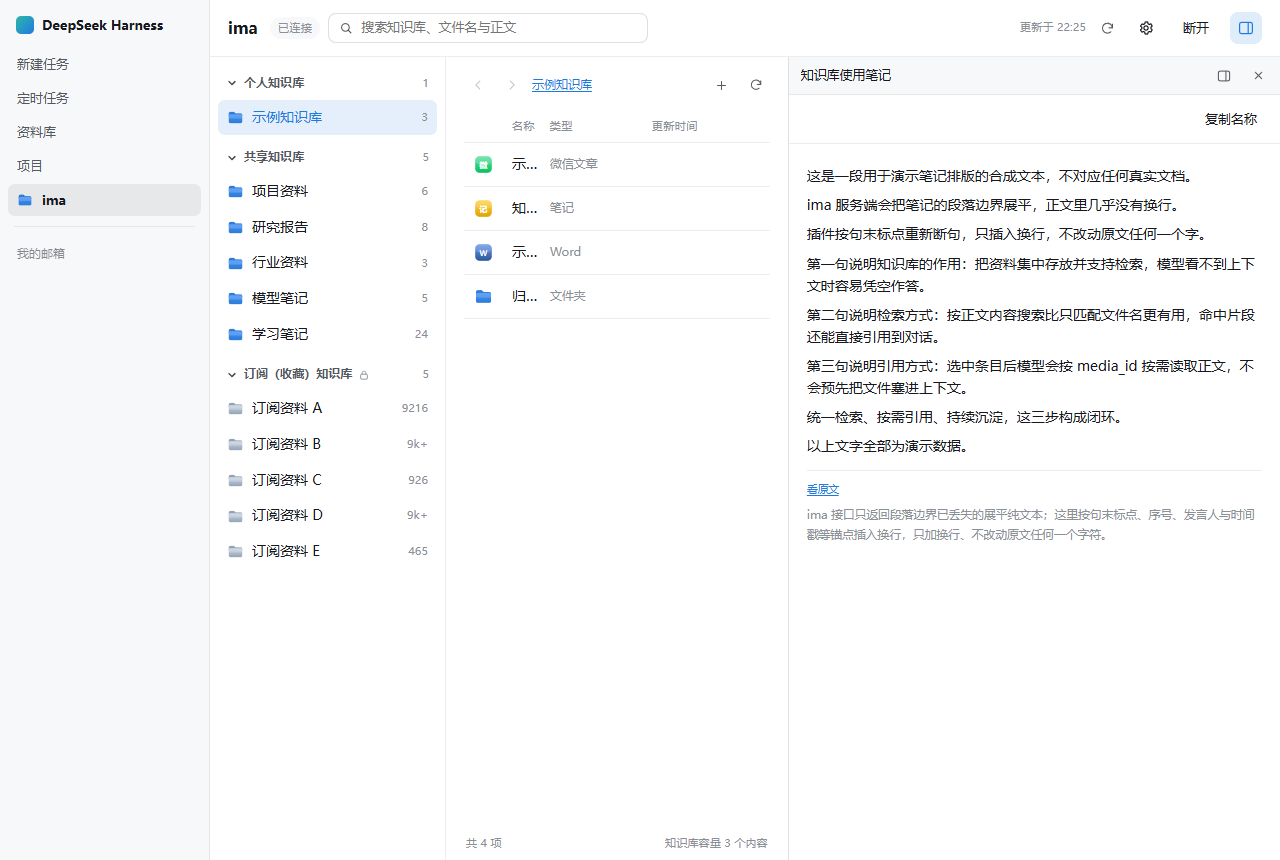
- 点击文件默认在 ima 面板内置的右侧分栏打开,分栏贴主区域右缘;右上角最后一个按钮用于展开 / 收起。
- 网页 / 微信文章 → 默认使用 宿主生成的同源阅读视图(抓取正文、去脚本、带严格 CSP),因此微信公众号文章的
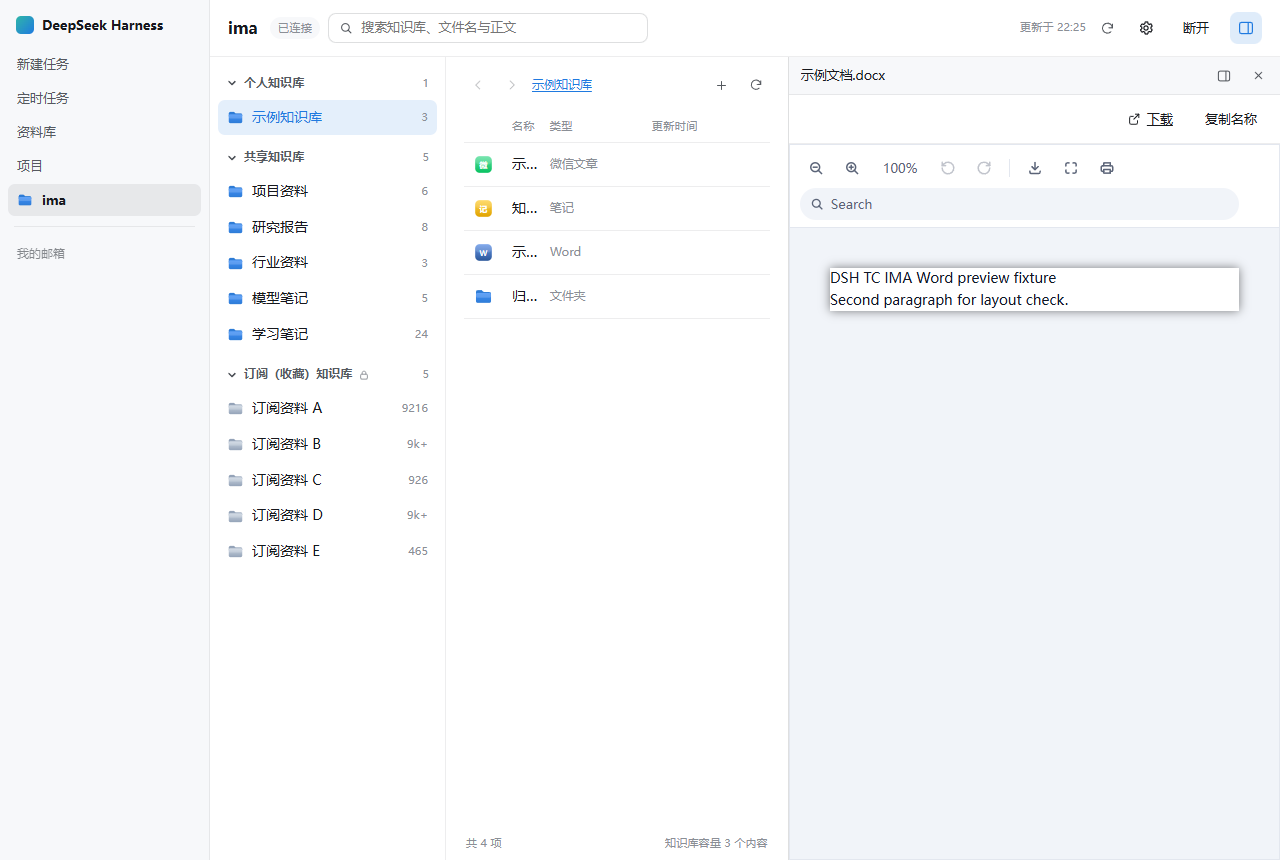
frame-ancestors不会再把分栏变成白屏;工具栏可切到「原始网页」「DSH 内置浏览器」「系统浏览器」。 - PDF / Word / Excel / PPT / 图片 / 音视频 / Markdown / XMind / 笔记 → 纯前端引擎
open-file-viewer,PDF 交给 Chromium 原生查看器。 - ima 笔记 / 自制文本 → 按句末标点、序号、发言人与时间戳等锚点重建段落,只插入换行、不改一个字,可随时切回「看原文」。
- 设置里可改回「DSH 会话右侧栏 tab」或「在 ima 主区域查看」。
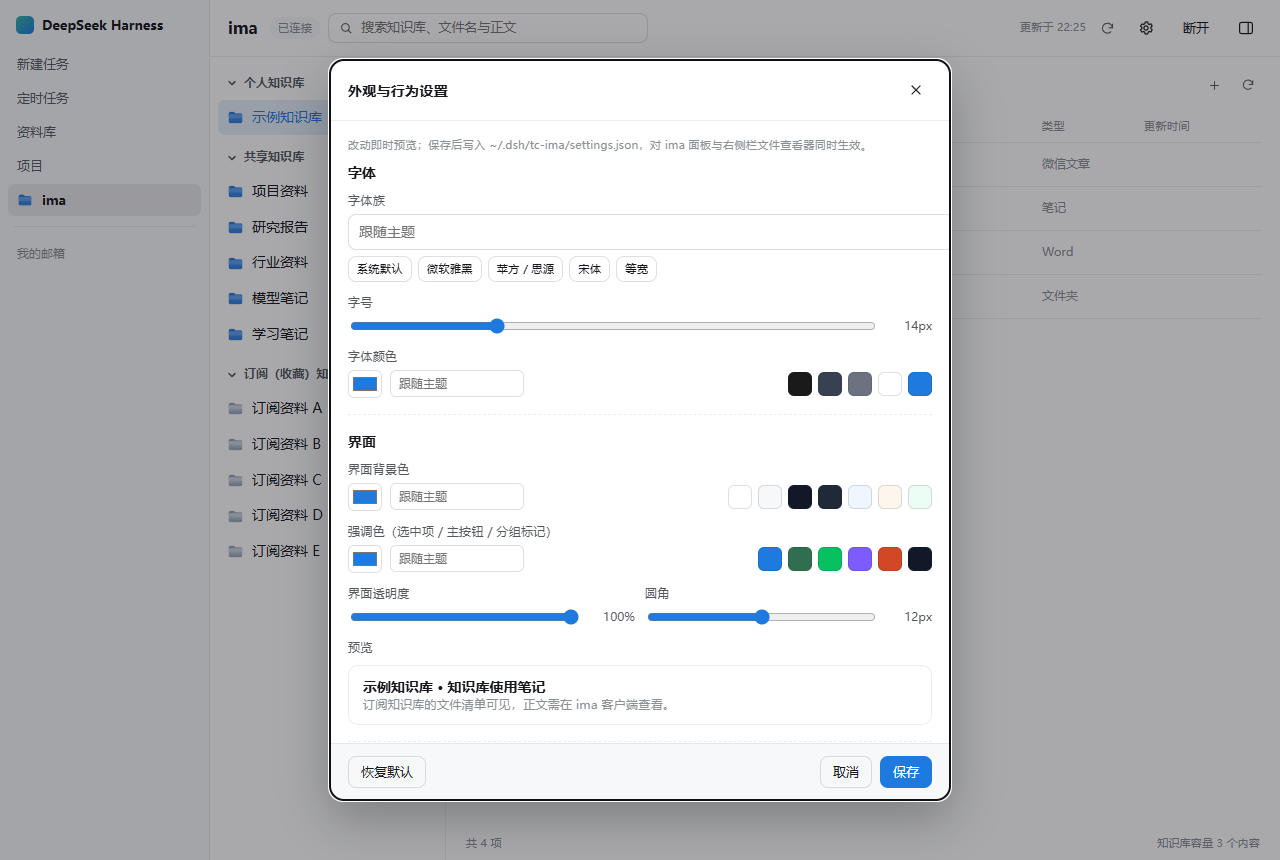
- 设置弹框:字体族、字号、字体颜色、界面背景色、强调色、界面透明度、圆角、文件打开位置、自动刷新、更新时间列;即时预览,保存到
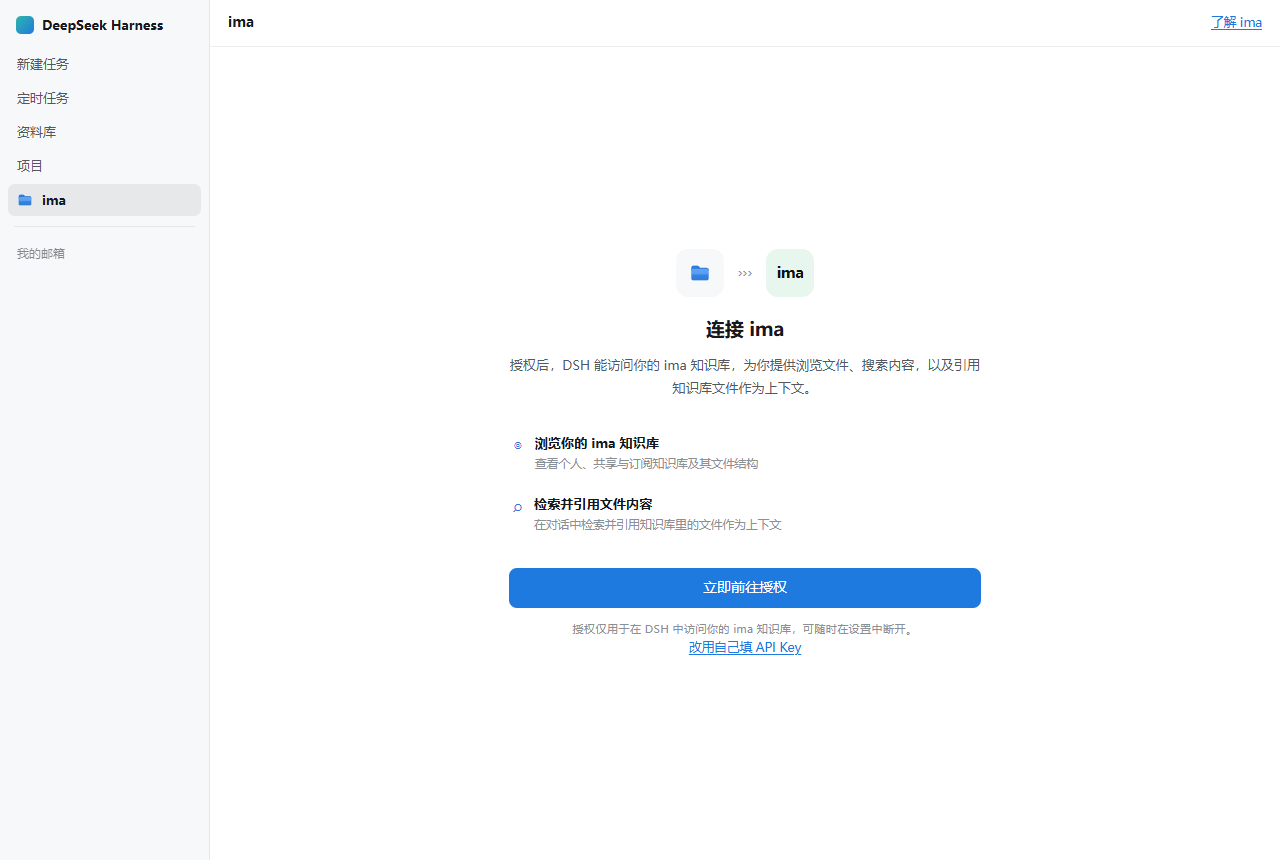
~/.dsh/tc-ima/settings.json,对 ima 面板与右侧栏查看器同时生效。 - 连接 ima:WorkBuddy 风格的「连接 ima」页 → 立即前往授权 → 在浏览器里用微信 / 手机号登录 → 自动取回密钥;支持本机已有凭证一键收编、手动粘贴 API Key。
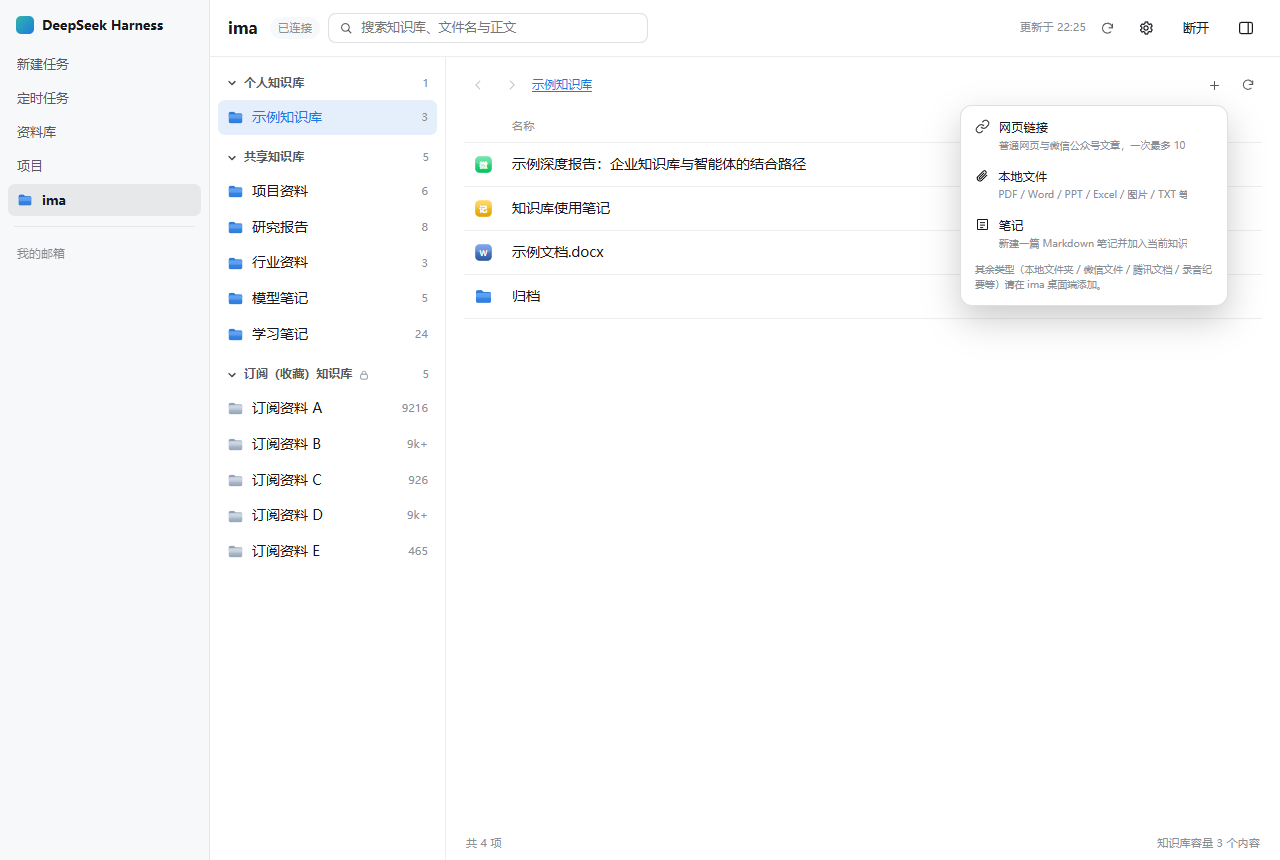
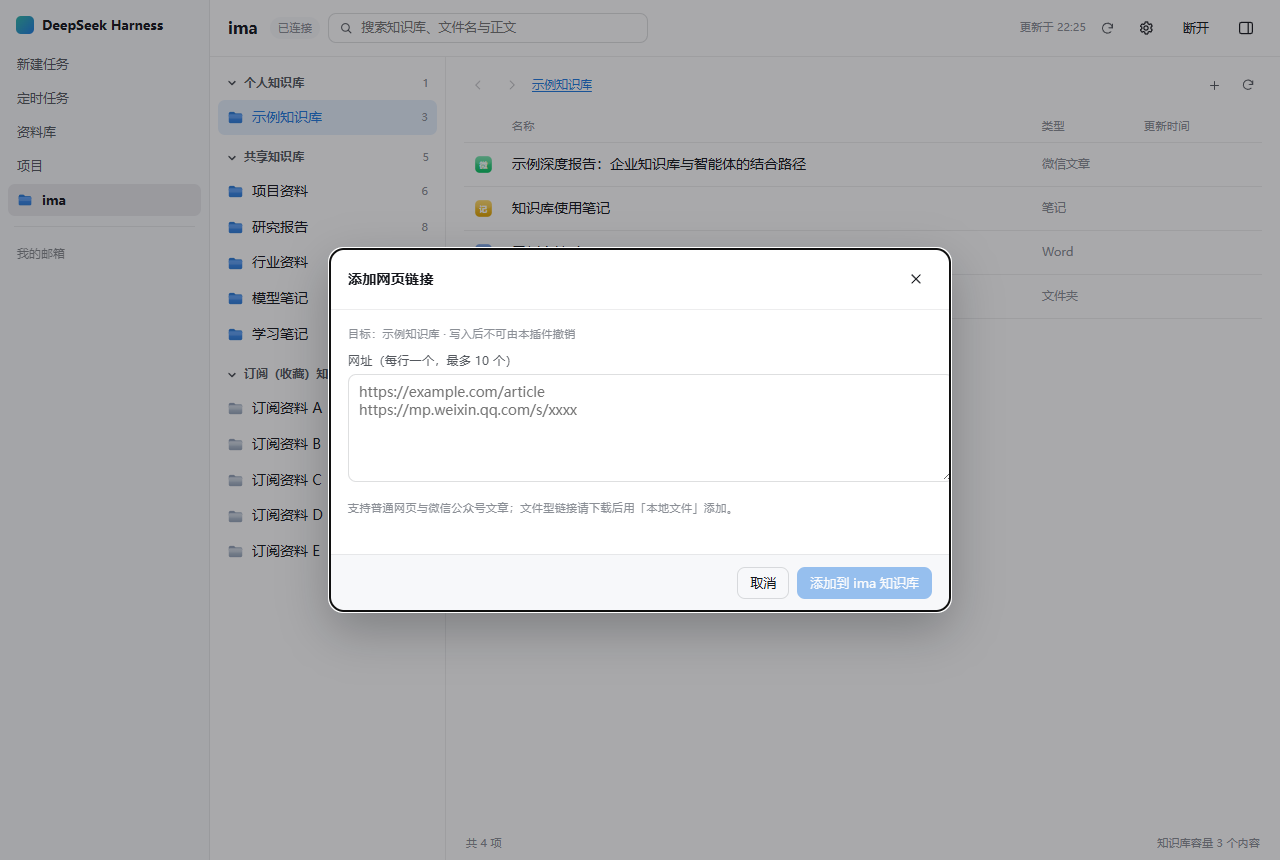
- 添加内容:面包屑右侧的「+」菜单,按 ima 官方 OpenAPI 提供网页链接、本地文件、笔记三种写入;其余类型(本地文件夹、微信文件、腾讯文档、录音纪要等)开放接口没有对应端点,菜单中不显示,请在 ima 桌面端操作。所有写入都要在弹框里点一次明确的确认按钮,且只允许写入
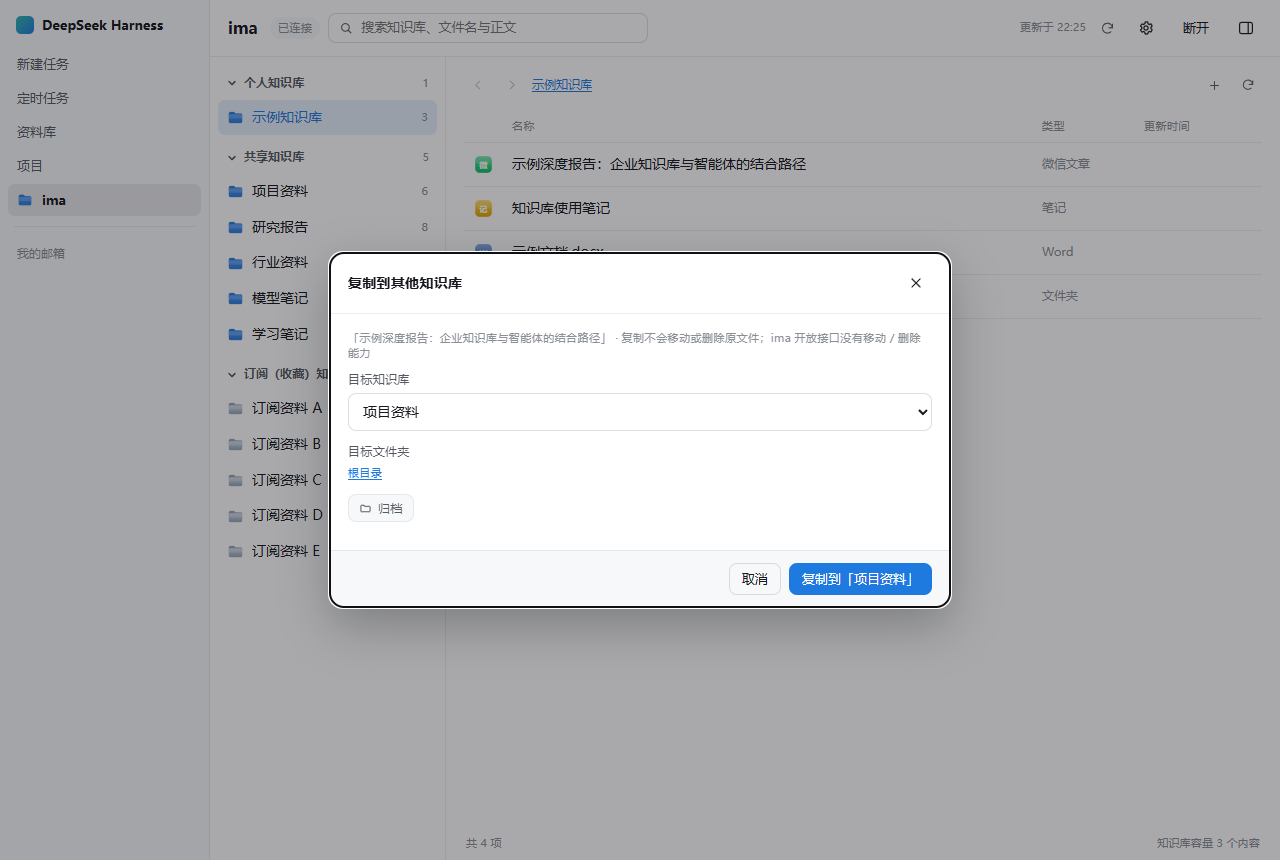
get_addable_knowledge_base_list返回的库。 - 复制到其他知识库 / 文件夹:文件行悬停出现「复制」按钮 → 选目标库(仅可写库)→ 逐层进入目标文件夹 → 确认。链接走
import_urls、笔记走note_info、文件带已有media_id重新挂载;重名会先check_repeated_names并支持「保留两者」改名。这是复制,原条目不动(ima 没有移动 / 删除接口)。 - 输入框里用
@引用知识库:在对话输入框敲@,ima 知识库与本地文件同屏出现。裸@列出全部知识库(个人 / 共享 / 订阅分组),往下可逐层进入库与文件夹;@关键词走跨库正文全文检索,命中的文件按库分组。选中的条目在输入框里变成一枚 chip,点一下就在右侧栏打开原文;发送时模型看到的是<ima_file media_id="…" …/>这样的标记,会先调ima_read_file再谈内容。详见「在对话框里引用文件」。 - Agent 工具:
ima_health/ima_list_knowledge_bases/ima_search_knowledge_bases/ima_list_kb_files/ima_read_file/ima_search_files,并注入一段提示词让模型知道知识库存在。其中ima_read_file对 Word 直接返回解析好的正文,笔记 / txt / markdown 直接给文本,PDF 等其余类型给签名直链和一条现成的curl命令。
安装
# 本地开发目录(当前推荐;改代码后重新 build 并重启 DSH)
dsh plugin --profile desktop add link:/absolute/path/to/dsh-tc-ima

# 仓库公开后可用(不要写 github: 简写,npm 会解析成 SSH 地址)
# dsh plugin --profile desktop add git+https://github.com/HughPython/dsh-tc-ima.git
仓库暂未公开,当前请用
link:本地安装;package.json里的 GitHub 地址是发布后的目标位置。
装完重启 DSH,左侧栏出现「ima」。
| 项目 | 要求 |
|---|---|
| DeepSeek Harness | 0.2.2-rc.1(开发与实测版本);接口在 0.2.x 仍可能变动 |
| Node.js | ≥ 20(宿主半用全局 fetch) |
| 浏览器 | Chrome 或 Edge,仅「一键授权」需要 |
| ima 账号 | 能登录 ima.qq.com |
连接 / 授权机制(与 WorkBuddy 的区别)
WorkBuddy 的「连接 ima」使用第一方连接器 OAuth:票据由 WorkBuddy 托管,第三方插件无法复用。ima 对第三方只开放 https://ima.qq.com/agent-interface 的 Client ID + API Key(OpenAPI)。
本插件复刻了可见的登录步骤,但取密钥的方式是:
- 点「立即前往授权」,宿主拉起一个带调试端口的独立 Chrome/Edge 窗口,打开
ima.qq.com/agent-interface。调试端口由浏览器动态分配(--remote-debugging-port=0),仅绑定127.0.0.1,并通过DevToolsActivePort中的 browser ws 路径校验实例归属;它与 DSH Web 服务的固定端口(如 17817)互不影响; - 你在该窗口用微信扫码或手机号登录 ima(与 WorkBuddy 截图一致);
- 插件在该页面同源调用
app_query取回 Client ID / API Key,写入~/.dsh/storages/dsh-tc-ima/credentials.json,然后关闭窗口。
凭证也可能来自 ~/.config/ima/{client_id,api_key}(ima 官方技能位置)或社区插件 dsh-ima 的旧凭证,界面会提示「一键连接」。全过程不向任何第三方发送凭证。
为什么改成「ima 内置右侧分栏」
DSH 的右侧栏是按 Session 挂载的:sidebar-right 只在会话是主面板(layout.panelInfo.activePanelId === null)时才有 on-screen session surface;而 ima 是全局 main 面板,会替换会话视图。早期版本为了借用 DSH 原生右侧栏,先 ctx.layout.selectPanel(null) 回到会话再开 tab,结果就是「点一下侧边栏 → 跳到旧对话」。
这个约束来自宿主架构,第三方插件无法绕过(改 app.asar 会触发完整性校验、直接启动失败)。因此当前版本自绘分栏:它是 ima 面板 DOM 的一部分,天然贴主区域右缘、不切换主面板、不依赖会话。代价是它不是 DSH 的 tab 系统,也没有 DSH 原生文档预览的渲染能力(见下节)。
若确实需要 DSH 原生 tab(例如要和其它 tab 并排),可在分栏工具栏点「在 DSH 会话右侧栏 tab 打开」,或在设置里把「点击文件后」改成对应选项——这是显式操作,会离开 ima 界面。
网页 / 微信文章为什么改走「阅读视图」
ima 的网页类条目由 get_media_info 返回一个原站 URL。微信公众号文章会发送:
Content-Security-Policy: frame-ancestors 'self' ... mp.weixin.qq.com ...
其中不包含 Harness 的 127.0.0.1,Chromium 因此拒绝把页面装进第三方 iframe,表现就是分栏里一大块白屏。DSH 自带浏览器用的是 <webview>,但主进程在 will-attach-webview 里要求「租约」(about:blank#<lease> + 专属 partition),第三方插件不能自己创建 guest。
所以现在的默认链路是:
- 宿主只接受
get_media_info返回的链接,拒绝内网 / 环回 / 私网地址,手动处理重定向并逐跳复核;限制 15 s 超时、8 MB 体积与text/html类型。 - 抽取微信
#js_content(按<div>深度配平)或<article>/<main>/<body>;把data-src变成src、相对地址绝对化、去掉脚本与事件处理器、揭开visibility:hidden。 - 由
/api/dsh-tc-ima/article?id=...返回同源静态 HTML,带default-src 'none'的 CSP;客户端用sandbox="allow-popups"的 iframe 加载。
微信公众号文章这类带 frame-ancestors 的页面实测可正常显示:原页约 4 MB → 阅读视图约 140 KB、数十张配图、0 段脚本。若站点既不能内嵌、又抓不到正文,分栏会显示明确错误页而不是空白;要完整交互页可点「原始网页 / DSH 内置浏览器 / 系统浏览器」。
添加内容:支持范围与安全门
ima 桌面端的「添加」菜单有 9 项,但官方 agent-interface(skill 1.1.10)只对第三方开放三类写入:
| 菜单项 | 支持 | 使用的官方接口 |
|---|---|---|
| 网页链接(普通网页 / 微信文章) | ✅ | import_urls(一次 1–10 个,服务端自动识别类型) |
| 本地文件 | ✅ | check_repeated_names → create_media → COS PUT Object → add_knowledge |
| 笔记 | ✅ | import_doc(Markdown) → add_knowledge(media_type=11) |
| 本地文件夹 / 微信文件 / 个人知识库 / 腾讯文档 / 录音纪要 / 新建文件夹 | ❌ | 开放接口没有对应写入端点,菜单中不显示,只能在 ima 桌面端操作 |
安全约束:
- 绝不静默写入:浏览、刷新、搜索、打开菜单都只读;每个写入都要在弹框里点带文字的确认按钮。
- 目标库校验:写入前用
get_addable_knowledge_base_list核对kb_id,订阅库和没有权限的库直接 403 拒绝。 - 文件预检:扩展名 → media_type、大小上限(10 / 30 / 50 / 200 MB)、文件头签名与文本二进制检查;重名不覆盖,只允许「保留两者」自动加时间戳。
- COS 成功门:只有
PUT返回 2xx 才调用add_knowledge;上传失败不会留下知识库条目。 - 写入不做自动测试:单元测试与端到端验证都用 mock / 只读接口,不会向你的 ima 账号写入任何演示内容。
本地文件通过
<input type="file">以原始二进制流发给插件宿主(上限 200 MB),不转码、不压缩;COS 签名用官方参考实现的 HMAC-SHA1 算法在宿主侧完成,凭证不会进入渲染进程。
复制到其他知识库 / 文件夹
OpenAPI 没有移动、重命名、删除、新建文件夹的端点,但 add_knowledge 可以把一个已存在的条目再次挂到目标库,于是插件提供「复制」:
| 条目类型 | 复制方式 | 说明 |
|---|---|---|
| 网页 / 微信文章 | import_urls(原 URL 从 get_media_info 取) | 官方推荐用 import_urls 代替 add_knowledge 的 2/6 类型 |
| 笔记 | add_knowledge + note_info.content_id(docid 来自 get_media_info) | media_type=11 |
| 文件(PDF / Office / MD / 图片 / TXT / Xmind / 音频 / HTML / EPUB) | add_knowledge + 已有 media_id | 不带 file_info(没有 cos_key);若服务端拒绝,界面会原样显示 ima 的错误信息 |
- 目标库同样限定在
get_addable_knowledge_base_list内,订阅库不能作为目标。 - 重名先走
check_repeated_names,命中时提供「保留两者」自动改名;链接和笔记不做重名预检。 - 这是复制,原条目保持不变;想真正「移动」,只能先在原库删除(ima 客户端操作)。
两种 Word 渲染为什么不一样
| ima 插件分栏(当前) | DSH 自带文档预览 | |
|---|---|---|
| 链路 | docx-preview / mammoth 在浏览器里把 docx 转成 HTML | Host 端 office-to-pdf(LibreOffice)转成 PDF,再由 PDF.js 渲染 |
| 保真度 | 中等;复杂排版、图表、字体可能失真 | 高;接近 Word 打印效果,带 PDF 文本层、缩放与页码 |
| 输入 | 远端 COS 签名直链,可直接用 | 只接受 dsh-resource://file/session/<sessionId>/<path> 这类本地工作区文件地址 |
| 作用域 | 任意面板内部 | 会话级右侧栏,只在会话为主面板时可用 |
也就是说:想要图 5 那种高保真效果,需要先把 ima 文件下载到工作区、再交给 ctx.sidebarRight.openResource(),而这一步必然回到会话视图,与「留在 ima 界面」互斥。当前取舍是优先保证不跳走、开箱即用;如果 Word 保真度对你更重要,这是一个可做的后续方向(代价是引入本地缓存目录与会话切换)。
在对话框里引用文件
在对话输入框敲 @,Harness 会弹出补全菜单。ima 的知识库条目和本地文件出现在同一个菜单里,选中后变成输入框里的一枚 chip,点一下就在右侧栏打开原文。
文件查看工具栏只提供「下载」与「复制名称」。要把知识库条目带进对话,请使用这里的输入框
@引用——早期版本的「引用到对话」按钮靠向宿主输入框注入文本实现,实测不稳定,已移除。
| 你敲的 | 菜单里出现什么 |
|---|---|
@ | 全部知识库,按「个人 / 共享 / 订阅」分组;每个库右侧有下钻箭头 |
@ima/<库ID>/ | 该库根目录的文件与文件夹,可继续往下钻 |
@ima/<库ID>/<目录ID>/ | 该目录下的条目 |
@关键词 | 跨库正文全文检索,命中的文件按知识库分组 |
为什么模型能读懂
Harness 发送时会把 chip 交还给它所属的 source,由该 source 自己决定模型看到什么文本。我们把它定义为:
<ima_file media_id="…" kb_id="…" kb_name="…" title="…" type="…" />
<ima_kb id="…" name="…" />
所以模型看到的是一个明确的 ima 条目,而不是一段会被当成工作区文件去 cat 的路径。插件注入的系统提示词里也写明了:见到 <ima_file …/> 就先用 ima_read_file 按 media_id 读正文,再谈内容。
模型怎么拿到正文
ima_read_file 按文件类型给不同的结果:
| 类型 | 结果 |
|---|---|
| 笔记 | 直接调 get_doc_content 取正文,不下载文件 |
| txt / markdown | 取签名直链后按 utf-8 解码,原样返回,不转 md |
| Word(.docx) | 插件侧下载并从 zip 里抽出正文,模型直接拿到文字 |
| PDF / PPT / Excel 等 | OpenAPI 没有「解析后的正文」,返回签名直链和一条可直接执行的 curl 命令,由模型下载后自行解析 |
Word 这一档是自己实现的(src/host/docx.js):docx 本质是 zip,正文在 word/document.xml 里,
手工解析 zip 目录 + Node 内置 zlib 解压,再按 OOXML 标签顺序取文本——不引第三方依赖。
段落、表格、制表符、XML 实体都保留,w:instrText / w:delText 这类非正文节点不会混进来。
下载走 HTTP Range:docx 里图片常常占绝大部分体积,而正文只有几 KB。
只取尾部中央目录和 word/document.xml,可把下载量从数 MB 降到几 KB,耗时也相应缩短。
直链不支持 Range 时自动退回全量下载。
为什么不给 PDF 也做解析:PDF 需要引入 pdfjs 这类依赖,收益与体积不成比例,
而签名直链 + 一条现成的curl命令已经足够模型自己处理。ima-skill走的也是同一条路子
(get_media_info→ 用 url + headers 请求原文),这里只是把最常见的 Word 往前推了一步。
实现要点
- 走的是宿主自带的
inputTriggers扩展点(ctx.inputTriggers.registerSource),没有另起一套 UI,也没有新增任何宿主端点——ima 的数据全部复用已有的/api/dsh-tc-ima/*。 - 下钻路径写在草稿里(
@ima/<库ID>/<目录ID>/),和宿主本地文件下钻(@some/dir/)同一个套路:路径即状态,换会话、刷新、重开菜单都不会错位。 - chip 的
ref是一段 JSON,装下重建所需的全部字段,因此刷新后仍能还原成模型文本、仍能点开原文。 - 跨库全文检索需要逐库并发查询,所以输入去抖 400 ms,并缓存 45 秒内相同的查询;菜单会先出本地文件,ima 分组随后补齐。
- 引用链路的哲学和宿主
@本地文件一致:只负责指认,内容交给模型按需取。宿主自己的提示词就是这么写的("use the read tool when its contents are needed"),没有哪条链路会把文件预先转成 md 塞进上下文。
自测
DSH 启动后会在日志里打印带一次性 token 的本地地址(http://127.0.0.1:<端口>/?token=...);npm run verify 与 scripts/verify-ref.mjs 会自动读取该 token 打开页面。
# 打开 DSH 后跑:列候选 → 下钻 → 选 chip → 点开 chip → 跨库搜索
node scripts/verify-ref.mjs

# 只读检查某个文件的正文解析(Word 走插件侧解析,PDF 返回直链指令)
curl "http://127.0.0.1:17817/api/dsh-tc-ima/file?id=<media_id>&text=1"
插件 API 会复用宿主
connection.requestRejection()的 Host/Origin 校验与浏览器会话认证,因此不带会话 cookie 的裸curl会返回 401 / 403。要做命令行只读检查,请用npm run verify(Playwright 打开带 token 的 DSH 页面后发起同源请求)。两条自测都只读,不发送消息、不写入 ima。
已知边界
| 边界 | 说明 |
|---|---|
| 订阅(收藏)知识库正文 | 实测 search_knowledge_base 能列库、get_knowledge_list 能列文件,但 get_media_info 返回 220030「没有权限通过skill获取订阅知识库的文件」。所以能看清单、不能读正文;界面会显示明确提示与 ima 客户端入口。上游插件把整组隐藏了,本插件保留。 |
| 更新时间 | ima OpenAPI 目前不返回 update_time,列保留但为空,不造假数据。 |
| ima 笔记段落 | 部分长笔记从 ima 服务端取回时段落边界已被展平:数千至上万字、几乎无换行、结构锚点稀少。插件按句末标点断句,把整篇拆成可读段落,只能做到「可读」,无法无损还原原始段落;可用「看原文」对照。 |
| 网页阅读视图 | 阅读视图是静态快照:保留正文与图片,但停用脚本,需要登录、无限滚动或复杂交互的站点请切到「原始网页 / DSH 内置浏览器」。部分站点可能反爬而抓取失败,此时显示错误页而非空白。 |
| 添加 / 复制 | 添加只支持网页链接、本地文件、笔记三类;不支持文件夹批量上传、微信文件、腾讯文档、录音纪要、新建文件夹。复制到其他库依赖 add_knowledge 接受已存在的 media_id(无 file_info)——若 ima 某天收紧校验,会返回明确错误而不会静默失败;移动 / 删除 / 覆盖仍然不提供。详见上节。 |
| Office 预览 | 纯前端渲染,保真度取决于 open-file-viewer;复杂排版、宏、图表可能与 Word/Excel 有差异。见上节与 DSH 自带预览的对比。 |
| 非 Word 的二进制正文 | ima OpenAPI 只提供签名直链,没有「解析后的正文」接口(服务端有全文索引,searchAllKnowledge 能搜正文,但没开放按 media_id 取全文的端点)。所以 PDF / PPT / Excel 的正文由模型自己下载后解析——插件给的是直链 + 一条可直接执行的 curl 命令。Word 因为是 zip 结构,插件侧能自己抽正文,详见「模型怎么拿到正文」。 |
数据与权限
网络与数据流向
- OpenAPI:只访问
https://ima.qq.com;Client ID/API Key仅以请求头发给该域名。 - 文件直链:
get_media_info返回的腾讯云 COS 签名直链用于读取 / 上传;上传用的临时凭证由 ima 下发,只用于该次请求。 - 网页类条目:打开时由宿主 GET 原站抓取正文(不带任何 ima / DSH 凭证)并生成同源阅读页。阅读页 CSP 允许
img-src https: http:,所以浏览器会向文章中的图片 CDN 发起带原 URL 查询参数的 GET,向这些站点暴露本机 IP 与 User-Agent;「原始网页」模式则会直接内嵌外站页面。 - 模型上下文:
@引用与ima_*Agent 工具会把知识库清单、命中片段或文件正文带入当前会话,随对话一起发给所配置的模型服务。ima_read_file对 PDF / PPT / Excel 等返回签名直链和一条含签名头的curl命令,该链接与签名头会进入模型上下文。使用第三方模型服务时请按其隐私 policy 评估。 - 除上述以外,没有遥测、统计、崩溃上报、安装期脚本或向作者 / 第三方服务器发送数据的逻辑;无
install/postinstall,prepublishOnly只在发布者本机执行构建。
本地数据
- 写入:
~/.dsh/storages/dsh-tc-ima/(credentials.json凭证、授权用浏览器 profile)、~/.dsh/tc-ima/settings.json(外观设置)。凭证文件按0600落盘(Windows 依赖 NTFS ACL),内容为明文。 - 读取:上述位置,以及
~/.config/ima/{client_id,api_key}与~/.dsh/storages/dsh-ima/credentials.json。只要本机存在这些凭证,插件启动后即可直接访问对应 ima 账号,无需再次授权。 - 一键授权会启动一个带调试端口的独立 Chrome / Edge 实例(独立 profile,不读取日常浏览器的登录态),仅用于从 ima 页面取回密钥。调试端口动态分配、只绑
127.0.0.1,并校验该端口确实属于本次启动的实例,不会误连其它 DevTools。 - 本地 API
/api/dsh-tc-ima/*只监听 loopback,并在路由层复用宿主的connection.requestRejection():校验 Host / Origin、拒绝跨站请求,并要求 DSH 浏览器会话认证;未认证返回 401、来源不受信任返回 403。宿主版本较旧、没有该服务时会降级为本地信任校验(loopback 来源 + loopback Host + 同源 Origin + 非跨站)。
依赖与供应链
- 运行时没有需要额外安装的 npm 依赖:
lib/index.js与lib/client.js是 esbuild 构建产物,发布包不含node_modules/。 - 但
lib/client.js内嵌了第三方预览引擎及其传递依赖(@open-file-viewer/core、mammoth、docx-preview、xlsx、mermaid、hls.js、heic2any 等,约 9 MB 压缩代码)。react由宿主冻结模块表提供,pdfjs-dist被构建脚本替换为空桩。第三方代码随包分发、压缩后不便人工审计;升级依赖前建议核对来源与许可证。 package-lock.json锁定构建期依赖;npm audit --omit=dev当前报告 0 条公告。
开发
cd dsh-tc-ima
npm install
npm run build      # lib/index.js + lib/client.js
npm test           # 79 个 Node 单测(API / 路由 / 鉴权准入 / 设置 / 笔记分段 / 阅读视图 / 写入与复制流程 / @ 引用格式 / docx 正文解析)
npm run preview    # 本地预览挂具(合成数据)
npm run shot                     # Edge headless 截图 + 分栏 / 分段 / Word / 阅读视图 / 添加菜单的 DOM 断言
npm run shot -- --view=web       # 同源阅读视图(dev/fixtures/article.html)
npm run shot -- --view=word      # 用 dev/fixtures/sample.docx 验证 Word 预览
npm run shot -- --view=add,add-urls  # 添加菜单与弹框
npm run shot -- --view=add-note      # 笔记弹框 + 输入焦点回归(每字符失焦)
npm run shot -- --view=copy          # 复制到其他知识库弹框
npm run verify                   # 对运行中的 DSH 做端到端只读检查(需 dev/dsh-start.log 里的 token)
node scripts/verify-ref.mjs      # 对运行中的 DSH 检查输入框 @ 引用(列候选 / 下钻 / chip / 打开原文 / 搜索)
构建脚本只对未使用的
pdfjs-dist打空桩(PDF 交给 Chromium 原生查看器)。mammoth/docx-preview/xlsx是open-file-viewer的正式依赖,必须真正打进客户端包,否则 Word 会静默退化成原始 OpenXML 文本抽取。
src/host/ 是 Node 半(路由、工具、设置、ima 客户端),src/client/ 是浏览器半(JSX + CSS + 预览引擎),两者通过同源 /api/dsh-tc-ima/* 通信。客户端产物用 window.__ModuleLoader__.load({ id, factory }) 惰性 CJS 包装,react 走宿主冻结模块表(构建时 external)。
致谢
- ikevss/dsh-ima — ima OpenAPI 客户端、笔记段落还原、CDP 授权思路(MIT)
- open-file-viewer — 纯前端文档预览引擎(MIT)
- deepseek-ai/deepseek-harness — 插件与右侧栏扩展点
License
MIT
Похожие плагины
archify (deepseek-harness)
tt-a1i/archify
WeKnora (dsh-weknora)
tencent/weknora
next-ai-draw-io (dsh-plugin)
dayuanjiang/next-ai-draw-io
weknora
tencent/weknora