dsh-pf-stream
weilv-d/dsh-pf-stream
Streams and inspects local video for agents: adaptive motion/settle canvas sampling, deterministic probe, timestamp and uniform frame extraction, and RoI zoom on 42px-grid-aligned canvases. Requires ffmpeg and ffprobe on PATH (or configured absolute paths); clips without subtitles also need a ~190 MB local whisper model or a cloud transcription API key.
Установка
dsh plugin --profile web add github:weilv-d/dsh-pf-streamREADME

视频理解
让智能体看懂视频:画面、动作与台词,按时间对齐。


中文 · English
30 秒上手
| 步骤 | 做什么 |
|---|---|
| 1 | 安装 ffmpeg(命令见下),确认 ffmpeg -version 有输出 |
| 2 | 左侧栏「插件」→ 点「视频理解」→ 打开右上角开关 |
| 3 | 选一条转写路线:下载本地模型(约 190 MB);或复用已准备好的官方语音输入模型;或填云端密钥。本地/云端完成后点「测试转写」;官方语音路线点「检查官方语音就绪」 |
| 4 | 在对话里给视频路径,直接提问 |
不配置转写也能看画面。只有「没有字幕、又需要台词」的视频,才需要第 3 步。
能做什么
- 看画面:画面运动时记录过程,停稳时定格细节;指定时间点可以高清复核。
- 听声音:有字幕就用字幕;没有字幕时,配置转写引擎后生成台词,并按时间挂到对应画面。
- 按需配置:默认不转写也能处理画面;配置后可以处理带音轨的视频。
安装
1. 安装 ffmpeg
插件用 ffmpeg 解码视频。先确认它能运行:
ffmpeg -version
ffprobe -version
两条都要有输出。没有的话:
| 系统 | 安装命令 |
|---|---|
| Windows | winget install Gyan.FFmpeg |
| macOS | brew install ffmpeg |
| Ubuntu / Debian | sudo apt install ffmpeg |
装完新开一个终端再验证。不想放进 PATH,可以在插件配置里写
ffmpegPath与ffprobePath的绝对路径。
2. 在 DSH 里安装插件
- 打开 DSH,点左侧栏的「插件」。
- 在列表里找「视频理解」(包名
dsh-pf-stream)。 - 点进详情页,把右上角的开关打开。
- 第一次开启后,详情页会出现引导卡片。
列表里没有时,用插件页的安装入口从 npm 安装 dsh-pf-stream,装完再回到这一步。
也可以把安装交给智能体:
安装 DSH 插件 dsh-pf-stream:
1. 用插件管理器从 npm 安装最新版本,结果为 applied 才算成功;
2. 检查 ffmpeg 与 ffprobe;缺失时安装(Windows: winget install Gyan.FFmpeg / macOS: brew install ffmpeg / Linux: sudo apt install ffmpeg);
3. 对一个本地视频调用 probe;返回时长与分辨率即成功;
4. 汇报插件版本、ffmpeg 位置与检查结果。
第一次配置转写
转写引擎决定「没有字幕的视频能不能拿到台词」。不配置也能看画面,只是不会生成转写文本。
进入配置页:左侧栏「插件」→ 点「视频理解」→ 详情页描述下方的面板。以后要改设置,走同一条路。
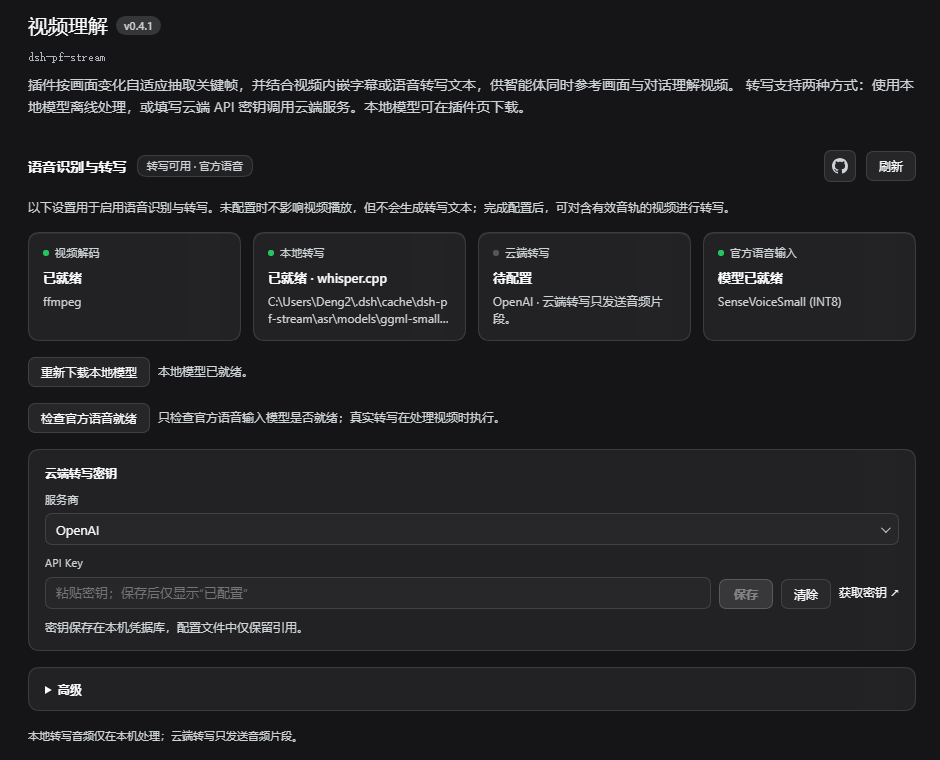
面板顶部最多四张状态卡:视频解码(ffmpeg)、本地转写、云端转写,以及(装了官方语音输入插件时)官方语音输入。按需要选一条路线:
| 路线 | 适合 | 操作 |
|---|---|---|
| 本地转写(推荐) | 免费、离线、不填密钥 | 点「下载本地模型」,约 190 MB;下载完点「测试转写」 |
| 官方语音输入 | 已装官方语音输入插件并准备好模型 | 不再下载 whisper 模型;状态卡显示「模型已就绪」后点「检查官方语音就绪」 |
| 云端转写 | 已有 API Key,或机器性能较弱 | 选 OpenAI / Groq / 自定义兼容端点,填 Key,保存后点「测试转写」 |
| 暂不配置 | 视频都有字幕 | 直接使用;无字幕的语音视频不会生成转写文本 |
本地模型
- 点「下载本地模型」。进度条显示已下载大小,可随时取消。
- 下载中断后再次点击会续传,不用从头开始。
- 完成后状态卡显示「已就绪 · whisper.cpp」。
- 点「测试转写」。返回「本地引擎可用」即配置成功。
一键安装当前支持 Windows x64。其他系统请先安装 whisper.cpp,在配置文件 audio.asr.local.binPath 填写可执行文件路径,或改用云端转写;已装官方语音输入插件时也可直接复用它。
官方语音输入模型
如果已安装并启用 @deepseek-ai/dsh-experimental-voice-input-bundle,并在它的插件页准备好 SenseVoice 模型,dsh-pf-stream 会直接复用该模型:
- 打开「高级」,把引擎设为
auto、local或host。 - 状态卡显示「官方语音输入 · 模型已就绪」即表示可用。
- 点「检查官方语音就绪」;该按钮只检查 provider 状态,真实转写在处理视频时执行。
- 不需要再下载 whisper 模型。
auto 仍先看云端;云端配置完整时不会改用官方模型。旧版 audio.asr.provider 非 none 且 engine=auto 时仍走 legacy;要复用官方模型,请把 engine 设为 host 或清空旧 provider。zh-CN、en-US 等地区语言会归一化到 provider 的基础语言;空白按自动识别处理。模型未准备时只提示,不自动下载。官方 provider 只返回块级文本,台词时间精度为块级(本插件按不超过 15 秒切块)。
云端密钥
- 在「云端转写密钥」里选服务商。
- 粘贴 API Key,点「保存」。保存后只显示「已配置」,不再回显密钥。
- 点「测试转写」验证密钥与网络。
自动策略:云端密钥、端点、模型都齐时用云端(更快,按量计费);否则若官方语音输入模型就绪,复用它;再否则用本地引擎。面板标题旁会显示当前实际使用的引擎,如「转写可用 · 云端」「转写可用 · 官方语音」。可以在「高级」里改成仅本地、仅云端、仅官方语音或不转写;另有一项「旧版 provider 直连」,只用于兼容 0.2.x 配置。
开始使用
在对话里直接给视频路径并提问:
- 「这个视频里发生了什么?」
- 「第 12.9 秒的文字写的是什么?」
- 「每 5 秒抽一帧,看画面怎么变化。」
- 「把这段访谈里说的话按时间整理出来。」
返回示例(节选):
[Packet #42 | Anchor: #105 | #101(P, 12.1s, Left-Top) → #105(F, 13.4s, Center)]
Audio @Packet #42: [12.1s-12.9s] "这件事我们准备了三年" | [13.0s-13.4s] "今天终于可以说了"
文本块是结构化元数据:每个画布包给出时间、形态、锚点与单元位置;音频部分给出状态、来源与逐句时间。图像块是每个画布包一张画布。
常用问法对应四种取帧方式:
| 想要 | 说法 |
|---|---|
| 先看整体 | 「看看这个视频」——流式采样,运动记过程、停稳给细节 |
| 只看某一秒 | 「第 12.9 秒写了什么」——定点高清帧 |
| 均匀看一遍 | 「每 5 秒抽一帧」——等间隔抽帧 |
| 看局部 | 「放大右下角」——按区域裁剪后再看 |
特点
双尺度流式感知
采样过程不再采用固定帧率,而由画面变化事件驱动:运动阶段以低分辨率过程单元(P)记录状态转移,停稳后以高分辨率定格单元(F)保留细节;两类单元在同一画布包内交付,使单次观测同时包含时序过程与稳态结果,模型无需为恢复某一细节而回看整段视频。
采样密度随画面活动度自适应调整:快速变化时降低采样率以抑制冗余帧,缓慢变化时延长等待直至检测到停稳;长静止区间以心跳信号维持时间基准,不重复传输图像。
画布打包与计费
每帧按 42 px 超像素网格切分为单元,按需选取 P 或 F 单元并拼装为画布。单次调用可携带多个画布包;每个包仅包含相对上一包新增的单元,历史包以内容哈希引用折叠,使长会话中的上下文规模保持有界。计费按画布网格单元数计算(r × (c + 1) + 2)。
确定性检视
流式采样之外另设四条确定性路径:probe 仅解析容器元数据;timestamps 按毫秒级时间戳抽取精确帧;uniform 以固定间隔均匀采样;roi_hint 对指定归一化区域裁剪放大。上述路径不依赖运动检测,输出可复现,适用于文字、数字与小目标的核对。
台词的级联来源
转写文本按三级级联获取:先取字幕(优先同名外挂 .srt / .vtt,其次内嵌软字幕);无字幕时做声学 VAD(静音检测与语音占比估计,全静音视频直接跳过);最后调用语音识别,可选本地 whisper.cpp、官方语音输入插件的 SenseVoice 模型,或 OpenAI / Groq / 自定义兼容端点。识别结果按 PTS 对齐并挂载至相应画布包,跨块边界以 ±300 ms 容差缝合。
默认策略为「视觉先行、转写后台补齐」:首次调用超过软截止(graceMs,默认 60 s)时先行返回视觉结果,转写任务在后台继续;同一视频的后续调用直接命中磁盘缓存。
长视频的冷区
超出当前窗口的历史画布包折叠为引用(锚点哈希、时间与台词文本),不再重复传输图像;需要复核时按时间戳重新取帧。
遇到问题
| 现象 | 先看这里 |
|---|---|
| 提示找不到 ffmpeg | 排障:ffmpeg |
| 有声音,但没有台词 | 排障:没有台词 |
| 下载模型失败或很慢 | 排障:下载失败 |
| 转写很慢、超时 | 排障:转写慢 |
| 设置页显示「只读」 | 排障:配置只读 |
文档
| 文档 | 内容 |
|---|---|
| 使用指南 | 用法、参数、返回内容、计费、全部配置项 |
| 排障 | 按现象查原因 |
| 开发者指南 | 架构、宿主契约、测试与发布 |
| Usage Guide | 英文使用指南 |
本地开发
pnpm build
pnpm test
pnpm verify:host
pnpm check:package
Host 半提供工具 dsh-pf-stream(probe / pf_stream / timestamps / uniform)、音频边车、本地引擎安装器与设置接口;Client 半是 client.js,在插件详情页注册配置面板与引导卡片。运行时依赖只有 pngjs 与 zod。
配置通过 ctx.configEditor.edit() 写入,保留用户未触碰的字段;密钥通过 ctx.credentials 存取,配置文件只保留引用。
许可证
Apache-2.0。
Похожие плагины
dsh-web-ui (dsh-tool-describe-image)
zhu1090093659/dsh-web-ui
modlens
liustack/modlens
ipollowork
devin-axis/ipollowork
dsh-vision-router
ysr666/dsh-vision-router