dsh-knit
polinnizhong/dsh-knit
DSH Knit는 대화와 관련된 작업공간의 Markdown, 코드, 이미지, 동영상을 순위화해 표시합니다. 기본 BM25/IDF 어휘 검색은 최근 대화와 문서의 제목·요약·본문을 로컬 비교하며 모델이나 네트워크를 쓰지 않아 데이터가 기기 밖으로 나가지 않습니다. 최근 파일 목록이 아니라 전체 작업공간을 스캔하므로 재시작·새 세션 후에도 유지됩니다. 관련도 3단계, 일치/참조 근거, 인라인 미리보기를 제공하고 Context Pack을 knit_docs로 에이전트에 노출합니다. 읽을 때 귀속을 고정하는 읽기 증거, 검색 전에 적용하고 되돌릴 수 있는 고정/제외, 줄 번호가 있는 참조·import·test 증거, 재시작 후 재사용되는 증분 인덱스도 지원합니다. v0.23 하이브리드 검색은 선택 기능이며 기본 꺼짐; 사용자가 Ollama 또는 OpenAI 호환 임베딩을 설정해야 켜집니다. 전송 항목은 query와 후보의 제목/요약뿐입니다(Markdown 첫 부분 최대 60자, 코드는 상대 디렉터리, 미디어는 파일명). 전체 본문과 절대 경로는 전송하지 않으며 loopback이면 기기 안에 남습니다. v0.24는 미커밋 변경을 읽기 전용 git status(고정 argv, shell 없음, 환경 allowlist)로 연관시키지만 기본 꺼짐입니다. 실제 공급자 테스트 전에는 검색 개선을 주장하지 않습니다.
설치
dsh plugin --profile web add github:polinnizhong/dsh-knitREADME
Knit
面向 AI Coding Agent 的任务感知工作区上下文检索与生命周期追踪。
Task-aware workspace context retrieval and lifecycle tracking for AI coding agents.
Knit 接的是当前任务和整个工作区之间那一层:从工作区里找出最相关的文档、源码与媒体, 组织成 主要 / 辅助 / 相关 三层上下文(Context Pack),交给面板、也交给 agent; 再持续追踪这些上下文有没有被读、被读之后有没有变。
找到 → 组织 → 追踪,默认的词法模式三步都在本机用字符串运算完成 —— 不调模型、不联网、零延迟、内容不出本机。 可选的混合模式默认关闭:只有你自己配好 provider 并且手动切到混合检索,才会有出网请求; 那时发出去的是你这句查询原话 + 每篇候选文件的标题与摘要(完整正文、绝对路径都不发)—— ⚠️ 这里有两个容易想当然的地方,见下面的「混合模式到底发出去了什么」。
                      当前任务
                         │
                    工作区检索
            ┌────────────┼────────────┐
            ▼            ▼            ▼
        主要上下文    辅助上下文    相关上下文
            └────────────┼────────────┘
                         ▼
                    Context Pack ──►  `knit_docs` 工具(给 agent)
                         ▼
                     Agent 读取
                         ▼
                读取证据 · Context Epoch
                         ▼
                    工作区发生变化
                         ▼
                 重新读取 · 生命周期
它不是「更聪明的最近文件列表」,也不是「代码浏览器」。 最近文件记的是「你点开过什么、哪个更新」;Knit 回答的是 当前这个任务,项目里哪些东西最值得先看 —— 以及看过之后,事情变成了什么样。
真机截图(不是原型):同一个工作区,这张停在 「代码」档 —— v0.19 起,源码和 Markdown 一样是一等公民。
每行下面的副行写着它是怎么被命中的(直接命中 classification · changelog / 路径命中 agents · classification),
以及命中段 —— 这次查询在这份文件里最像的是哪一段(命中段 24–38)。
点一行就地展开预览,并且直接停在那一段上:这里是 knit/src/host/passage.js,行号栏 + 语法高亮,
命中的那几行带一条灰底横带;预览头里只有路径和四个动作(复制 / 全屏 / 本地打开 / 关闭)。
头部只放路径、一个计数与两个开关;列表按「相关」还是「最新」排,由左边那一对页签决定 —— 按「相关」时排的就是你正在聊什么。
v0.14 起列表永远单列:最左边独立一列是序号(与标题第一行垂直居中),右边第一行=
Primary 点 + 标题 + 相对时间(时间靠右),摘要再往下;路径只出现在预览头里(目录收敛成一个 …/ 占位,完整相对路径在悬停提示里),列表行不再重复。
序号是跨三档连续的一条(先看 / 辅助 / 背景);「其他相关文档」不在包里、不编号,那一格用一个 · 占位 ——
空着会被读成「漏了一个号」(2026-10-01)。
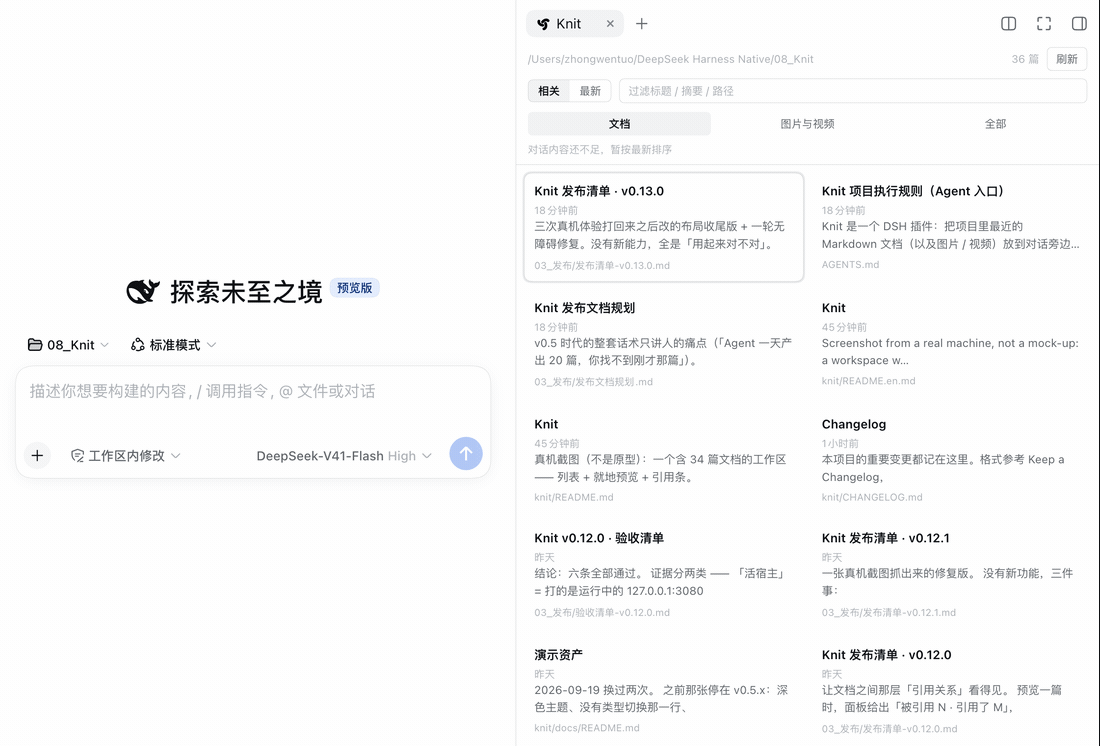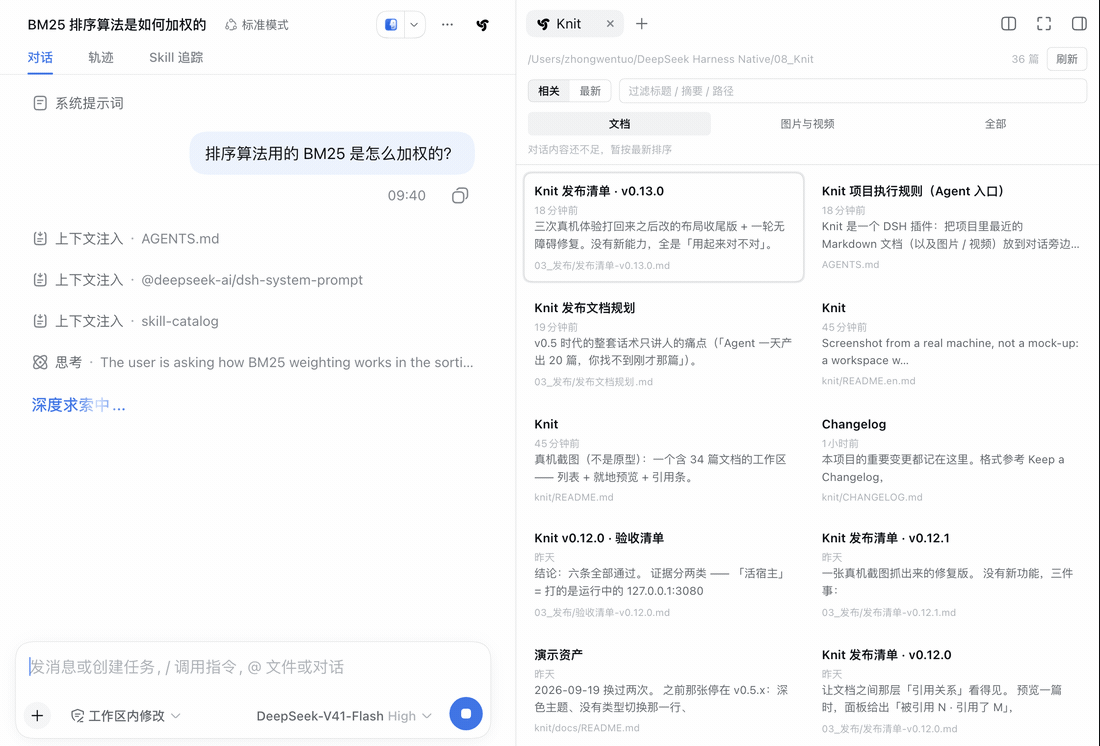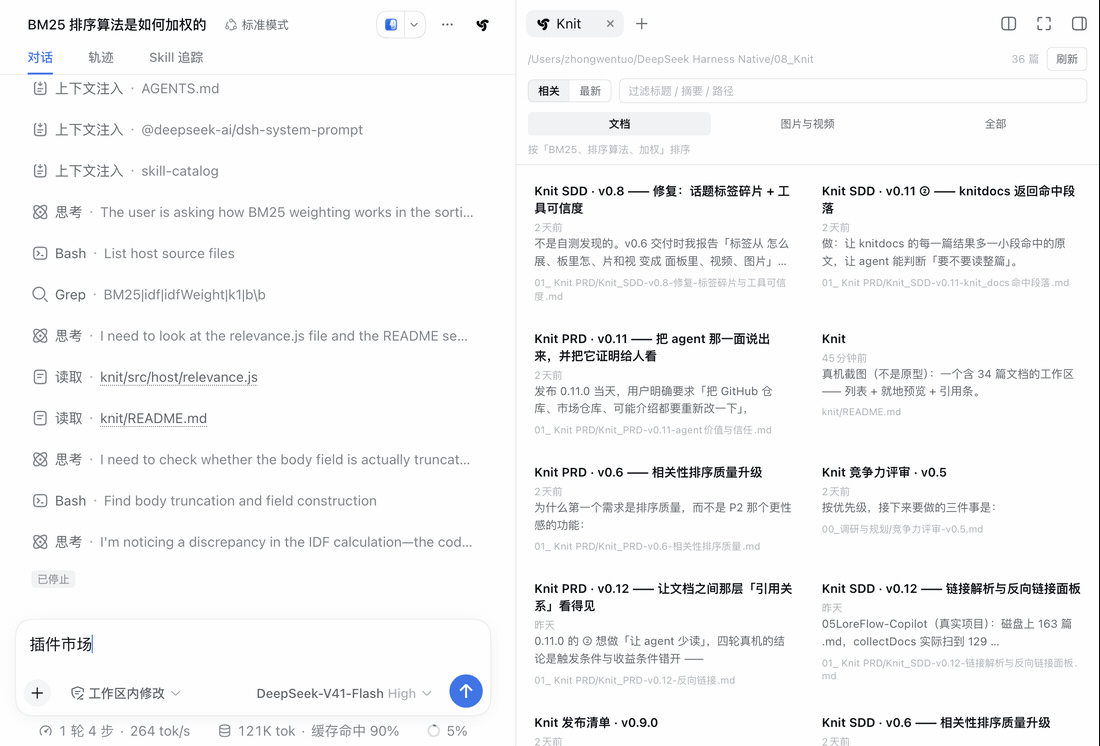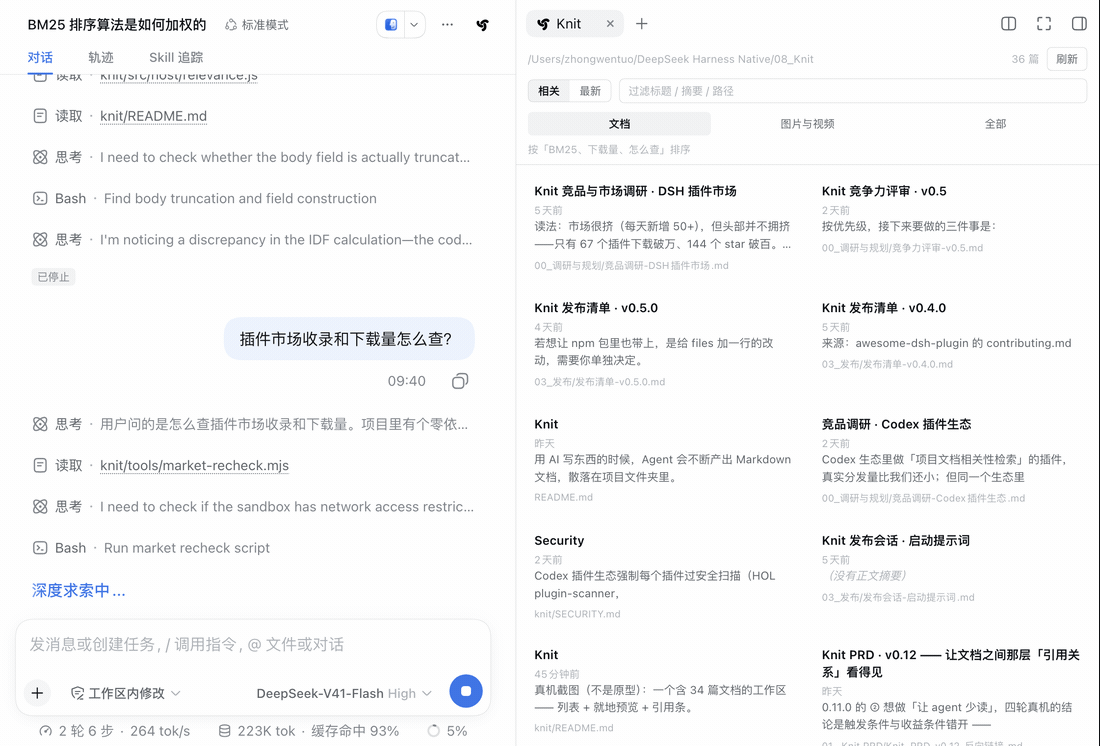
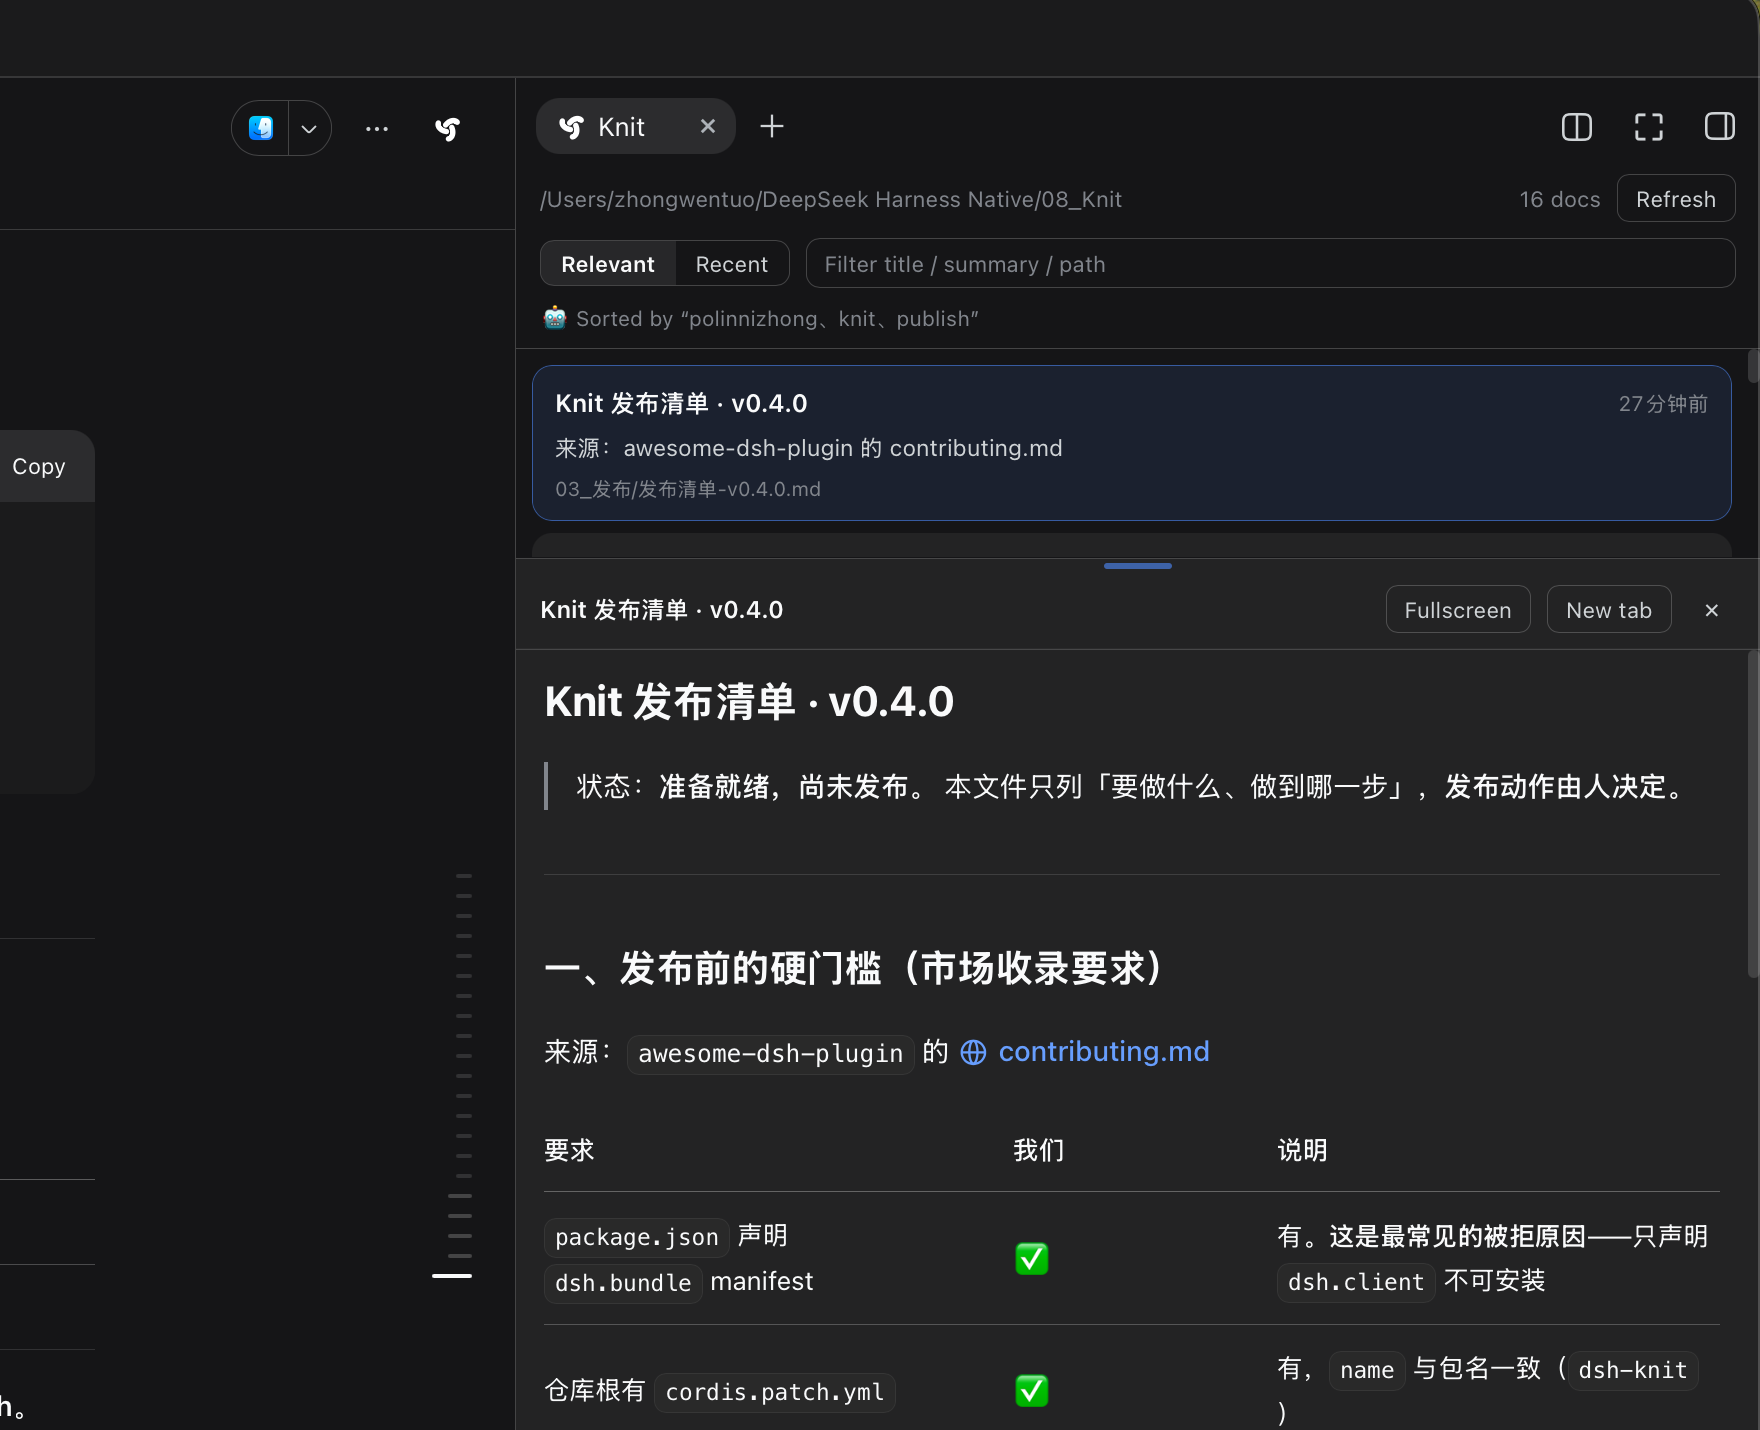
排序跟着对话走(同一个工作区、新开的一个会话):聊天里先聊过一轮发布清单,顶上几条就是发布清单那一族; 再问一句「Knit 里 BM25 的字段权重是怎么定的?」,列表整个换成 BM25 那一族 —— 分组标题与跨三档连续的序号随之一起出现,每篇下面多一行「为什么」(命中在哪、怎么命中的、命中段是哪一段)。 ⚠️ 面板是每 5 秒轮询一次的,重排不是发消息那一瞬间:这一屏里顶上几条是这一轮对话推进之后才整个换掉的 (中间那几十秒被剪掉了)。动图比真实时间快。
扫整个项目文件夹的文档 / 代码 / 图片 / 视频 · 排序跟着对话走 · 默认词法模式下不调模型、不联网
dsh plugin --profile web add dsh-knit
为什么需要它
Agent 一天产出 20 篇文档,你找不到刚才那篇。
这是它最开始要解决的问题:产出速度超过了人翻目录的速度。 DSH 自带的「最近文件」只记你点开过什么;一轮对话结束,前面那几篇就沉下去了。
Knit 换了个问法:不看「谁新」,看「和现在这件事有多相关」。 它扫的是整个工作区(不是这一轮生成的那几篇),按你正在聊的内容排序 —— 重启 DSH、换会话、跨天回来,它都还在。
后来问题往前长了一步:真要动一个功能时,最该先看的往往不是文档,而是那几行源码。 v0.19 起代码进了同一条链路。再往后,「排在前面」也不够用了 —— 排出来的那些,agent 到底读了没有?读完改过没有? v0.15–v0.18 补的就是这一层。
三句话:找到(扫全工作区、按当前任务排序)→ 组织(主要 / 辅助 / 相关三层 + 每条的理由) → 追踪(读了没有、读完变了没有)。
「最近文件列表」和「代码浏览器」都不是它
这两个类比各自只说中 Knit 的一个表层形态,说不到它回答的问题。
| 最近文件列表 | 代码浏览器 | Knit | |
|---|---|---|---|
| 范围 | 你点开过的 | 一棵目录树 | 整个工作区:文档 / 代码 / 图片 / 视频 |
| 排序 | 修改时间 | 你自己翻 | 当前任务的相关性(BM25 + IDF,本地算) |
| 输出 | 一条平铺列表 | 你打开的那一个文件 | 主要 / 辅助 / 相关 三层,每条都写明为什么在这里 |
| 给谁 | 你 | 你 | 你和 agent —— 同一份 Context Pack,走 knit_docs |
| 之后 | 不管 | 不管 | 读了没有 / 读完变了没有(读取证据 + 生命周期) |
三条最要紧的区别:
- 范围:最近打开列表只记你点开过的文件;Knit 扫整个项目文件夹 —— 重启 DSH、新开会话、跨天回来,它都还在。
- 排序:它按时间排;Knit 按你正在聊什么排 ——
聊架构,架构文档浮上来;聊 loader 的 bug,
plugin-loader.ts浮上来。 - 它不止于「找」:找完还要组织(三层 + 可核验的理由)和追踪(哪些真被读了、读完有没有变)。
默认词法模式下不调模型、不联网:全是本地字符串运算,零延迟、零成本、内容不出本机。
可选的混合模式默认关闭,指向**本机服务(loopback)**时内容不出这台机器。
⚠️ 语义收益仍待真 provider 实测(value-evidence: pending),不承诺召回提升。
混合模式到底发出去了什么
这段是按报文实测写的,不是按设计意图写的 —— 复现命令与逐条断言见
docs/evaluations/hybrid-retrieval.md(审计脚本
tools/semantic-request-audit.mjs 会把每一次请求的 body 录下来再逐条判)。
发出去了(请求体只有 { model, input } 两个字段,input 是一串文本):
| # | 内容 | 精确边界 |
|---|---|---|
| ① | 你这句查询原话 | 面板走会话路径时是「最近一条有实质内容的用户消息」,截到 80 字;knit_docs(query=…) 走显式路径时最多 2000 字。每一轮刷新都会重发一次(文档向量有缓存,查询没有) |
| ② | 每篇候选文件的标题 | Markdown 是正文里的第一个 # 标题(没有就用文件名);代码是带扩展名的文件名;图片 / 视频是去掉扩展名的文件名 |
| ③ | 每篇候选文件的摘要 | Markdown 的「摘要」是正文首个正文段落的节选(≤ 60 字)——它来自正文;代码的「摘要」是工作区相对目录(如 src/host/);媒体没有摘要 |
没有发出去:完整正文(审计对工作区里每一篇够长的文件都做了「开头 200 字 + 中段 200 字」两处探针,一处都没出现)、
绝对路径(工作区根 / 家目录 / file:// 一条都没出现)、会话历史、你工作区里没被选中的文件。
⚠️ 两个容易想当然的地方:
①**「摘要」不等于「与正文无关的元数据」——Markdown 的摘要是正文的节选,所以会有至多 60 字的正文离开本机**;
②图片 / 视频的文件名也会被发出去(它们没有摘要,发的是文件名本身,例如 screenshot-media)。
安装
dsh plugin --profile web add dsh-knit
装完重启 DSH,然后硬刷新浏览器(Cmd + Shift + R)。
怎么打开:
- 会话头部右侧的 Knit 图标按钮(就在右侧栏展开按钮旁边)—— 一键开面板
- 或右侧栏 tab 条上的「+」→「Knit 最近文档」
可选:装了 dsh-better-sidebar 的话,面板也会注册成它的一个 tab;
没装不受影响,两边是各自独立的可选依赖。
升级:命令和首次安装是同一条,装完同样要重启 DSH + 硬刷新。
功能
| 能力 | |
|---|---|
| 按当前对话相关性排序(BM25 + IDF)—— 默认纯本地、零模型调用;可选的混合模式默认关闭,见下 | ✅ |
| 当前任务上下文:把排序结果拆成 主要 / 辅助 / 相关 三层,每条都写明「为什么在这里」 | ✅ |
关系证据(v0.21):每行标出 检索 / 关系 / 用户固定;「为什么」展开行级证据(引用 / 导入 / 测试 / 文档,带对方文件与行号,面板最多 3 条、工具最多 2 条)—— 每条都能按行号 grep 回原文,一个字的理由都不是编的 | ✅ |
| 固定 / 排除(v0.21):固定进最上方独立区(不编号,三层编号不变);排除在检索之前生效(计数与状态摘要同时变,可恢复);宿主给了存储就活过重启,没给就写明「本会话有效(未持久化)」 | ✅ |
检索状态摘要(v0.21.x):面板头部一行如实显示 收集 · 排除 · 候选 | BM25 词法检索 · 关系 · 固定 | 入包(组内中点、组间细竖线、没有箭头),换任务 / 换档都跟着变 | ✅ |
工具栏一行(2026-10-12):相关 / 最新(排序)文档 / 代码 / 媒体(类型)—— 两组之间没有竖线,靠间距分界 | 右侧是搜索框(唯一可伸缩项,常规 180–240px,面板窄了先缩它,其余按钮永不被挤)。检索方式不在这行 —— 它是第三行状态摘要里的可点状态格(BM25 检索 ›,见下一条);四项彼此独立 —— 切排序 / 切类型 / 切检索方式都不动搜索词 | ✅ |
顶行计数(v0.21.x):只显示阿拉伯数字(9 / 过滤时 3 / 79)—— 量词随类型档变,索性不上屏;悬停提示里仍是完整那句(9 个代码文件) | ✅ |
给 agent 用的 knit_docs 工具:让模型拿回三层任务上下文(不是一条平铺列表) | ✅ |
文档生命周期(v0.17):每篇推荐文档现在处于 未读 / 已读 / 读后已更新 / 修改后已重新读取 哪一档,另外给出最近读了哪篇、包外读了哪几篇、上下文最近一次怎么变 | ✅ |
| 相关性 / 修改时间双模式一键切换(偏好记在 localStorage) | ✅ |
扫描会话工作区里的 .md 与上表那批代码后缀(递归,深度 ≤ 6,跳过 node_modules / .git / dist / build / out / coverage …) | ✅ |
生成 / 噪声产物不进检索:.map、*.min.js、*.min.css、*.bundle.js、*.generated.js、*.gen.js、*.lock、package-lock.json —— 你能打开它们看,但它们不会成为主要 / 辅助 / 相关上下文 | ✅ |
代码预览:行号 + 等宽 + 横向滚动 + 复制 + 「本地打开」;同名 app.js.map 存在时预览页脚多一个低权重「Source map」入口(点开按纯文本看,.map 本身不进上下文) | ✅ |
| 每项显示:H1 标题(无则文件名)+ 相对时间 + 首段摘要 | ✅ |
| 文档列表永远单列(v0.14 起,多列那套已整体删除);序号在每行最左边独立成一列(与标题第一行垂直居中),其余数据全在右边堆叠(右边第一行=Primary 点 + 标题 + 相对时间,时间靠右),摘要再往下;列表行里不再有路径 —— 它和预览头那行可点的路径重复,只保留后者 | ✅ |
| 单击就地展开预览,再点收起(媒体档例外:单击只移光标,看东西用悬停 / 双击,见下两行) | ✅ |
相对路径图片真正渲染(./img/a.png、../assets/b.png) | ✅ |
代码上下文(v0.19):.js .mjs .cjs .ts .tsx .jsx .py .json .html .htm .css .scss .yaml .yml .sh .bash .zsh 与 Markdown 进同一个检索池,共用同一份 BM25、同一个 Context Pack、同一套生命周期 —— 不是第二套「代码搜索」 | ✅ |
| 文档 / 代码 / 媒体 三类一键切换(偏好记住,默认仍是文档,老体验不变);选中态是下划线式页签(v0.14 起就是这个;不带品牌色描边、也没退回灰底按钮 —— 2026-09-29 明确裁定过;页签「媒体」2026-10-06 由「图片与视频」改短,「代码」v0.19 加入;「全部」档 v0.23.1 已从 UI 删除) | ✅ |
| 图片与视频:方形缩略图网格,格子基准固定 104px、列数由宽度连续数出来(320px → 2 列 / 632px → 5 列 / 1200px → 10 列),格子大小基本不变;纵向有多少行就铺多少行,超出交给列表滚动;视频自动取首帧、叠播放三角与时长角标(零依赖、不转码) | ✅ |
| 悬停看大图:鼠标停在图片卡片上 350ms 弹出一张大图(上限 420×420,按可用空间收缩;优先摆左侧,放不下翻右侧;滚动即收)。只做图片 | ✅ |
双击图片 → 整屏查看器:portal 到整页、模态级层级、毛玻璃遮罩随深色模式变;左侧一列「当前这张附近 10 张」缩略图(点缩略图切图,当前那张自动滚进可视区);↑↓ / ←→ / 图片区滚轮都能翻页、Esc / ✕ / 点图片以外关闭;工具条带收藏 / 本地打开 | ✅ |
| 双击视频 → 面板内就地预览:可播放可拖动(HTTP Range 流式,不全量下载)。查看器只做图片,视频不进去 | ✅ |
预览面板可拖高度(20%–80%,位置记住)、可全屏,Esc 退出;全屏时头部 / 排序条 / 类型档 / 使用情况 / 列表全部让位,预览铺满整个面板 | ✅ |
「本地打开」:用系统默认应用打开当前预览的这篇文档;预览头那条路径点开的是它「所在的文件夹」并顺带选中这个文件(reveal,macOS 是 Finder 里 open -R;与顶部那行工作区路径同一套机制,差别只在「打开目录」vs「定位到文件」,完整相对路径在悬停提示里) | ✅ |
| 双击文档 / 代码在新标签页打开(官方文档预览,带 PDF 渲染器与渲染方式切换);图片的双击改成了查看器 | ✅ |
HTML 的「网页预览」(v0.19 追加):预览头只对 .html / .htm 多一个按钮,点了在官方文档预览标签页里按网页渲染 —— 那一侧是 DSH 自带的 HTML 渲染器(默认静态档:清洗过的文档 + 不给 sandbox 权限的 iframe + CSP 挡脚本 / 外部资源 / 表单 / 嵌套框架,内联 <style> 与 data: 图片保留)。就地预览给的是源码,两者不重复;其余代码类型不给这个按钮 | ✅ |
| 过滤框:按标题 / 摘要 / 路径实时过滤 | ✅ |
| 点工作区路径:用系统文件管理器打开项目文件夹 | ✅ |
| 悬停入口按钮偷看:弹只读浮层列最近 5 篇,点击才进右边栏(不推挤布局;浮层只有「头 + 列表」,没有多余的横线与提示语) | ✅ |
键盘导航:↑ ↓ 移动即预览 / Enter 切换 / Esc 收起;媒体档 ← → 按屏幕位置跨行,Home / End 到首尾(文档档永远单列,← → 没有空间含义) | ✅ |
| 每 5 秒自动刷新 + 手动刷新;2 分钟内改动过的文档打 🆕 | ✅ |
| 中英双语,跟随 DSH 语言实时切换(不用重载插件) | ✅ |
列表是标准 listbox/option 语义,选中项用 aria-activedescendant 播报;媒体网格里的键盘焦点有可见描边 | ✅ |
| 默认零模型 / 零网络出口:默认的词法模式全程在本机做字符串运算 —— 不调模型、不联网、零延迟 | ✅ |
可选混合模式(默认关闭)(v0.23):需你自己配置 provider(Ollama / OpenAI 兼容)。配了远程 provider 时,发出去的是你这句查询原话 + 每篇候选文件的标题与摘要 —— 完整正文与绝对路径都不发,但 Markdown 的「摘要」是正文首个段落 ≤ 60 字的节选、图片 / 视频发的是文件名(逐条口径见上面的「混合模式到底发出去了什么」);向量只在内存里,配置存在 DSH 存储的独立单元 knit_semantic。指向本机服务(loopback)时内容不出这台机器。⚠️ 语义收益的证据仍待真 provider 实测(value-evidence: pending)—— 本项目不承诺召回提升 | ✅ |
Git 变更关联(默认关闭)(v0.24):按工作区里未提交的改动列出「还该一起看的文件」,依据是 Knit 已有的四类证据(引用 / 导入 / 测试配对 / 文档提及),每条都给出起点 + 类型 + 行号。只读:只跑一条 git status(关掉 fsmonitor 与可选索引刷新,子进程环境白名单 —— 任何 GIT_* 都不继承),不读 diff、不读文件正文、不发网络;读不到时如实写出原因(不是只放在悬停里)。⚠️ 本版新增宿主接口,升级后需要重启 DSH | ✅ |
相关度不做可视化(不显示百分比、不画长条)—— 排序本身就是答案,名次即相关度。
媒体档长什么样
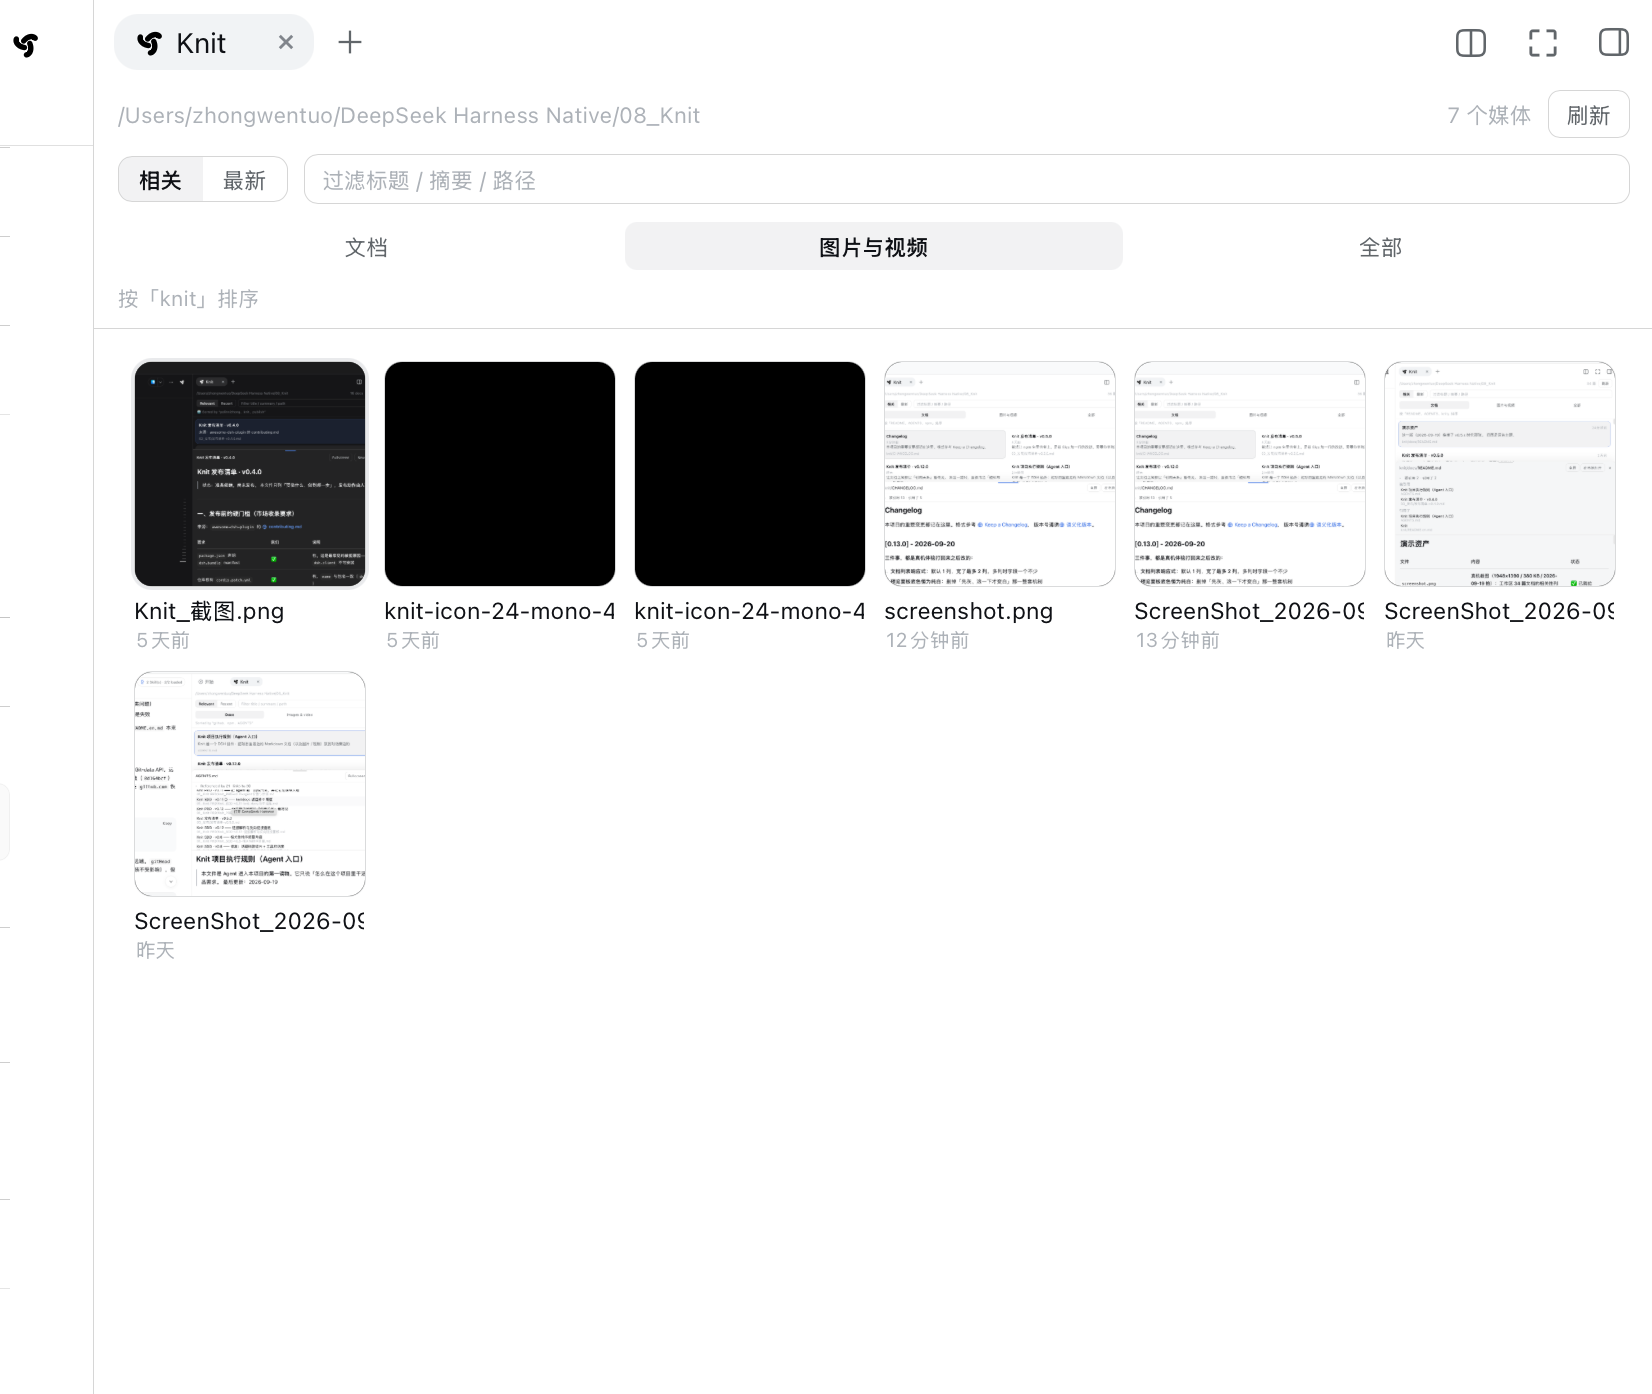
媒体:方形缩略图,列数跟着面板宽度连续变 —— 这一屏是 6 列,格子约 110px。 列出的就是工作区里真实的图片与 SVG 文件(这一屏 18 个媒体),所以看起来像一屏文件缩略图 (那个纯黑方块是单色 SVG 图标本身,不是加载失败)。 视频会取首帧当海报、中央叠播放三角、右下角叠时长,只是这个工作区里没有视频,所以这一屏看不到。
当前任务上下文(v0.14)
排序解决的是「哪几篇跟这段对话最像」。但你要的往往是另一个问题的答案:
现在这个任务,项目里哪些东西最值得先看?
Context Pack 是对这个问题的回答,但它是数据层的结构(主要 / 辅助 / 相关三层 + 每条的确定性理由), 不是一张要单独显示的卡片。所以它直接落在文档列表里:相关模式下,文档档从一条平铺列表 变成三层分组,组名后面跟一句极短的说明。
┌─ 文档列表 ────────────────────────────┐
│ 主要上下文   先看                      │
│   01 ● 相关性排序算法      5分钟前     │
│      标题命中:排序                    │
│                                        │
│ 辅助上下文   辅助                      │
│   02  排序评测集           2小时前     │
│      正文命中:关键词计数              │
│                                        │
│ 相关上下文   背景                      │
│   03  CHANGELOG.md         12天前      │
│      正文命中:排序                    │
└────────────────────────────────────────┘
示意图省掉了每行的摘要。真实的行结构是:最左边独立一列=序号(与右边第一行垂直居中**), 右边堆叠=第一行「Primary 点 + 标题 + 相对时间(靠右)」→ 摘要(没有路径 —— 列表行里不显示它,路径在预览头上、目录收敛成
…/)。而且这个列表永远是单列(面板拖到多宽都一样)。 「其他相关文档」不在包里、不编号,那一列放一个中性的·占位 —— 但只在这一屏里有号时才放 (时间序 / 平铺列表整屏没号 ⇒ 一个标记都没有;混着才刺眼)。
分组之间不画横线:层级靠 16px 的空间、组名与字号建立,不靠分割线。 分组里没有分数、没有百分比、没有星级 —— 「为什么在这里」只写确定性的事实。
右侧那个「当前任务上下文」说明栏已经删掉了(2026-09-29)。它说的和左侧三个分组是同一件事 —— 当前任务就在列表上方那行弱化元信息里,「命中 N 篇」与头部总数重复,三条证据类型就是 三个组名;视觉价值有限,而且容易把 Knit 做成 AI Dashboard。随它一起删除的还有 「调宽 / 拖出浮动 / 右缘吸附」那一套(见
CHANGELOG.md)。
分层是确定性规则,不是 AI 判断
| 层 | 什么时候进 | 上限 |
|---|---|---|
| 主要上下文 | 命中,且有「落脚点」(话题词命中标题或摘要),且相关度不是背景噪音(≥ 最高分的 30%) | 1 |
| 辅助上下文 | 对某个「焦点词」有深入命中(该词不止一篇在讲,而且这一篇是把它讲得最多的那一篇);或与某个主要上下文有引用关系(「被引用」/「引用了」,两个方向分别标注) | 3 |
| 相关上下文 | 其余有命中的条目,以及零命中但有引用关系的邻居 | 5 |
上限是上限,不是配额:主要上下文允许为空(实测真实工作区上有相当比例的话题 确实没有一篇文档在正经讲它),相关上下文也允许为空。说不出的理由就不出场 —— 零命中又没有任何引用关系的文档不是「与当前任务有关」,放它进来只能配一句 「可能对你有帮助」,那是这一版明确不要的东西。
**「为什么在这里」**永远是一句可核验的事实:
| 理由 | 说的是什么 |
|---|---|
标题 / 摘要 / 正文命中当前话题:词 | 真的命中了,而且告诉你命中了哪个词 |
| 被主要上下文引用 | 主文档里那条路径指过来的 —— 读主文档时你下一步就会点它 |
| 引用了主要上下文 | 它里面提到了主文档 |
没有「AI 判断这篇重要」「可能对你有帮助」这类句子,也没有百分比、星级、置信度条 —— 理由要么是可核验的事实,要么干脆不写。
边界(说清楚,不夸大)
- 引用关系不等于「更相关」。 实测过:把引用图当排序信号补不上词面错配那个缺口。 所以引用关系只能把一篇文档放进辅助 / 相关层,永远不能把它抬进主要上下文。
- 排序引擎本身没变。 这一版加的是排序之上的一层投影 —— BM25 的打分、评测 (top-1 / MRR / 陷阱用例)一行没动。如果检索没把对的那篇找出来,分层也只能在 找到的那几篇里分 —— 它救不了召回。
- 不做任务理解。 Context Pack 里那个「当前任务」字段放的是最近一条用户消息的原文, 不是任何概括 —— Knit 不解一句话的意思,只是把它如实摆出来。真去概括需要模型,而 Knit 的默认词法模式不调模型。
代码上下文(v0.19)
上面这一整套(检索 → 三层 Context Pack → 读取证据 → 生命周期 → 上下文变化 → 使用情况) v0.19 起同样适用于代码。没有第二条链路:代码文件走的是同一个 BM25、同一个 Context Pack、 同一套 Read Evidence 与生命周期。
为什么加了代码是有意义的。 一个真实任务(「改 plugin loader,让它支持新的 plugin metadata」)
最该先看的往往不是某篇文档,而是 plugin-loader.ts 本身。v0.18 之前 Knit 扫不到它 ——
面板里只有 Markdown,agent 也只能靠 glob 猜路径。
第一批支持的后缀(严格限定)
.js .mjs .cjs   .ts .tsx .jsx   .py   .json
.html .htm      .css .scss      .yaml .yml
.sh .bash .zsh
明确不支持(这一版刻意不做):.go .rs .java .kt .c .cpp .h .hpp .cs .php .rb .swift .sql。
为什么不一次全上:这一版要验证的命题是「把当前任务真正需要的代码纳入上下文有没有用」, 不是「支持了多少种语言」。范围越小,「没用」这个结论越可信。
代码的排序字段与 Markdown 不同
代码没有「标题 / 摘要 / 正文」这套结构,硬套会把文件名这个最强的信号降权。所以代码条目:
| 字段 | 权重 | 放什么 |
|---|---|---|
filename | ×4 | context-manager.ts —— 文件名本身就带任务语义 |
path | ×2 | src/context/ —— 目录名是第二层信号 |
content | ×1 | 文件前 8 KB(不是全文,见下) |
Markdown 仍是 title ×4 / summary ×2 / body ×1。两套字段权重,同一个 BM25。
有边界的三件事(都实测过)
-
正文有界:代码只读前 8 KB 进语料。不是为了省磁盘,是为了让扫描时间与检索延迟 不随「项目里有多少 JS」线性爆炸。
-
候选有上限:代码准入上限 300 个(Markdown 仍是 400)。 这个数字是量过真实工作区才定的 —— 不是拍的。上限存在的理由是需求里那条: 代码不许把原有 Markdown 上下文挤出去。
-
生成 / 噪声产物一个都不准入:
不进入检索的东西 为什么 app.js.mapsource map 是调试产物,不是上下文;但同名源文件在时,它的预览里给一个「Source map」入口 *.min.js*.min.css压缩产物,读它没有意义 *.bundle.js*.generated.js*.gen.js打包 / 生成产物 *.lockpackage-lock.json锁文件,几千行机器生成的 json node_modules/dist/build/out/coverage/…沿用 v0.18 就有的目录排除,没有重写 ⚠️ 「不进上下文」≠「不能看」。你通过 DSH 原生文件树打开
dist/app.js,Knit 不拦你 —— 上下文资格与文件可见性是两件事。
代码预览
点一个代码文件,就在面板下方就地展开(和 Markdown 一模一样的位置、一样的交互,
没有新的弹窗):行号 + 等宽字体 + 横向滚动,页脚给复制与「本地打开」。
有语法高亮,但用的是 DSH 自己的那一套(v0.20,2026-10-07 按用户要求改):客户端复用
@deepseek-ai/dsh-client-ui-primitives 的 useCodeHighlighter,颜色全部来自官方的 --shiki-* 令牌
⇒ 浅色 / 暗色都跟 DSH 一致,不自己造一套配色。只给命中段那一带上色(前后各 60 行,窗口
最多 800 行),其余行保持默认正文色 —— 没有命中段的文件一个 token 都不上色(高亮要跑同步分词,
4 千行整篇着色要 2 秒量级);宿主没导出这个 hook(旧版 DSH)或行数对不上 ⇒ 静默回落纯文本。
不做代码折叠、不做多标签、不做 git diff —— Knit 不是代码浏览器。
同类入口还有:双击进官方标签页预览(带 DSH 自己的渲染器)、Esc 收起、键盘 ↑↓ 预览。
关系与上下文控制(v0.21)
排序回答「哪几篇像」。这一版回答另外两个问题:「它为什么在这里?」 与 「我自己想留住 / 挡掉的那几篇呢?」(原 v0.21 与 原 v0.22 在这里合并成一个版本。)
关系是解释,不是第二个排序阶段
每条关系都要有能 grep 回原文的证据,只做四类:
| 类型 | 证据是什么 | 例子 |
|---|---|---|
references | Markdown 引用了另一篇 Markdown | README.md 第 81 行提到 docs/guide.md |
documents | Markdown 写到了某个代码路径 | 设计文档第 12 行提到 src/host/index.js |
imports | 代码里的 import … from / require(…),逐行正则 | test/deep-scale.test.mjs:22 → ../tools/deep-benchmark.mjs |
tests | 文件名约定上的测试 ↔ 被测方(唯一不带行号的一类) | context-manager.ts ↔ context-manager.test.ts |
- 面板每篇最多 3 条、
knit_docs每篇最多 2 条;被截断时如实写「共 N 条关系」。 顺序即优先级:references>imports>tests>documents。 ←= 对方提到这一篇,→= 这一篇提到对方;行号属于「谁在提这件事」的那个文件。- 关系不参与排名:关掉它,三层的成员与顺序逐字相同(有测试逐条盯着)。
- 没有 AST / LSP / Tree-sitter,也没有调用图 / 依赖图 / 符号索引。注释里写个路径不算关系, 代码也只能被指向、不能当引用源 —— 这条从 v0.19 起就是断言,原意一个字没改。
「来源」只有三个词
相关模式的每行标题旁一个弱化徽标:检索(命中当前任务关键词)/ 关系(靠引用被带进来)/ 用户固定。没有分数、没有百分比、没有色阶;平铺列表与「最新」排序下一个都不出现。
⚠️ 诚实边界:在候选充足的真实工作区里,三层的槽位总是先被命中文档占满, 所以「关系」徽标很稀有 —— 这是实测结论,不是没做。关系的价值在**「为什么」那一栏**: 点开是行级证据(类型标签 + 对方文件 + 第 N 行 + 打开),点「打开」预览到那一行真实原文(±2 行、灰底高亮)。 证据是向下延展的:展开时下面的行被挤下去,收起来回到原位(v0.21.x 修过一次溢出 —— 入场补间
fill:'both'播完仍会钉住行高,收尾必须先cancel())。
固定 / 排除
- 入口在哪(v0.21.x):标题行只留「序号 · 标记 · 标题 · 时间」;
来源词与固定/排除一起 排在证据行的右端(顺序固定 → 排除 → 检索),默认不显示 —— 鼠标悬停到该行、键盘光标停在该行、 或焦点进入该行时才出现(用visibility而不是opacity:0,隐藏时真的退出键盘焦点序, 也不占额外高度、不引起横向跳动)。三个入口都是纯文字按钮,没有图标。 - 固定:该行移到列表最上方的「固定上下文」区,
provenance变manual。 这不是排序干预 —— 固定区不编号,三层的01…0N一个都不变。 - 排除:在检索之前就把它挡掉(顶部计数与状态摘要同时变),列表上方留一行弱化说明 + 「恢复」。 「恢复」只在它真的还在工作区里时给出(切「代码」档不会把一篇 Markdown 误报成「文件不见了」)。
- 活过重启:取决于宿主给不给存储(
ctx.storage的kv)。给了就落盘到~/.dsh/storages/knit_control.json(按工作区隔离,键 = 工作区路径 + 相对路径); 没给就退化成内存态,面板写明「本会话有效(未持久化)」而不是假装记住了。 两条真机缺陷在这一版修掉:① 插件被重复加载时存储句柄会打架(一个 unit 只能有一个活句柄), 现在共享同一份登记表;②persisted曾经在拿到存储的那一刻就报「已记住」—— 它报的应该是结果而不是能力,现在证据到之前一律说没把握,写失败在同一次响应里就说出来。
头部那条检索状态摘要
面板头部一行事实:收集 N · 排除 N · 候选 N | BM25 检索 · 关系 N 条 · 固定 N | 入包 N。
三组就是阅读顺序 —— 工作区候选(扫描到多少、这一批真的排掉几篇、排除之后剩几篇进入检索)、
检索与调整(这一路是纯本地 BM25 词法检索,后面跟着包里的关系证据条数与被固定移出三层的篇数)、
最终结果(三层现有条目数)。
组内是中点 ·、只有三组之间一根细竖线;没有箭头 —— 从前那串 ↓ / → 会把一条
已经完成的管线画成流程图,读起来像进度条,2026-10-09 已按用户裁定整体删除。
换任务、换类型档、有固定或排除时,每一格都如实跟着变;它只负责展示信息,不承担任何交互。
它紧贴工具栏、位置不随开关变:点右上「使用情况」时,观察层排在它下面,这一行不会被顶下去
(2026-10-09 用户反馈;渲染顺序 = 工具栏 → 状态摘要 → 排除说明 → 通知 → 观察层 → 列表)。
工具栏那一行(v0.21.x)
相关 / 最新(排序)文档 / 代码 / 媒体(类型)(两组之间没有竖线)|右侧只有搜索框(唯一可伸缩项)。
检索方式 = 状态摘要里的可点状态格:(BM25 检索 ›;视觉照命中段 .knit-hit 那套:底 --knit-chip-bg、圆角 6px、内边距 1px 6px、次级灰字、字号 / 行高 / 字重与命中段逐字同值(11px / 15px、不自己定字重);hover 只提亮文字并给文字加下划线,右边的箭头 › 不划线(2026-10-13 用户裁决:那一格的下划线只属于文字层);箭头复用「最近读取」行那个 ›,展开时横向翻转向上);点开菜单相对这一格弹出,里面是 词法检索 / 混合检索 · 实验 两个选项(同样沿用命中段那套:圆角 6px、选中态底 --knit-chip-bg)、当前生效状态的说明,以及「混合没生效」时的就地配置入口。菜单面板本身仍是浮层(bg-base 底 + l3 描边 + 阴影)—— 浮层要读起来像浮层。
- 排序 / 类型 / 检索方式是三个条件,不做成一个整体:排序与类型之间的竖线 2026-10-12 已删除(
.knit-bar-sep整个类名不复存在,靠.knit-bar的间距分界);检索方式则搬进了状态行(第三行),不再占工具栏的位置 —— 从前那根线(1px、border-l3、aria-hidden) 就是边界。类型组原先自己占一行,现在并进工具栏 —— 选中态仍是 v0.14 的下划线式页签,没退回灰底按钮。 - 最右是一个右对齐容器(
.knit-bar-right):里面是检索模式(flex:none,紧凑下拉)与搜索框 (flex:1 1 180px+min-width:0+max-width:240px)。搜索框是唯一可伸缩项 ⇒ 常规面板里它就是 180–240px 并贴住右端,面板变窄时先缩它;排序 / 类型 / 检索模式都是flex:none,永不被挤。 - 四个条件彼此独立:选「代码」再选「最新」= 最新的代码;切检索模式不动排序与搜索词;搜索只过滤当前范围
(
sort/kind/query/retrieval四个独立 state)。 - ⚠️ 「最新」档不显示检索模式(时间序没有 Context Pack,语义无处可落),但不重置已存的偏好 —— 切回「相关」时仍是你上次选的那个模式。
- 没有图标、没有醒目的胶囊;其余项用次级文本,选中项用下划线 + 主色文字。
也给 agent 用:knit_docs 工具
同一份排序,除了给你看,也开了一个口子给模型。
装好之后,agent 的工具列表里会多一个 knit_docs:它可以问
「这个项目里跟当前话题最相关的文档是哪几篇」,拿回同一个 Context Pack ——
primary / supporting / related 三层,每项带路径 + 标题 + 摘要 +
结构化理由(direct / summaryMatch / bodyMatch / linkTarget / linkSource / related)
- 项目角色(
impl/test/config/design/doc)+ - 来源三值(
provenance:retrieval/relation/manual)+ 最多 2 条关系 (relations: references ← docs/x.md:12; imports → src/y.js:3,←是对方提到本条目)+ 被固定的条目在pinned分区里、被排除的条目完全不出现(v0.21)+ 命中的那一小段原文和它的行号区间(match: lines 147–163 — …),再用它自己的read打开其中一篇。
为什么有用:agent 想引用项目里已有的文档时,只能靠猜路径、或者把 glob
出来的路径一个个 read 试过去。这份排序 Knit 每一轮已经算好了,这个工具只是把它交出去 ——
省掉的是**「先猜哪几篇相关」这一步判断**(实测:拿到包的 agent 不再需要 glob 去凑候选)。
只读,且不存储任何东西:它读的是项目里现成的文件,不是「记忆」。 和记忆类插件的区别是:它们起点是空的(agent 得先记过才有东西可召回), Knit 一装上就有整个项目的历史文档可用。
四个细节:
- 给的是任务上下文,不是一条平铺列表。面板与工具共用同一个 Context Model —— 没有两套排序逻辑,也没有两份规则。
- 不返回相关度分数。它是相对分数(永远有一篇 100%,每次刷新可能换人当), 给模型看会被当成绝对置信度去推理。顺序即相关度 —— 与面板同一条规矩。
- 搜的是全文(v0.20 起)。每篇文件都按结构切成分片、逐片打分,所以「相关内容在前 2500 字之后」 不再等于「搜不到」;单文件超过 256 KB 时只索引到那里,媒体没有正文 —— 这两条边界会在输出里如实说明。
- 不返回正文。只给命中片段(每篇最多一段、≤200 字符),agent 有自己的
read工具; Knit 负责发现,不负责搬运。 - 拿不到会话就报错,不兜底。HTTP 路由在会话查不到时会兜底到进程 cwd (兼容不带 sessionId 的老客户端),工具没有这个包袱 —— 兜底只会扫到一个不相干的项目并返回它的文档。宁可报错,也不返回错的东西。
⚠️ 代价要说清楚:工具描述会进每一次请求的系统提示词。 装 Knit 的用户每个会话都会多占一点 token。这是「让 agent 有能力」的必要成本。
它有没有被用上(v0.16 → v0.17)
Knit 会排出「现在最该先看的几篇」,但排得对不对,过去只能靠感觉。 v0.15 起有一层可核验的使用反馈:把 agent 真实读过的文件,跟读发生那一刻生效的那份上下文对起来。 v0.16 把这件事钉死:归因在读发生那一刻结算并冻结 —— 之后上下文怎么换,历史数字都不会改口 (v0.15 里同一个读会被「现在」重判成包外,那是 bug)。
默认关。 面板头部有一个「使用情况」开关,打开之后列表上方会多出一块观察层 (v0.18 起叫 Usage Lens,形状见下面「把使用情况读出来」一节)。它最上面一行仍然只报事实:
使用情况                                      Epoch 5   ˄
174 次读取 · 28 篇包外 · 上下文变化 3 次
- Context Epoch:一份内容有变化的上下文 = 一个 Epoch(内容没变就不新建,轮询不会灌进几十个)。
Epoch 4是累计编号,不是「第几份包」。 - 两个只记事实的字段:
continuedReadAfterExit(离开这份上下文之后它仍然被读)、reEntry(离开过、又回到包里、又被读)。它们不许被读成「Agent 不认可新上下文」—— 那是推断,不是事实。
它只报事实:先看的那篇被读了没有、读了几次、多少篇落在包外、上下文换过几回。 没有分数、没有百分比、没有进度条 —— 这些数字不是估算出来的,是数出来的。
三条边界:
- 默认关闭:不打开就不统计任何东西(Knit 订阅宿主事件流,但回调第一行就按会话早退, 没开审计的会话只花一次 Map 查找)。这笔账该由你决定要不要付。
- 不重复 DSH 的轨迹:证据只有一个来源 —— 会话事件流里已经存在的
tool/call/tool/result事件(成功的read)。没有新的事件总线、没有 Runtime Trace、也没有 Event Store。 - 打开开关的那一刻会回填一次:订阅是唯一的读证据来源(旧的
session.snapshotEvents()已被 DSH 标为 deprecated,不再新增生产调用),所以闸门打开之前发生的读,Knit 当时确实看不见; v0.17 起在闸门打开的那一刻回填一次本会话已有的事件,让「未读」变成有证据的结论。 ⚠️ 回填的读按我们已知最早的那份包归因(更早的包无从得知)。 - 不落盘:数据只在宿主内存里,重启 DSH 就没了,别把它当长期统计。
agent 侧同样可选:knit_docs 加 audit: true(默认 false),工具结果末尾会多一行
Usage since the last pack: …(报的是上一份包)。
想离线核对:node tools/context-feedback-eval.mjs 回放最近一份真实会话日志,
--control 是「一份包都不交」的对照组。⚠️ 它把「包外」拆成两半 ——
Knit 索引里有、却没进包(真漏)与压根不在索引里(.js / .json,Knit 本来就不索引这些);
不拆开的话包外比例恒高,读起来像「Context Pack 没用」,其实是量错了东西。
v0.17:读完之后,这篇文档现在是什么状态
打开「使用情况」之后,除了统计,还会多两样东西:每篇推荐文档的状态, 以及「最近读了哪篇 / 包外读了哪几篇 / 上下文最近一次怎么变」。
⚠️ 下面这段 ASCII 是 v0.17 当时的界面形状。v0.18 把这一块重做成了列表上方的 Usage Lens (形状见下一节)—— 判据、四档状态、数据来源一个字没变,这一节讲的是数据与判据。
当前上下文 · Epoch 4
最近读取:SDD-v0.17.md · 12 分钟前

主要上下文
01 ● SDD-v0.17.md        已读 ×3
02   feedback.md         未读

辅助上下文
03   context.md          已读
04   eval.md             读后已更新

相关上下文
05   README.md           修改后已重新读取

上下文外读取 · 2 篇        ← 点得开,展开是「哪几篇」
上下文刚刚变化             ← 点得开,展开是「进入 / 离开 / 换层」
四档状态全是事实,不是评分:
| 界面文案 | 事实 |
|---|---|
| 未读 | 本会话没有一次成功 read |
| 已读 / 已读 ×N | 成功读过,且最后一次读取之后文件没变 |
| 读后已更新 | 最后一次成功读取之后,文件的 mtimeMs 变过 |
| 修改后已重新读取 | 变过之后又成功读过一次(再变一次就退回上一档) |
- 判据就是文件的
mtimeMs—— 工作区扫描本来就拿得到它,所以不比对内容、不扫描全文、不新增索引。 拿不到 mtime 时不下结论(宁可停在「已读」)。 grep/glob/bash不算读;失败的read也不算。- 「最近读取」按事件序号判定「谁最近」,不叫「正在阅读」:Knit 无法证明 Agent 此刻还在读它; 它落在 Context Pack 之外也照实显示。
- 上下文外读取 · N 篇只表达「这篇不在当前包,但 Agent 确实成功读过它」—— 不写「Knit 漏掉了」,也不做漏召回率、命中率、Context 质量。
- 上下文刚刚变化只展示最近一次 Delta(
+进入 /-离开 /↔换层, 任务变了就说一句「任务上下文已更新」)—— 没有时间线,也没有事件浏览器。 - 状态文字排在标题和时间之间,标题仍然是视觉主体;不用红绿、不给分。 关掉开关则一个都不出现(也不统计)。
- 列表不再「一闪一闪」(2026-10-03 用户要求):被读到的行从下方淡入上浮,被挤掉的行
自上而下擦除渐隐;同一拍里多篇按 45ms 错开(最多 6 档);换了层或名次变了的那篇
从老位置飞过去(FLIP,340ms)。首屏、换类型 / 换排序 / 搜索词,
以及系统开了「减弱动态效果」时都不播。这不是新功能,只是把「谁进来了、谁走了、
谁挪了位置」演给人看 —— 索引、排序、分层与
knit_docs的输出一个字都没改。
v0.18:把「使用情况」读出来(Context Usage Lens)
v0.17 的信息都在,但摞在一行字和几个折叠块里,读不出结构:哪一层读得多、最近读的是哪一篇、 包外那二十篇里哪几篇被反复读、这次变化是进是出。v0.18 把它重做成列表上方的一块观察层 —— 不是弹窗、不是新页面、也不是 Dashboard:
使用情况                                      Epoch 5   ˄
174 次读取 · 28 篇包外 · 上下文变化 3 次
当前上下文
  主要  1 / 1          辅助  2 / 3          相关  0 / 5
  ●                    ● ○                  ○ ○ ○ ○ ○
最近读取        docs/eval.md                   12分钟前  ›
上下文外读取                                            20  ›
上下文变化                                     最近一次  ›
- 当前上下文 Coverage:三层各给「状态点 +
已读数 / 本层总数」。点某一层会滚到那一层并短暂亮一下 (不画箭头、不画横线 —— 用空间说「就是这里」)。只报事实:没有进度条、没有百分比 —— Knit 不评价「这份上下文用完了没有」;Primary 不存在时整列不显示,不画0 / 0的假层。 - 行内状态点:未读=空心圆 / 已读=实心圆 / 读后已更新=实心圆套内圈 / 修改后已重新读取=
↻, 与原来那行文字同时存在(状态点说状态、文字说次数)。点它=打开这一篇。不用红绿、不加徽章。 Coverage 的三层圆点与文档行这一颗同一套 token、同一个 6px 直径 —— 两处说的是同一种状态语言。 - 最近读取是一行可点的事实(
文件名 · 相对时间 ›),点它直接打开该篇,不重新请求列表。 它仍然是「最近一次成功 read」—— 没有改成「正在阅读」。 - 上下文外读取默认最多 10 篇 + 「还有 N 篇」,每行可点、带状态;按读得最多的排
(
count DESC)—— 这是事实排序,不是相关度。不许从这里把文档加进 Context(V0.18 不做 Context Control)。 - 上下文变化默认折叠,展开按 进入 / 离开 / 换层 分组,每组最多 5 条;只展示最近一次。
- Lens 自己能展开 / 收起。收起不等于关掉统计 —— 收起只是「统计开着、暂时不想看细节」; 关掉开关才真的一个统计 DOM 都不产生。
- 面板很矮(< 420px)时降级成「摘要 + Coverage + 最近读取」,变化明细点开仍在; 滚动始终只交给列表 —— 没有第二个滚动容器,窄侧栏里不会滚轮套滚轮。
数据一个字都没新加:全部来自 v0.17 已有的 lifecycle / recentRead / outsideDocs / latestDelta
与当前 context 的三层,Coverage 是从它们派生的(纯函数 coverageOf / groupOutsideDocs / groupDelta)。
knit_docs 的工具输出没有跟着变大:它仍然只负责找上下文。
检索是怎么算的(实现细节,不是产品定义)
这一节是证据,不是卖点:支撑上面那句「按当前任务排序」的,就是下面这套本地算法。 产品要回答的问题在开头那一屏,这里回答的是「它凭什么排得准」。
没有玄学,就是字符串运算。三步:
1. 读当前会话。 取最近 6 条用户 / 助手消息,只认真人输入的用户消息
(agent.inject() 塞进来的合成上下文不算,那会把话题带偏)。越新的消息权重越高:3 / 2 / 1 / 1 …
2. 抽关键词。
- 英文词:取值很高,出现 1 次就要(
chokidar、mtime这种精确词) - 中文 2/3-gram:出现 2 次,或出现在最新那条消息里
- 丢掉跨词边界的碎片:中文没有词边界,n-gram 会把相邻两个词的字粘起来 (「图片和」「个插」「的排」)。这类碎片有个共同特征 —— 首字或尾字是纯虚词, 一律丢掉。不丢的话它们会占满候选位,把「图片」「排序」这些真词全挤出去
- 虚词表过滤 + 贪心去重叠(选了「相关性排序」就不再算「相关性」和「排序」)
3. 给文档打分 —— BM25。
每个词先算 IDF:在语料里越罕见越值钱   ln(1 + (N - df + 0.5) / (df + 0.5))
再按字段加权求和:标题 ×4  +  摘要 ×2  +  正文 ×1
每个字段都按 BM25 饱和 + 长度归一化(k1 = 1.2,b = 0.3 / 0.5 / 0.75)
再叠 10% 的时间新鲜度微调(主排序仍是相关性)
为什么是 BM25 而不是「命中次数 × 权重」(那是最初的做法,已换掉):
- 没有 IDF 时,语料里到处都是的词(比如项目名)和罕见词一样值钱, 于是高频词不产生任何区分度,还稀释掉罕见词的分辨力
- 没有长度归一化时,长文档靠堆词就能赢
- 命中次数封顶 6 次是个手写硬拐点;
k1/b才是为这件事设计的
实测(test/eval/fixture.mjs,21 个用例,两版引擎跑同一套语料):
| top-1 命中 | MRR | |
|---|---|---|
| 旧做法(加权命中) | 76.2% | 0.830 |
| BM25 | 95.2% | 0.976 |
这套评测在 npm test 里跑,基线由 test/eval/legacy.mjs 冻结的旧引擎现算,
所以「新引擎必须显著更好」是自动验证的,而不是引用一个写死的数字。
跟「自己数关键词」比(knit/tools/scale-benchmark.mjs,N = 20/60/180/540):
语料刻意做成有真实陷阱的 —— 12 篇短而聚焦的主题文档,加上一堆「每条主题各提 5 次、
但哪一件都没讲」的长干扰文档(真实项目里的 CHANGELOG 就长这样)。
主题文档一半用描述性文件名,一半看不出内容。
| 路线 | 文件名说得清 | 文件名看不出 | MRR 随规模 |
|---|---|---|---|
| Knit(BM25) | 100% | 100% | 1.000(不随规模变) |
自己 grep -c 数关键词 | 17% | 0% | 0.313 → 0.089 |
| 只看文件名 | 100% | 0% | 0.602 |
三件事:排序强于自己数关键词(所以让 agent 重算是不理性的); 文件名匹配只在名字描述内容时好使,Knit 是唯一两种都 100% 的; 自己数的可靠性随规模单调下降。
关于那行「按「xxx」排序」:显示的是命中词在原文里覆盖的那一段,不是词表里的碎片。
中文没有词边界,候选里必然有跨词的碎片(「项目文档」会切出 项目文 / 目文档),
直接显示就成了乱码 —— 把它们的区间合并再切原文,正好还原出 项目文档。
标签是你自己打的字,所以大小写原样保留(打 BM25 就显示 BM25)。
全是字符串运算 —— 没有 embedding,没有模型调用。
并且老实说边界:
- 对话只有一两句时关键词太少,它会退回按修改时间排,并在面板上说明这一点 —— 不假装排了个序
- 语料只有三五篇时 IDF 几乎不起作用:
df的取值范围太窄,动态范围被压扁。 文档越多这个排序越准 —— 这正是它该有的样子 - 它只能排「和对话有共同词汇」的文档:如果一个词都没命中,所有文档同分, 名次就退化成按时间排
它读什么,不读什么
- 扫描当前会话工作区内的
.md、第一批代码后缀(见上文「代码上下文」)、图片与视频 (路径越出工作区一律拒绝);媒体只取元信息,不读画面内容;代码只读前 8 KB 进语料 - 只读当前会话的对话事件(用来排序)
knit_docs工具只读:不写任何文件、不落盘任何索引- v0.15 的「使用情况」默认关:打开后也只读当前会话已有的工具事件(成功的
read), 同样不写任何文件、不落盘任何计数,重启即失 - 不发起任何对外网络请求:客户端的
fetch都指向插件自己的同源路由 - 没有安装期脚本(无
install/postinstall) - 零依赖 —— 装完不需要构建授权,也没有构建步骤
- 按路径读文件的接口只放行图片 / 视频扩展名白名单(图片 ≤ 12MB、视频 ≤ 256MB),
视频走 HTTP Range 按需取字节,响应带
nosniff与default-src 'none'; sandbox
面板里那份「相关度」只影响排序,不显示也不外传。
上面每一条都有自动化检查守着,逐条列在 SECURITY.md 里 —— 每条属性都指向一个真实存在的测试。
npm test会校验那张表本身没腐烂。
已知限制
- 对话太短时排序会退化:只有一两句时关键词不足,退回按修改时间,并在面板上说明
- 中文分词是 n-gram 近似:没有引入分词库(那会带来依赖)。跨词边界的碎片已经按 「首尾是虚词」丢掉、并按原文区间合并还原成真词,但仍可能有孤立碎片 (比如「视频上」这种没有重叠伙伴的)出现在「按「xxx」排序」那行里 —— 匹配不上任何文档的碎片不参与打分
- 语料太少时 IDF 作用有限:只有三五篇文档时,
df的取值范围被压扁, 排序更接近按命中次数排;文档越多越准 - 右侧栏默认页会变成 guide:DSH 的规则是「guide 入口只有一个才直接开那一页」, 内置 Files 占了一个,所以展开右侧栏先看到 guide,需要点一下胶囊
- 媒体只认常见格式与大小:图片
png/jpg/jpeg/gif/webp/avif/bmp/ico/svg、 视频mp4/m4v/webm/mov/ogv;图片 ≤ 12MB、视频 ≤ 256MB,超出不列出 - 媒体只按文件名参与相关性匹配:不解析画面 / 语音内容,截图与录屏建议用可检索的文件名
- 分层建立在召回之上:如果 BM25 一篇都没把对的那篇捞进候选池,分层也只能在捞到的那几篇里分 —— 它救不了召回。词面错配(你问「图片和视频」,文档里写的是「媒体浏览」)就是这种情形
- 「当前任务上下文」覆盖文档与代码(v0.19,v0.14 起只覆盖文档):面板的媒体档、以及时间序模式都不分层 (那一档没有话题命中,就没有可解释的理由)。仍不解析 PDF / DOCX,也不支持第一批范围外的源码语言
- 代码只做词面检索,不做代码理解:没有 AST、没有符号表、没有调用图、没有 LSP、不跳转定义。
文件名与路径是这一版最强的两个信号 —— 文件名起得含糊的文件(
utils.js、index.ts)本来就难排上来 - 代码候选上限 300、正文只取前 8 KB:超大仓库里这两条会生效,生效时面板头部的计数会显示被截断
- 引用关系只当上下文信号:它能把文档放进辅助 / 相关层,不会把任何文档抬进主要上下文
- 测到的是「定位」,不是「省力」:真机对照实验(冻结协议,四道题)里,能调
knit_docs的 agent 总探索次数没有下降 —— Control 4.75 → Treatment 6.0,四题逐题无一变少。 包确实替掉了「先glob找候选」那一步,但省下的被翻倍的read吃了回去: 它把注意力指向了正确的文件,不等于 agent 少读几次文件 - 右侧栏状态是 memory-only:刷新或新会话会回到收起状态
反馈
这个项目当前的重心不是加功能,是搞清楚「按对话给文档排序」这件事到底有没有人在用。 所以最有价值的一句话不是「能不能加个 XX」,而是你现在是怎么绕过它的 —— 哪怕结论是「装了,但一周没打开过」,也请直说,那比一个功能建议有用得多。
- 💬 说说你在什么场景下会打开它 —— 两步、三十秒,不必客气
- 🐞 装不上 / 面板打不开 / 排得不对
- 📖 提之前先看一眼已知限制 —— 短对话退化、中文用 n-gram 近似,这几条是已知的取舍,不是 bug
一条 issue 会被当成真实信号处理。这个插件到现在一个真实用户的痕迹都没有 (npm 那个下载量是自动化版本枚举、不是人 ——
latest占比只有 14%,而真人只会装latest) —— 一条有人味儿的反馈能直接改变接下来做什么。
开发
git clone https://github.com/PolinniZhong/dsh-knit.git
cd dsh-knit

npm test          # 883 项,零依赖,不需要先 npm install
node tools/clean-room-test.mjs   # 发版前闸门:npm pack → 解包 → 在解包目录里再跑一遍测试
改动生效方式:宿主半边(src/host/)改了必须重启 DSH(实测不热加载);
客户端半边(src/client/)改了硬刷新浏览器即可。
没有构建步骤:客户端半边是手写的 window.__ModuleLoader__.load({...}),
用 React.createElement 而不是 JSX,所以不需要 tsdown / tsc。
静态资源也是内联的 —— 改图标要同时改 assets/ 源文件和 src/client/client.js 里的
KNIT_ICON_PATH,test/icon.test.mjs 会核对两者逐字一致。
knit/
├── package.json          # dsh.bundle.patch + dsh.client
├── cordis.patch.yml      # 挂进 plugin tree 的 insert 行
├── assets/               # 图标源文件(path 已内联进 client.js)
├── src/
│   ├── host/index.js     # /knit/api/recent · /doc · /raw · /links · /context
│   ├── host/classification.js # 文件分类层:kind / language / 能力位(纯函数,零 I/O)
│   ├── host/relevance.js # 相关性引擎:BM25 + 关键词抽取(纯函数)
│   ├── host/links.js     # 引用关系解析(纯解析,不碰排序)
│   ├── host/relations.js # 关系事实层:引用 / 导入 / 测试 / 文档(纯函数,零 I/O)
│   ├── host/passage.js   # 内容片段层:切分 / 片段打分 / 行号映射(纯函数,零 I/O)
│   ├── host/context.js   # 上下文装配:Context Pack 三层(纯函数,零 I/O)
│   ├── host/control.js   # 固定 / 排除:纯逻辑 + 可选 ctx.storage 持久化
│   ├── host/index-store.js # 增量索引持久层:per-record KV + 头部指纹 + 降级 + 遗留键清理(v0.22)
│   ├── host/semantic.js  # 可选语义候选:provider 两协议 / 有界嵌入 / 明着回退(v0.23)
│   ├── host/feedback.js  # 使用反馈:读时归因 / Context Epoch / Delta(纯逻辑,只读事件流)
│   ├── host/tool.js      # agent 文档工具 knit_docs(手写 ToolDefinition)
│   └── client/client.js  # 双宿主注册 + 面板 UI
└── test/                 # 883 项测试
    ├── eval/             # 检索质量评测:语料 + 用例 + 冻结的 v0.5.2 基线 + Deep Context 四指标
    └── context/          # 上下文分层评测:24 篇语料 + 12 条任务型用例
细节和取舍写在源码注释里;贡献流程见 CONTRIBUTING.md, 版本变更见 CHANGELOG.md。
版本策略:
0.x表示功能还在动,可能有破坏性变更。1.0.0留给「真实留存被验证之后」,不因为功能做完就发。
协议
MIT © Polinni